[논문리뷰] SCOPE: Semantic Bounded Credit Optimization for Prompt Engineering in Text-to-image Generation
링크: 논문 PDF로 바로 열기
저자: Yufei Jiao, Jinfa Huang, Zeyue Xue, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Text-to-image (T2I) Generation: 텍스트 프롬프트를 시각적 콘텐츠로 변환하는 모델.
- Prompt Engineering: T2I 모델에서 원하는 이미지를 얻기 위해 텍스트 프롬프트를 최적화하는 과정.
- Reinforcement Learning (RL): 언어 모델이 이미지 생성기의 프롬프트를 재작성하여 T2I 생성 성능을 개선하도록 훈련하는 기법.
- Credit Assignment: RL 환경에서 어떤 행동이나 토큰이 최종 보상에 기여했는지를 결정하는 과정.
- Semantic Spans: 객체, 수량, 속성, 관계 등 의미적으로 응집력 있는 구문을 형성하는 여러 서브워드 토큰의 그룹.
- Group Relative Policy Optimization (GRPO): 학습된 Critic 없이 Autoregressive Policy를 최적화하며, 각 Completion의 Advantage를 토큰에 공유하는 기법.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Text-to-image (T2I) prompt rewriting에서 발생하는 Semantic Credit Fragmentation 문제를 해결하기 위해 SCOPE를 제안한다. 기존 Reinforcement Learning (RL) 기반 프롬프트 최적화 방법론, 특히 GRPO와 같은 방식은 이미지로부터 얻는 단일 보상 신호를 개별 서브워드 토큰에 균일하게 할당하여 업데이트한다. 하지만 객체, 속성, 수량, 공간 관계 등 복합적인 compositional edits는 여러 서브워드 토큰에 걸쳐 일관된 Semantic Spans를 형성한다. 이러한 균일한 토큰 레벨 업데이트는 일관된 compositional edits를 임의의 서브워드 경계에 따라 분할하며, 이로 인해 정확한 Credit Assignment가 어렵다. 또한, Dense한 Per-span Rewards를 추정하는 것은 prohibitive한 Rendering Overhead를 발생시킨다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Semantic Bounded Credit Optimization for Prompt Engineering (SCOPE)를 제안하며, 이는 GRPO와 호환되는 objective function으로, Semantic Spans에 걸쳐 토큰 업데이트를 조절한다. SCOPE의 Rewriter는 향상된 프롬프트와 함께 해당 프롬프트의 Semantic Partition을 공동으로 생성한다. SCOPE는 각 Span 내에서 현재 Policy와 이전 Policy 간의 Log-probability shifts를 Pooling하여 Detached Coefficient를 도출하고, 이 Coefficient는 Clipped GRPO Surrogate 내에서 Shared Advantage의 각 토큰 Loss에 대한 기여도를 재조정한다 [Figure 1, 2]. 이 방법은 Per-span Rewards 또는 추가적인 Image Renders 없이 기존 Rendering 및 Reward Pipeline을 활용하며, 모든 Valid Token에 대한 Loss와 각 Completion에 대한 단일 Advantage를 유지한다.
SCOPE는 Qwen-Image, SD3, FLUX.1-dev의 세 가지 Frozen T2I Backbones에 걸쳐 Vanilla GRPO 대비 일관된 성능 향상을 달성했다. GenEval 벤치마크에서 SCOPE는 GRPO 대비 평균 9.48%의 상대적 성능 향상을 보였으며, 특히 SD3에서는 Counting에서 0.58에서 0.79로 (36.2% 상대적 향상), Position에서 0.57에서 0.83으로 (45.6% 상대적 향상) 크게 개선되었다. T2I-CompBench에서는 Qwen-Image에서 Overall 점수를 0.6247에서 0.6665로 끌어올려 6.7%의 평균 상대적 향상을 기록했다. Ablation Study 결과, Semantic Boundaries 내에서 Policy shifts를 Pooling하는 것이 개별 토큰에 가중치를 부여하는 것보다 성능에 기여하며, Random Boundaries나 Fixed Windows보다 Semantic Boundaries가 더 효과적임을 입증했다 [Figure 3].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 RL 기반 프롬프트 엔지니어링을 위한 Semantic-aware Credit Optimization Framework인 SCOPE를 제안한다. SCOPE는 Semantic Spans 내에서 Policy Log-probability shifts를 Pooling하여 Subword Credit Fragmentation을 해결하며, 추가적인 Span Rewards나 Image Renders 없이 높은 효율성을 유지한다. 이 연구는 Frozen Text-to-image Generators의 Compositional Potential을 해제하는 데 있어 Structure-aligned Credit Assignment가 효과적인 Plug-and-play Paradigm이 될 수 있음을 시사한다. SCOPE는 T2I 생성 모델이 복잡한 Compositional Prompts에 대한 이해와 Fidelity를 크게 향상시키는 데 기여하며, 학계와 산업계 모두에서 더욱 정확하고 제어 가능한 이미지 생성을 가능하게 할 것으로 기대된다.
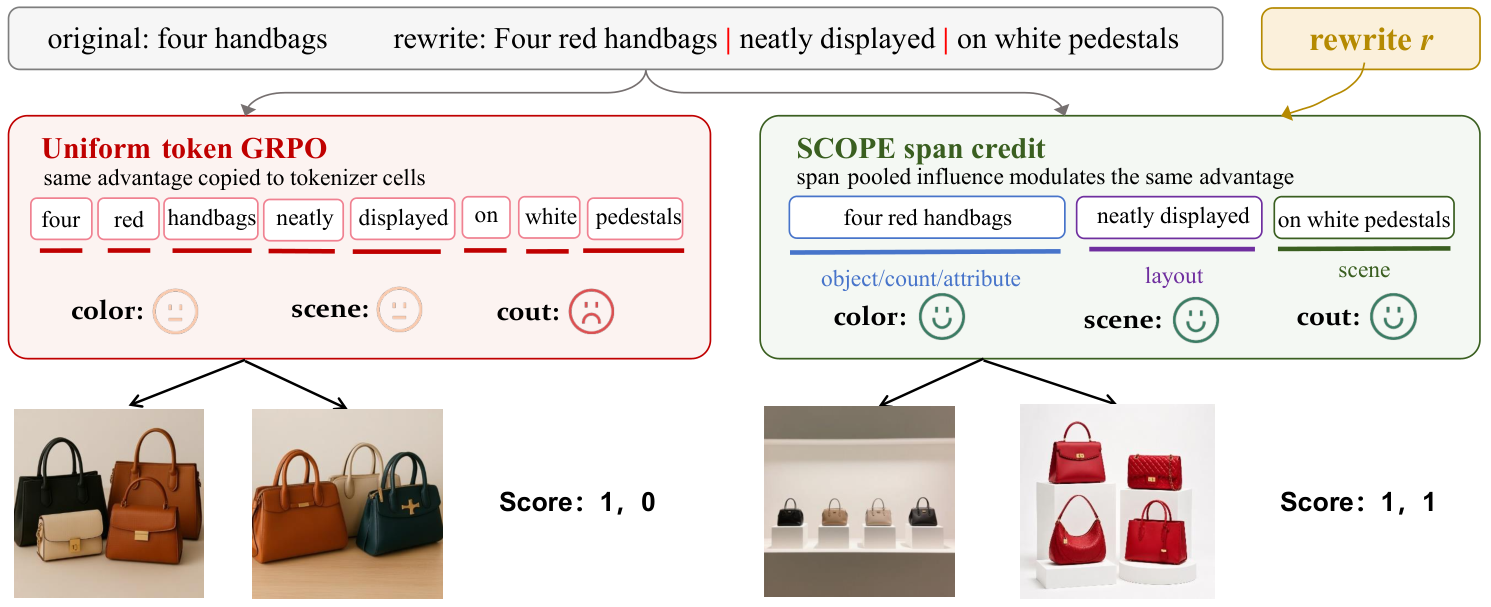
Figure 1 — SCOPE와 GRPO 비교
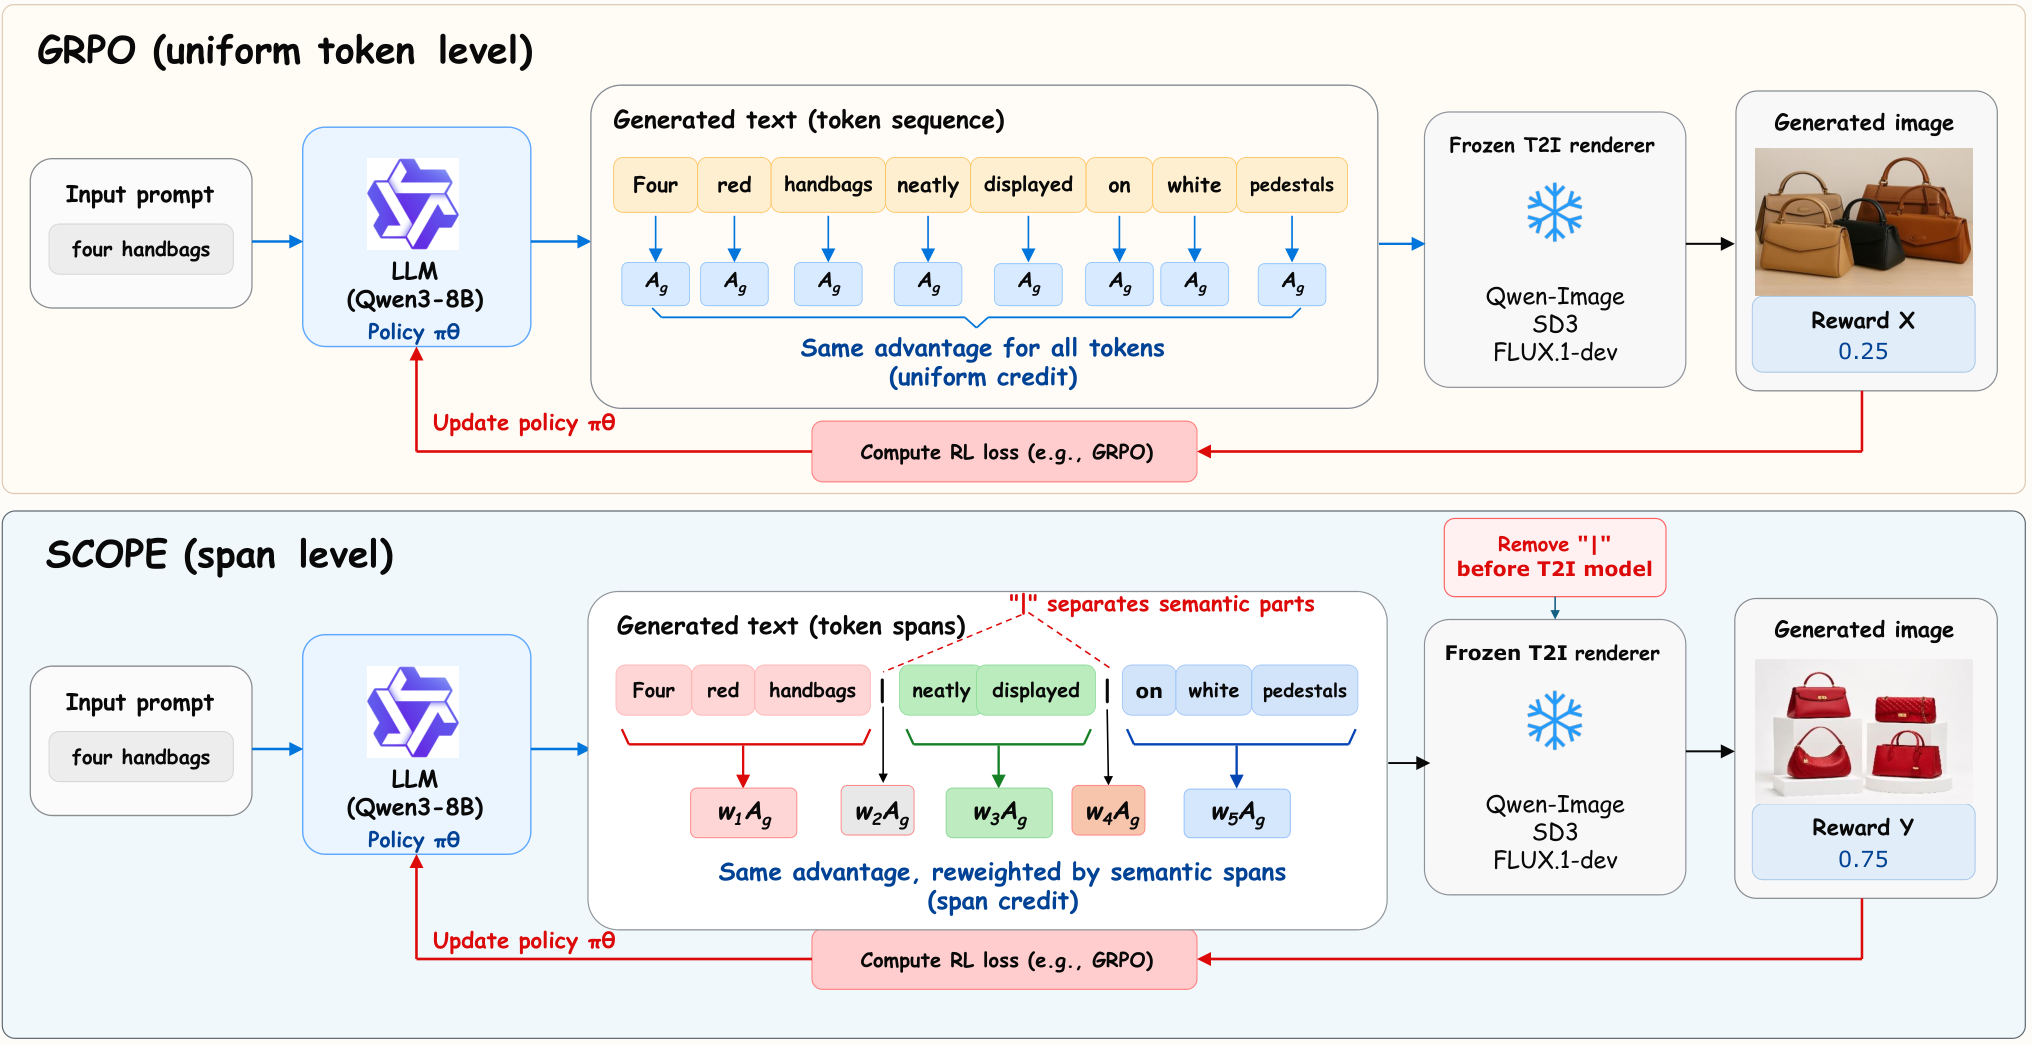
Figure 2 — SCOPE 파이프라인 개요
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] FIPO: Eliciting Deep Reasoning with Future-KL Influenced Policy Optimization
- [논문리뷰] The Thinking Leakage in Reinforcement Learning for LLMs
- [논문리뷰] Semifactual Credit-Augmented Policy Optimization
- [논문리뷰] Make Sparse Rewards Count: Density-Aware Reward Aggregation for Multi-Reward RL
- [논문리뷰] Rubric-to-Code Credit Assignment for Reinforcement Learning
Review 의 다른글
- 이전글 [논문리뷰] RoTA-Bench: Evaluating 3D Spatial Reasoning through Interactive Projection Alignment
- 현재글 : [논문리뷰] SCOPE: Semantic Bounded Credit Optimization for Prompt Engineering in Text-to-image Generation
- 다음글 [논문리뷰] SWE-at-Scale: Scalable Issue Synthesis from Historical Bug Fixes
댓글