[논문리뷰] SWE-at-Scale: Scalable Issue Synthesis from Historical Bug Fixes
링크: 논문 PDF로 바로 열기
저자: Silin Chen, Zihan Zhang, Xiaodong Gu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- SWE tasks (Software Engineering tasks): 코딩 Agent가 repository를 수정하고, context를 보존하며, observable한 behavioral bug를 도입하고, 의미 있는 issue description을 제공해야 하는 코딩 문제.
- HPR (Human Preference Rate): 합성된 이슈-패치 쌍이 실제 소프트웨어 개발에서 발생할 가능성이 있다고 인간 평가자가 판단하는 비율로, 태스크의 realism을 측정하는 지표.
- Usability Rate: 생성된 태스크 인스턴스 중 실행 및 품질 필터를 통과하여 사용 가능한 비율.
- Pass@1: 다운스트림 이슈 해결 성공률로, 태스크의 difficulty를 측정하는 지표 (낮을수록 어려움).
- MBTE (Mean Bug Type Entropy): 단일 파일에서 생성될 수 있는 버그 타입의 다양성을 정량화하는 지표.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
코딩 Agent의 역량이 향상됨에 따라, 더 광범위하고 diverse하며 verifiable한 SWE tasks의 공급이 필수적입니다. 기존 real-world SWE benchmarks는 자연적인 이슈 리포트 빈도와 수동 큐레이션 비용 때문에 scalability에 한계가 있습니다. 기존 synthetic task 생성 접근 방식인 SWE-smith, SWE-Synth, BugPilot 등은 주로 LLM의 사전 학습된 지식과 휴리스틱 프롬프팅에 의존하여, 실제 소프트웨어 failure의 복잡한 메커니즘을 포착하지 못하고 synthesized tasks의 diversity를 확장하는 데 제한적입니다. 이러한 한계는 특정 bug patterns에만 반복적으로 집중하게 만들어 새로운 bug types를 지속적으로 탐색하는 데 어려움을 겪습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 real-world software fixes를 reverse-engineering하여 scalable한 SWE tasks를 자동으로 synthesize하는 프레임워크인 SWE-at-Scale을 제안합니다 [Figure 2]. SWE-at-Scale의 핵심 아이디어는 historical fix가 bug formation에 대한 깊은 mechanistic knowledge를 캡슐화하고 있으며, fix를 반전시키는 것이 repair supervision을 실제 개발 시나리오에 기반한 bug-induction supervision으로 전환한다는 것입니다. 이 프레임워크는 Qwen3.5-9B 모델을 backbone으로 사용하여 학습하며, 13,407개의 real-fix transformation으로 구성된 대규모 데이터셋을 활용합니다.
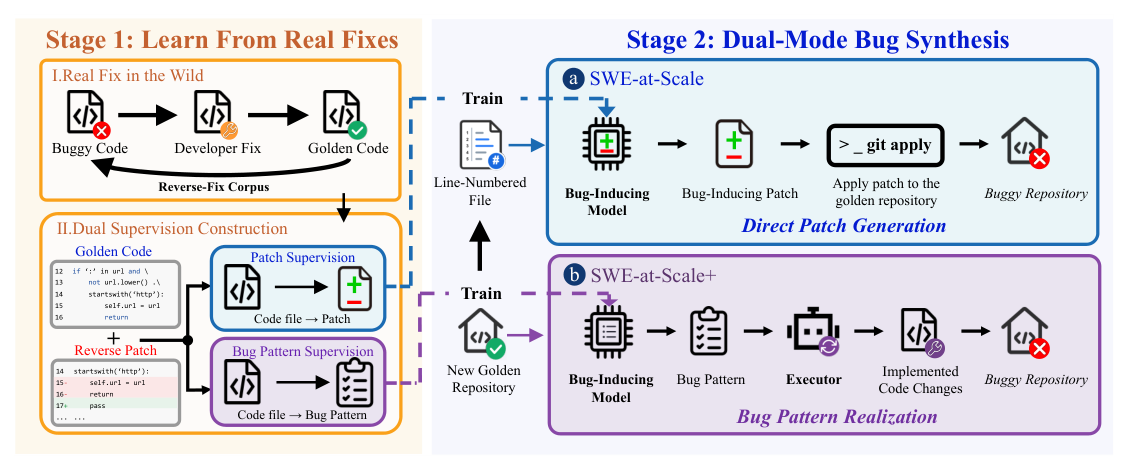
Figure 2 — 제안하는 SWE-at-Scale 프레임워크의 전체 아키텍처 및 방법론을 설명하는 다이어그램
SWE-at-Scale은 bug-inducing patch를 직접 생성하는 반면, **SWE-at-Scale+**는 DeepSeek-V4-Flash-0731를 expert teacher로 활용하여 natural-language bug patterns을 명시적으로 학습한 후 이를 코드에 구현합니다. 실험 결과, SWE-at-Scale은 기존 synthesis methods보다 더 diverse하고 realistic한 SWE tasks를 생성하며, state-of-the-art 코딩 Agent에게 더 큰 challenge를 제시했습니다. Human Preference Rate (HPR) 측면에서 SWE-at-Scale은 55.9%, **SWE-at-Scale+**는 61.2%로, real-world 개발에서 더 realistic하다고 평가받았습니다. Usability Rate에서는 **SWE-at-Scale+**가 94.0%, SWE-at-Scale이 72.6%를 달성하여 기존 synthetic baselines보다 우수했습니다.
또한, SWE-at-Scale은 Pass@1 성능에서 31.68%-48.48%, **SWE-at-Scale+**는 16.81%-37.02%를 기록하여, real-world SWE-bench Verified 및 기존 synthetic baseline보다 낮은 Pass@1 점수를 보여 tasks의 difficulty가 더 높음을 입증했습니다 [Table 1]. Bug diversity 측면에서, SWE-at-Scale은 SWE-bench Verified에 비해 더 균형 잡힌 bug type distribution을 제공하며 [Figure 1], Mean Bug Type Entropy (MBTE)는 sampling budget이 200 generations per file까지 증가하더라도 0.583 bits에서 2.063 bits로 꾸준히 증가하여 높은 diversity scalability를 보여주었습니다 [Figure 8].
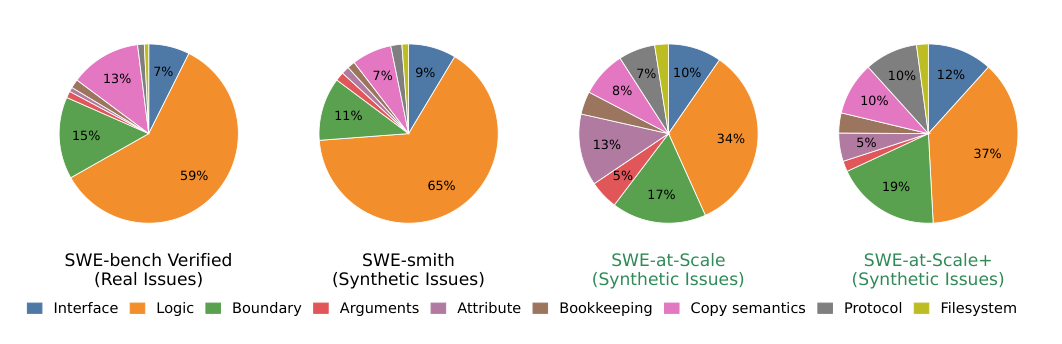
Figure 1 — SWE-at-Scale이 생성하는 버그 타입의 다양성과 분포를 보여주는 핵심 결과 다이어그램
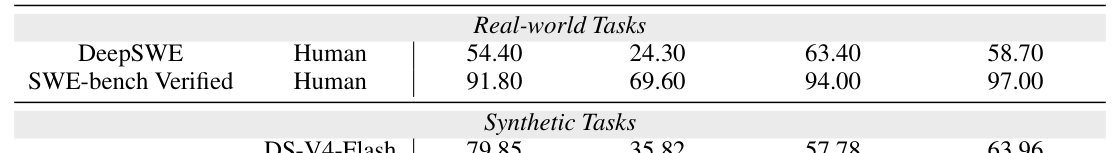
Table 1 — SWE-at-Scale의 다운스트림 이슈 해결 성능을 다른 Baseline 및 Real-world 태스크와 비교하는 핵심 결과 테이블
4. Conclusion & Impact (결론 및 시사점)
본 연구는 real-world bug fixes를 reverse-engineering하여 scalable하고 realistic하며 diverse한 SWE tasks를 생성하는 SWE-at-Scale 프레임워크를 성공적으로 제시했습니다. 이 방법론은 단순히 LLM의 pre-trained 지식에 의존하는 것이 아니라, 실제 개발에서 관찰되는 bug patterns을 학습하여 새로운 코드 context에 적용할 수 있는 재사용 가능한 bug-inducing distribution을 만듭니다. 이는 finite한 real-world fix를 scalable한 SWE tasks 생성을 위한 reusable supervision으로 전환하여, 코딩 Agent 평가를 위한 보다 challenging하고 풍부한 데이터셋을 제공하는 데 크게 기여할 것입니다. 향후 연구는 Python 외 다른 프로그래밍 언어로의 확장 가능성과 약한 테스트 커버리지를 가진 repository에서의 task 생성 역량을 탐구할 수 있습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] CARD: Cluster-level Adaptation with Reward-guided Decoding for Personalized Text Generation
- [논문리뷰] Towards a Neural Debugger for Python
- [논문리뷰] MiniAppBench: Evaluating the Shift from Text to Interactive HTML Responses in LLM-Powered Assistants
- [논문리뷰] Qwen3-Coder-Next Technical Report
- [논문리뷰] Learning beyond Teacher: Generalized On-Policy Distillation with Reward Extrapolation
Review 의 다른글
- 이전글 [논문리뷰] SCOPE: Semantic Bounded Credit Optimization for Prompt Engineering in Text-to-image Generation
- 현재글 : [논문리뷰] SWE-at-Scale: Scalable Issue Synthesis from Historical Bug Fixes
- 다음글 [논문리뷰] Self-Evolving Agent Harness
댓글