[논문리뷰] Self-Evolving Agent Harness
링크: 논문 PDF로 바로 열기
저자: Chuyang Wei, Haoxiang Guan, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문은 Self-evolving Agent Harness의 핵심 개념을 명확히 정의한다.
- Harness: 모델(Model)의 태스크 환경(Task Environment) 내 실행을 제어하는 소프트웨어 및 구성 요소(configuration)를 의미한다. 여기에는 프롬프트(prompts), 메모리(memory), 워크플로우(workflows), 실행 가능한 컴포넌트(executable components) 등이 포함된다.
- Harness Self-Evolution: 모델 웨이트(model weights)를 고정한 채 실행 피드백(execution feedback)을 활용하여 Harness를 반복적으로 수정(revise)하는 과정으로, 태스크 성능(task performance) 또는 리소스 효율성(resource efficiency) 향상을 목표로 한다.
- Harness RSI: Harness Self-Evolution을 포함하는 연구 분야를 지칭하며, 모든 수정(revision)이 반드시 개선(improvement)으로 이어지는 것은 아니라는 점을 강조한다.
- Interpreted-state Updates: 미리 정의된 기능(predefined capabilities)에 대한 지침(instructions), 저장된 경험(stored experience) 또는 태스크 수준 조정(task-level coordination)을 수정하는 업데이트를 말한다.
- Executable Revisions: 기능 구현(capability implementations), 런타임 제어 로직(runtime control logic) 또는 플러그인 기반 서비스 구성(plugin-based service composition)을 변경하는 수정을 지칭한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 에이전트(agents)가 배포(deployment) 이후 변화하는 태스크(tasks)와 환경에 지속적으로 적응(adaptation)해야 하는 근본적인 문제를 해결하고자 한다. 기존의 에이전트 적응 메커니즘은 주로 모델 웨이트를 수정하는 데 초점을 맞추었으며, 이는 비용이 많이 들고(costly), 독점적인 API(proprietary APIs)에 대한 접근이 필요하며, 행동 변화의 원인(behavioral attribution)을 파악하기 어렵다는 한계점을 가진다. 이러한 문제점은 모델 재학습(retraining) 없이도 에이전트의 동작을 유연하게 수정할 수 있는 새로운 접근 방식의 필요성을 제기한다. 저자들은 Harness Self-Evolution이 기존 모델 배포(existing model deployment)를 재사용하여 적응 및 유지보수 비용을 절감하고, 프로프라이어터리 API를 통한 업데이트를 가능하게 하며, 지침, 메모리 기록, 코드 등을 직접 검사하고 버전 비교(version comparison) 및 변경 추적(change tracking)을 지원함으로써 투명성을 높일 수 있다고 강조한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 에이전트의 Harness Self-Evolution을 위한 피드백 기반 프로세스(feedback-driven process)를 공식화하고, 업데이트 대상을 제안 및 승인 메커니즘(proposal and admission mechanisms)과 분리하여 설명한다. 제안 방법론은 업데이트 대상을 크게 세 가지 유형으로 분류한다: Tools and Code Patches, Repository and Runtime Logic, 그리고 Everything Is a Plugin. 이론적 분석에서는 Harness search를 진화적 구조(evolutionary structures)에 매핑하고, 클래식한 안정성(stability) 및 집중(concentration) 결과로부터 기대 일반화 바운드(expected generalization bound), 이력 회귀 예산(historical regression budgets)에 따른 유지 바운드(retention bound), 그리고 새로운 독립적인 검증 데이터(fresh, independent validation data)를 사용하는 고확률 승인 규칙(high-probability admission rule)에 대한 조건을 도출한다. [Figure 1]은 재사용 가능한 지침에서 수정 가능한 실행 컴포넌트로의 진화를 개념적으로 보여준다.
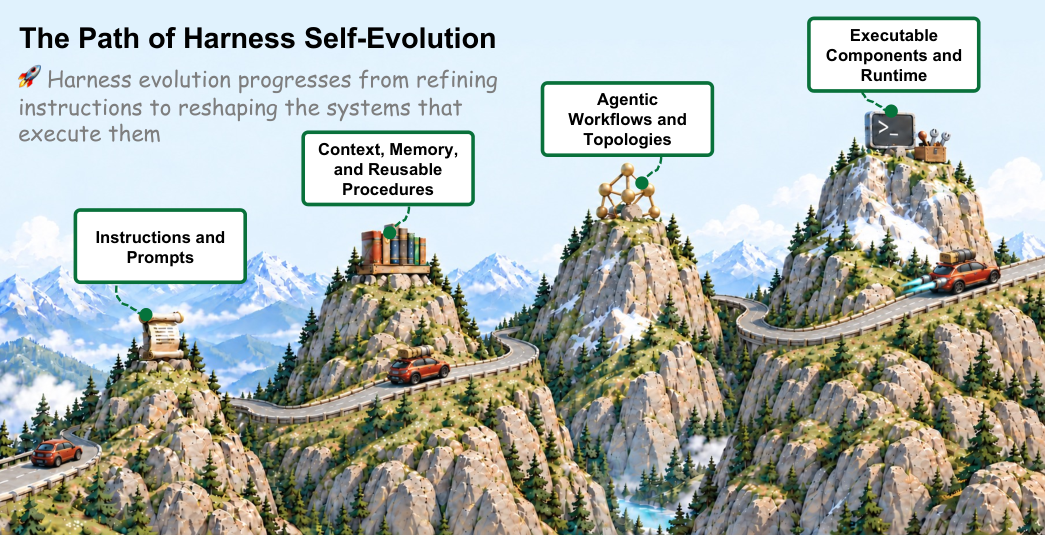
Figure 1 — 제안 모델의 개념도
주요 실험 결과는 다음과 같다:
- HarnessOpt 방법론은 SpreadsheetBench에서 런타임 수정(runtime revision)을 통해 상당한 성능 개선을 입증했다. 특히, GPT-5.4-nano 모델에 HarnessOpt와 skill을 적용했을 때 77.58%의 정확도(accuracy)를 달성하여, skill만 사용한 GPT-5.5의 76.20%를 상회했다. 전반적으로 네 가지 모델에서 HarnessOpt와 skill 조합은 SkillOpt-Lite 대비 5.69%에서 11.39% 포인트의 성능 향상을 보였다.
- Everything Is a Plugin (EIP) 아키텍처를 구현한 DSH Everything과 Codex 플러그인을 활용한 실험에서는 에이전트가 실행 중에 도구(tools)를 생성하고 후속 태스크(subsequent tasks)를 위해 유지할 수 있음을 보여주었다. 시뮬레이션된 사무실 워크로드(simulated office workload)에서 첫 번째 태스크의 도구 호출(tool calls)은 13회에서 3회로 감소했지만, Wall time은 54.9%, 토큰(tokens) 사용량은 15.7% 증가했다. 그러나 누적 결과(cumulative results)에서는 두 번째 태스크부터 상당한 절감 효과가 나타나, 다섯 번째 태스크 이후에는 총 110,351 토큰과 22.97초의 시간 절약을 달성했다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Harness Self-Evolution의 정의, 운영 분류법(operational taxonomy), 조건부 이론 분석(conditional theoretical analysis), 시스템적 함의(systems implications)를 포괄적으로 제시한다. 이 연구는 에이전트가 모델 웨이트를 고정한 상태에서 프롬프트, 메모리, 워크플로우, 실행 컴포넌트 등 소프트웨어 스캐폴딩(software scaffolding)을 자율적으로 수정하며 적응할 수 있는 피드백 기반 프레임워크를 제공한다. 이러한 접근 방식은 지속적인 적응이 필수적인 환경에서 에이전트 시스템의 신뢰성(reliability), 유지보수성(maintainability), 그리고 투명성(transparency)을 향상시키는 데 기여한다. 결과적으로, 이 연구는 학계 및 산업계에서 변화하는 요구사항에 맞춰 AI 에이전트를 진화시키는 데 중요한 지침을 제공하며, 특히 과학적 신뢰성(scientific reliability), 물리적 안전(physical safety), 기관 책임(institutional accountability)과 같은 중요한 영역에서 에이전트 시스템의 책임감 있는 배포와 발전을 위한 기반을 마련한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] OneSearch-VL: Unified Multimodal Deep Research Agent for Image and Video
- [논문리뷰] Embodied Turing Machines: Stateful Code for Robot Recursive Self-Improvement
- [논문리뷰] PluginRSI: Recursive Improvement of Agent Harnesses with Reusable Plugins
- [논문리뷰] RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
- [논문리뷰] SAEScientist-Bench: Can AI Agents Conduct Autonomous SAE Interpretability Research?
Review 의 다른글
- 이전글 [논문리뷰] SWE-at-Scale: Scalable Issue Synthesis from Historical Bug Fixes
- 현재글 : [논문리뷰] Self-Evolving Agent Harness
- 다음글 [논문리뷰] Speculative Forcing for Efficient Autoregressive Video Generation
댓글