[논문리뷰] Harness^2: Recursive Agent Harnessing for an Open World
링크: 논문 PDF로 바로 열기
저자: Ruiyao Xu, Yanfei Chen, Zhongying CuiZhu, Bhavana Dalvi Mishra, Yifei Ming, Han Yu, Rujun Han, Chen-Yu Lee, Tomas Pfister, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Harness: LLM 모델이 태스크를 수행하는 데 사용되는 프롬프트, 메모리, 스킬, 도구 및 오케스트레이션을 총칭하는 개념입니다.
- Recursive Self-Improvement (RSI): AI 시스템이 자체적으로 지속적인 변경을 가하고, 이러한 변경이 향후 개선 사항의 생성, 평가 및 유지 방식에 영향을 미치는 능력입니다.
- Recursive Agent Harnessing: Harness^2^ 프레임워크에서 제안하는 개념으로, 현재 execution harness를 개선하는 task-level recursion과 이 개선 과정의 경험을 학습하여 improvement harness를 업데이트하는 harnessing-level recursion이라는 두 가지 재귀적 업데이트를 결합합니다.
- Task-level recursion: 현재 태스크의 execution harness를 정제하는 과정으로, ground-truth feedback 없이 Propose–Probe–Compose 스텝을 통해 이루어집니다.
- Harnessing-level recursion: Task-level recursion에서 얻은 경험을 추출하여 미래 태스크에 대한 Agent의 적응력을 향상시키는 continual improvement harness를 업데이트하는 과정입니다.
- Propose–Probe–Compose: Task-level recursion 내에서 사용되는 Contrastive improvement step으로, harness edits를 제안하고, 매칭된 조건에서 그 효과를 Probe하며, 행동적 Contrast에 의해 뒷받침되는 변경 사항을 Compose하는 방식입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
LLM Agent의 역량은 근본적인 모델뿐만 아니라 harness의 설계에 크게 의존합니다. Agent의 활용 범위가 코딩을 넘어 Office Workflow 및 법률 작업과 같은 고위험 영역으로 확장됨에 따라, 다양하고 예측 불가능한 open-world 환경에 맞춰 harness를 수동으로 설계하고 개선하는 것은 막대한 Engineering Effort를 필요로 합니다. 기존의 Recursive Self-Improvement (RSI) 방법론은 주로 고정된 학습 태스크나 유닛 테스트에 대해 후보 구성 요소를 최적화하는 데 중점을 두었지만, 이러한 정적 harness는 동적인 open-world 환경에서 새로운 태스크에 대한 일반화 능력이 부족합니다. 특히, open-world harness Evolution은 두 가지 주요 도전 과제에 직면합니다. 첫째, 태스크는 일반적으로 ground-truth label이나 신뢰할 수 있는 Verifier가 부족하여 온라인 harness Edit을 안정적으로 안내하기 어렵습니다. 둘째, 한 태스크를 위해 개선된 harness가 다음 태스크의 정제 과정을 자동으로 개선하지 못하며, 태스크별 Edit은 요구 사항이 변경될 때 실패할 수 있습니다. 이러한 한계점을 해결하기 위해, 개선 프로세스 자체를 학습의 원천으로 삼아 시스템이 자체 정제 메커니즘을 재귀적으로 업그레이드할 수 있는 새로운 접근 방식이 필요합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 recursive agent harnessing을 위한 플러그 앤 플레이 프레임워크인 **Harness^2^**를 제안합니다. 이는 두 가지 연결된 수준의 recursion을 통해 현재 태스크의 execution harness를 개선하고, 그 과정에서 얻은 경험을 통해 미래의 harnessing을 개선하는 것을 목표로 합니다. Harness^2^는 task-level recursion과 harnessing-level recursion을 통해 이러한 목표를 달성합니다 [cite: 1, Figure 3].
Task-level recursion은 현재 태스크의 execution harness를 개선합니다. Ground-truth feedback이 없는 open-world 환경의 도전 과제를 해결하기 위해, 저자들은 Contrastive Propose–Probe–Compose 스텝을 도입했습니다. 이 스텝은 harness edits를 제안하고, 매칭된 조건에서 그 효과를 Probe하며, 행동적 Contrast에 의해 뒷받침되는 변경 사항을 Compose합니다. 이 스텝은 또한 다수의 후보를 동시에 탐색하는 parallel recursion 또는 연속적인 수정을 반복적으로 구축하는 sequential recursion을 통해 확장될 수 있습니다 [cite: 1, Figure 3, Figure 4]. Harness^2^는 System Prompt, Guardrails, Memory, Skills, Tool Guidance, Scripts, Subagents, Middleware Plugin의 8가지 harness components를 활용하여 Agent runtime에서 각기 다른 역할을 수행합니다 [cite: 1, Figure 2].
Harnessing-level recursion은 task-level recursion에서 얻은 경험을 사용하여 continual improvement harness를 업데이트합니다. 이는 이전 execution harness를 단순히 상속하는 대신, 재사용 가능한 구성 요소와 그것이 언제, 왜 작동했는지에 대한 Lesson을 선별적으로 유지하여 미래의 제안 및 구성을 안내합니다 [cite: 1, Figure 3]. 이 과정은 harness improvement library를 통해 이루어지며, 라이브러리는 채택된 harness와 그 개선 과정에서 얻은 Lesson을 보관하여 후속 태스크에서 재사용 및 적응할 수 있도록 합니다.
실험 결과, Harness^2^는 WorkBuddy-Bench, JobBench, Harvey’s Legal Agent Benchmark (LAB) 세 가지 전문 벤치마크와 네 가지 executor-harness 구성에서 일관된 성능 향상을 보였습니다. 단일 Propose–Probe–Compose 스텝만으로 GLM-5 및 Gemini 3.5 Flash 모델의 기본 harness 대비 성능이 향상되었으며, WorkBuddy-Bench에서 최대 11.5점, JobBench에서 4.5점, LAB의 Partial pass rate에서 11.8%p의 개선을 달성했습니다. 특히, Task-level recursion 예산(k)이 증가함에 따라 추가적인 성능 향상을 보였는데, WorkBuddy-Bench에서 2.9에서 3.9점, JobBench에서 3.0에서 4.2점, LAB의 Partial pass rate에서 2.6에서 6.7%p가 추가적으로 상승했습니다 [cite: 1, Figure 1, Figure 5]. 또한, Harnessing-level recursion의 중요성도 입증되었는데, harness improvement library가 없을 경우 성능이 저하되며, 더 큰 task-level exploration 예산으로 축적된 라이브러리는 추가적인 probing 없이도 향후 harness edits를 더 강력하게 지원함을 보여줍니다 [cite: 1, Table 3, Figure 7].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 현재의 execution harness를 정제하고, 그 정제 과정에서 미래의 harnessing을 안내하는 경험을 학습하는 recursive agent harnessing 프레임워크인 **Harness^2^**를 성공적으로 제시했습니다. 제안된 Harness^2^ 프레임워크는 task-level recursion (Contrastive improvement step 기반)과 harnessing-level recursion (개선 harness 업데이트)의 두 가지 상호 연결된 recursion 수준을 통해 작동합니다.
실험 결과는 세 가지 전문 벤치마크와 다양한 Executor 및 초기 Harness 구성에서 Harness^2^가 기존 Base Configuration 대비 일관된 성능 향상을 제공함을 입증했습니다. Ablation Study와 Transfer Study는 Scoped Proposal, Composition, 그리고 축적된 Harnessing Experience의 가치를 추가적으로 보여주었습니다. 종합적으로, 이러한 연구 결과는 Task-specific Refinement를 open-world 태스크 전반에 걸친 온라인 test-time adaptation을 위한 재사용 가능한 기반으로 전환하는 방법으로서 recursive harnessing의 중요성을 강조합니다. 이 연구는 Ground-truth Supervision이 없는 환경에서 LLM Agent의 Harness를 자동적으로 개선하는 강력한 방법을 제공하며, 이는 학계의 recursive self-improvement 및 Agent Autonomy 연구에 중요한 기여를 하고, 산업계에서는 수동적인 Harness Engineering 노력을 크게 줄여 Agent 시스템의 광범위한 배포 및 지속적인 적응 가능성을 높일 잠재력을 가집니다.
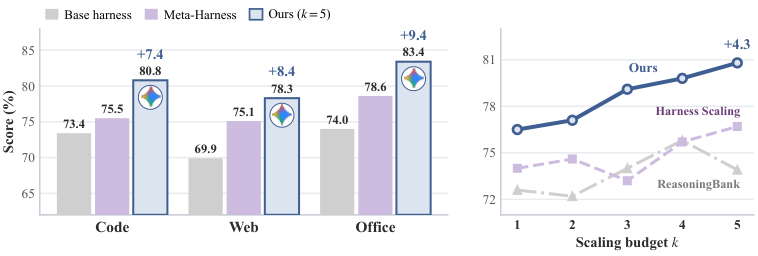
Figure 1 — 전반적인 성능 비교
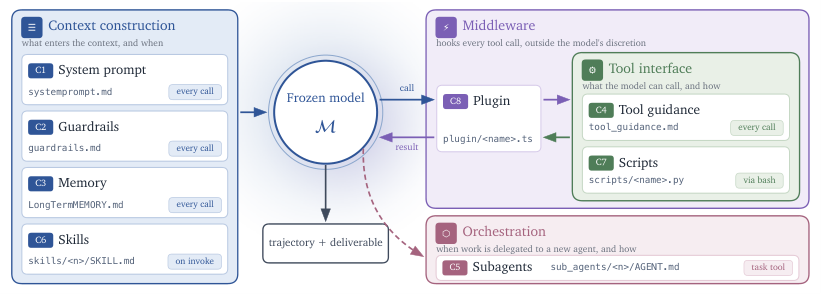
Figure 2 — Harness^2^의 8가지 구성 요소
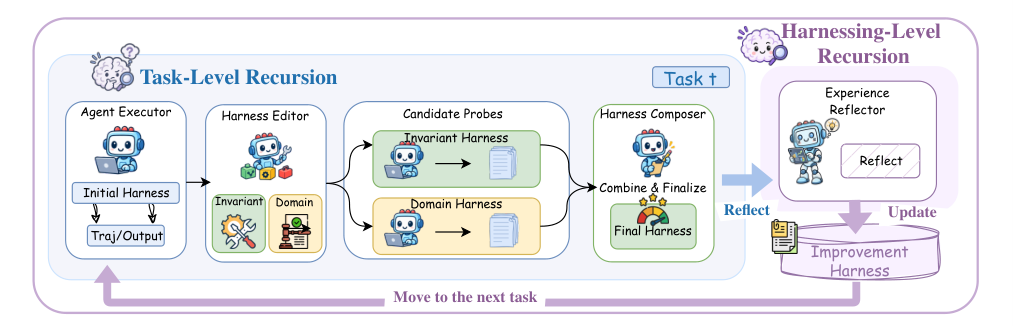
Figure 3 — Harness^2^ 파이프라인 개요
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ReSAIL: Mitigating Collapse in Iterative Agent Self-Distillation
- [논문리뷰] SKILL-KD: Contrastive Skill Distillation for LLM Agents
- [논문리뷰] Agentic Discovery of Neural Architectures: AIRA-Compose and AIRA-Design
- [논문리뷰] Externalization in LLM Agents: A Unified Review of Memory, Skills, Protocols and Harness Engineering
- [논문리뷰] AutoSFT: An Agentic System for Automated Data Research in Supervised Fine-Tuning
Review 의 다른글
- 이전글 [논문리뷰] GreenWAM: A World Foundation Model for Robotics
- 현재글 : [논문리뷰] Harness^2: Recursive Agent Harnessing for an Open World
- 다음글 [논문리뷰] JevGPT: Thinking Fast and Slow in Autonomous Research
댓글