[논문리뷰] GreenWAM: A World Foundation Model for Robotics
링크: 논문 PDF로 바로 열기
저자: Gennady Sidorov, Valerii Kornilov, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- GreenWAM: Cosmos 3 Edge를 기반으로 구축된 로봇공학용 World Foundation Model로, World Model 및 Policy 두 가지 역할을 모두 수행한다.
- Shared Anatomical Action Space: 20가지 로봇 패밀리(bimanual arms부터 dexterous humanoids까지)의 Joints를 Legs, Torso, Arms, Finger Joints의 Shared Slots에 매핑하는 표준화된 Joint Coordinates 시스템이다.
- WorldArena 1.0: 로봇의 Actions에 Conditioned된 Video Prediction의 품질을 평가하는 공개 벤치마크이다.
- RoboTwin 2.0: Bimanual Robot Manipulation Tasks의 Policy Success Rate를 평가하는 리더보드 벤치마크이다.
- Rectified Flow Objective: Noised Target Streams의 Velocity를 예측하는 데 사용되는 Training Objective로, GreenWAM의 Multi-modal Training에 활용된다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 단일 로봇 World Model이 다양한 로봇 Body에 걸쳐 World Model 및 Policy 두 가지 역할을 모두 수행할 수 있는지, 그리고 이를 가능하게 하는 요인이 무엇인지에 대한 핵심 질문을 다룬다. 기존 로봇 시스템은 World Model을 Prediction 전용 또는 Policy 생성 전용으로 구축 및 평가하며, 각 로봇은 자체적인 형식으로 Actions를 기록하여 데이터의 Fragmentation이 심각하다. 특히, Cosmos 3 Edge와 같은 기존 모델은 End-effector Pose Deltas와 Gripper Opening만을 사용하여 Actions를 coarsely 학습했고, 각 Embodiment Domain에 대한 개별적인 Projection을 필요로 하여 Generalization에 한계가 있었다. 이러한 한계는 Shared Interface를 통한 광범위한 로봇 Family에 대한 통합된 모델 학습과 Policy 적용을 어렵게 만든다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 기존 Cosmos 3 Edge 모델을 기반으로 GreenWAM이라는 World Foundation Model을 제안하며, 이를 구축하기 위한 세 가지 핵심 Recipe를 소개한다. 첫째, Shared Anatomical Action Space를 도입하여 20가지 로봇 Family(bimanual arms부터 dexterous humanoids까지)의 Bodies를 공통 Joint Coordinates(79-Slot System)로 통합한다 [Figure 1]. 둘째, 이 로봇 Family들에 대해 Visual, Action-conditioned, World-action Modes에서 Joint Training을 수행한다. 셋째, Policy를 위해 Generator로부터 Action Expert를 분리하여 사용한다.
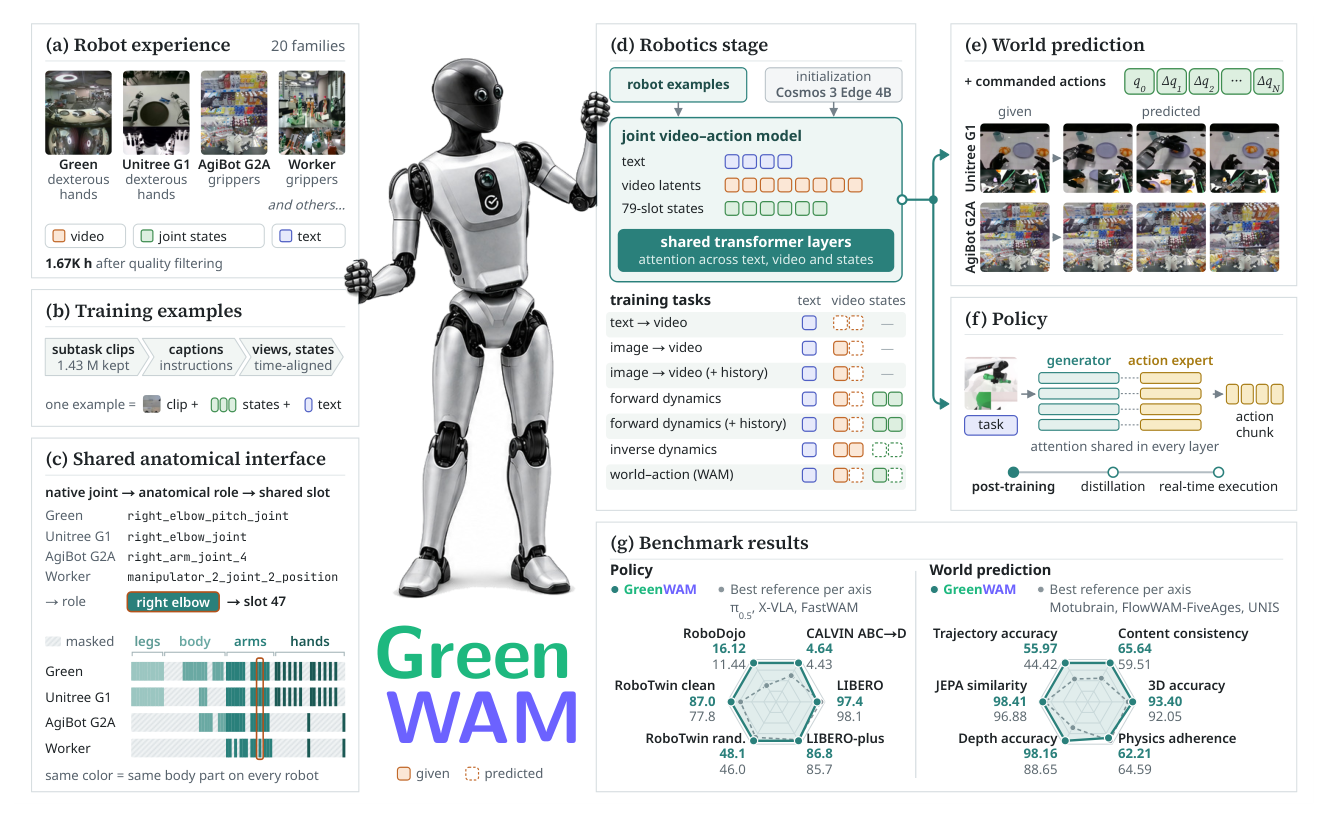
Figure 1 — GreenWAM의 전체 아키텍처, 학습 방식, World Prediction 및 Policy 역할, 그리고 핵심 벤치마크 결과를 요약하여 보여주는 다이어그램
GreenWAM은 World Model로서 WorldArena 1.0 벤치마크에서 Top-tier 성능을 달성하여 Trajectory, Depth, 3D Accuracy에서 비교 대상 World-action Model 및 Video Generator를 능가한다 [Figure 9]. 구체적으로, Trajectory Accuracy 56.0, Depth Accuracy 98.2, 3D Accuracy 93.4를 기록했다. Policy로서 RoboTwin 2.0 리더보드에서 상위권에 속하며, Clean Scene에서 86.98%, Randomized Scene에서 48.10%의 성공률을 보인다 [Table 3]. 또한, LIBERO-plus에서 가장 높은 Zero-shot Success를 달성하고 CALVIN 및 LIBERO 벤치마크에서도 경쟁력 있는 성능을 보여준다 [Table 12, Table 14]. 실제 Humanoid에서는 In-distribution Instructions의 95.6%를 성공하여 Cosmos 3 Edge (88.9%) 및 π0.5 (84.4%)에서 Adapt된 Policy보다 우수하다 [Figure 17]. 실시간 제어를 위한 Distilled Single-step Policy는 Unoptimized Policy보다 12.3배 빠른 35.4ms의 응답 시간을 기록한다 [Figure 15].
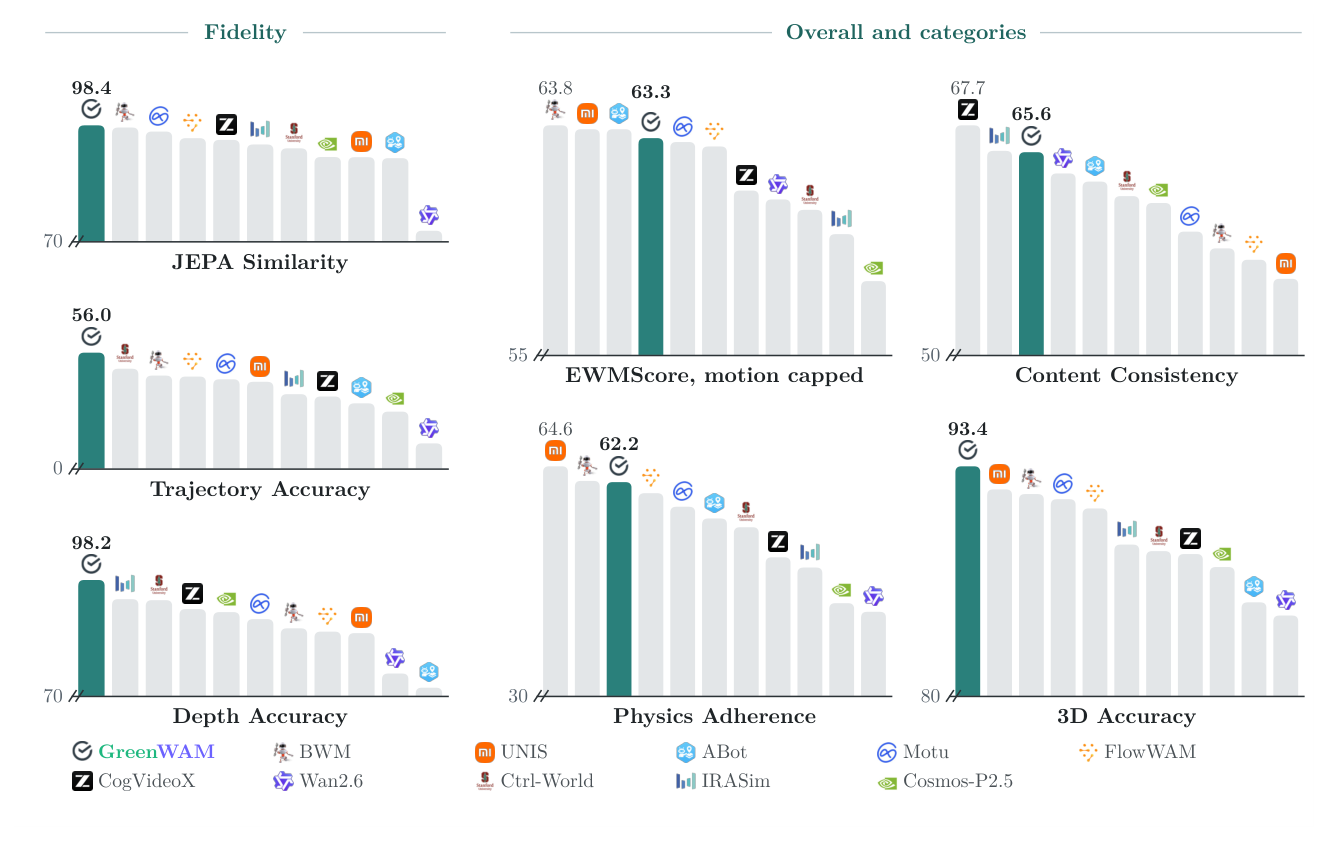
Figure 9 — World Model로서의 GreenWAM 성능을 WorldArena 1.0 벤치마크의 다양한 Fidelity 및 Overall Metrics로 비교하여 보여주는 핵심 정량적 결과 그래프
Controlled Comparisons를 통해 세 가지 핵심 요인을 확인했다 [Figure 18]. 첫째, Robot Specialization은 World Prediction과 Control을 동시에 향상시키며, WorldArena에서 Trajectory Accuracy를 3.0 points 높이고 Video Prediction Error를 23% 낮춘다. 또한 RoboTwin에서 Held-out Frames를 더 정확하게 예측하고 Policy Success Rate를 5.4% (Action Expert 포함 시 8.4%) 높인다. 둘째, Adaptation 시작 시 Generator에서 Action Expert를 분리하는 것은 Policy Success를 3.3% 증가시킨다. 셋째, Policy Adaptation 중 World-model Modes를 유지하는 것은 Scene Changes에 대한 Robustness를 보존하여 Randomized Scenes에서의 Success를 8.0% 높인다.
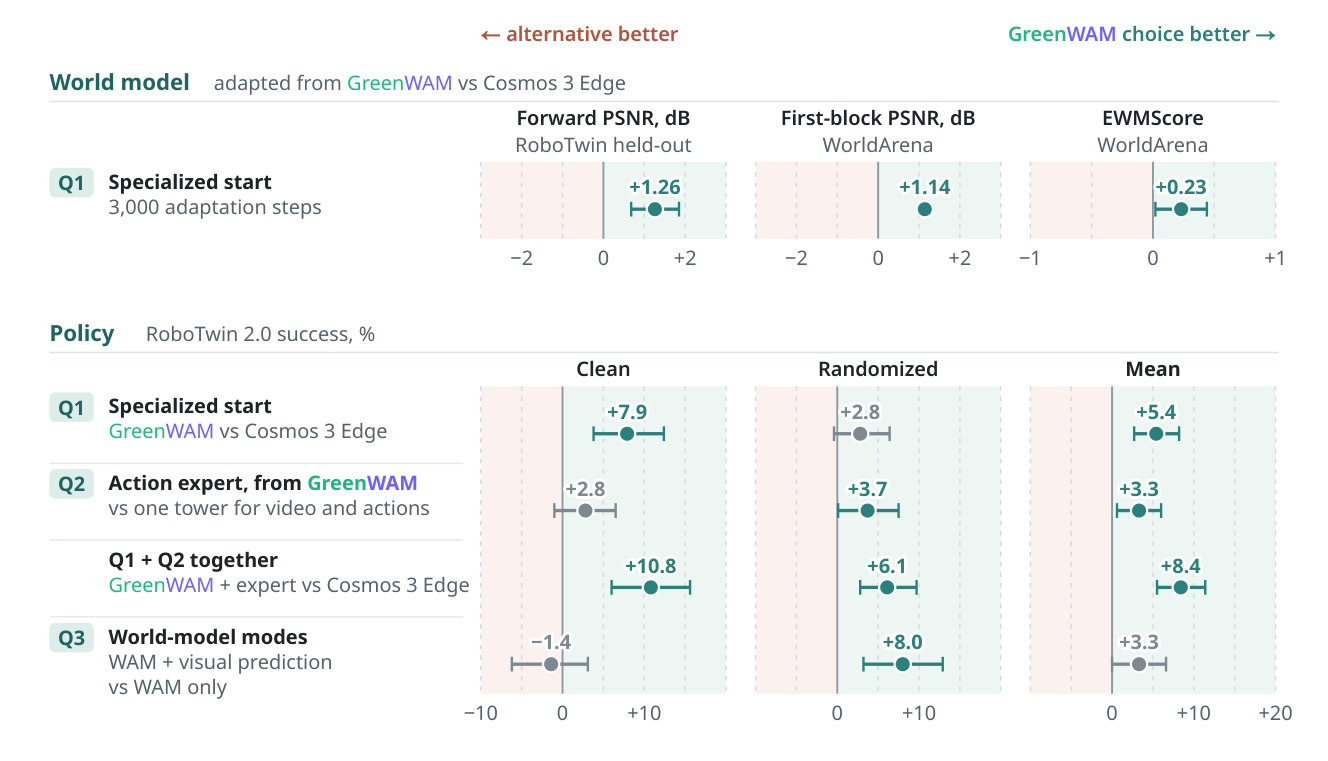
Figure 18 — GreenWAM의 핵심 디자인 선택(Robot Specialization, Action Expert, World-model Modes 유지)이 World Prediction 및 Policy Success에 미치는 영향을 정량적으로 비교 분석하는 Ablation Study 결과
4. Conclusion & Impact (결론 및 시사점)
본 논문은 GreenWAM을 통해 단일 World Foundation Model이 다양한 로봇 Bodies에 걸쳐 World Model과 Policy 역할을 모두 성공적으로 수행할 수 있음을 입증한다. 이는 Shared Anatomical Action Space, Multi-modal Training, 그리고 Action Expert 분할을 통한 Policy Adaptation이라는 고유한 Recipe를 통해 달성되었다. 이 연구는 로봇 Specialized Initialization, Action Expert 분리, World-model Modes 유지라는 세 가지 핵심 디자인 선택이 World Prediction Accuracy와 Policy Robustness를 향상시키는 데 기여한다는 것을 Controlled Comparisons로 보여주었다.
이 연구는 로봇 공학 분야에 중요한 시사점을 제공한다. 단일 Unified Model을 통해 로봇 간의 데이터 단편화 문제를 해결하고, 새로운 로봇 Body가 기존의 Shared Interface와 Codec을 통해 쉽게 통합될 수 있는 Generalization Framework를 제시한다. 이는 향후 로봇 시스템의 개발 효율성을 높이고, 보다 Robust하며 General한 로봇 제어를 가능하게 할 것이다. 또한, Real-time Control을 위한 Distilled Policy의 성공적인 적용은 실세계 로봇 배치 가능성을 확장한다. 향후 연구는 Training에서 보지 못한 새로운 로봇 Body로의 Transfer, Task Geometry 변화에 대한 Motion-level Augmentation, 그리고 Imagine된 Rollouts에서 Policy를 평가하기 위한 World Model 역할 활용에 중점을 둘 수 있다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] World Action Models are Zero-shot Policies
- [논문리뷰] Learning Native Continuation for Action Chunking Flow Policies
- [논문리뷰] DynamicVLA: A Vision-Language-Action Model for Dynamic Object Manipulation
- [논문리뷰] Ground Slow, Move Fast: A Dual-System Foundation Model for Generalizable Vision-and-Language Navigation
- [논문리뷰] LeWAM: End-to-End World and Action Modeling with JEPAs
Review 의 다른글
- 이전글 [논문리뷰] FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching
- 현재글 : [논문리뷰] GreenWAM: A World Foundation Model for Robotics
- 다음글 [논문리뷰] Harness^2: Recursive Agent Harnessing for an Open World
댓글