[논문리뷰] FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching
링크: 논문 PDF로 바로 열기
저자: Ruchang Yao, Shi Guo, Junhao Zhuang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- FlashVSR+: 본 논문에서 제안하는 효율적인 Video Super-Resolution (VSR) 프레임워크로, Hybrid Attention과 Reward-Yield Distribution Matching (Ry-DMD)을 결합하여 고품질 및 고효율 VSR을 구현합니다.
- Hybrid Attention: 기존 VSR 모델의 Dense Attention이 보여주는 강한 Local Attention Locality를 활용하여 대부분의 Global Attention Block을 효율적인 Local Spatiotemporal Attention으로 대체하고 소수의 Sparse Global Block을 유지하는 아키텍처입니다. 이를 통해 연산 비용과 메모리 사용량을 크게 줄입니다.
- Reward-Yield Distribution Matching Distillation (Ry-DMD): Preference-aligned one-step generation을 위해 제안된 새로운 Distillation Training 전략입니다. Black-box Reward를 Reward-weighted Teacher Rollout에 통합하여 Distribution Matching을 수행하며, Reward Model을 통한 Backpropagation 없이 Teacher Term Estimation을 수정합니다.
- Distribution Matching Distillation (DMD): Multi-step Diffusion Model의 Teacher 분포를 One-step Generator Student가 모방하도록 학습시키는 일반적인 Distillation 기법입니다.
- KV Cache Offloading: GPU 메모리의 지속적인 KV Cache 사용량을 줄이기 위해, Global Attention Layer의 KV Cache를 Pinned CPU Memory로 Offload하고 필요한 시점에 Asynchronously하게 GPU로 Prefetch하는 최적화 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Video Super-Resolution (VSR) 분야에서 One-step Generative Model의 효율성과 Human Preference Alignment이라는 두 가지 핵심 Bottleneck을 해결하고자 합니다. 첫째, 기존 Diffusion-based VSR 모델들은 고비용의 Multi-step Denoising Trajectory에 의존하며, One-step Distillation을 통해 Latency를 줄였음에도 불구하고 High-resolution Video (예: 2K, 4K) Inference 시 Spatiotemporal Attention의 높은 계산 및 메모리 비용으로 인해 여전히 Spatial Tiling이 필요하여 Global Context를 제한하고 Boundary Artifact를 유발합니다 [Figure 1]. 둘째, Standard Distribution Matching Distillation (DMD) 방법은 Teacher 분포를 일치시키지만, Text Rendering의 정확도와 같이 Human Preference에 더 잘 부합하는 Output을 명시적으로 선호하지 않으며, Black-box Reward를 Deterministic One-step Generator에 통합하기 어렵습니다. 이러한 한계점들은 효율적이고 사용자가 선호하는 고해상도 VSR의 확산을 방해하고 있습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 이러한 Bottleneck을 해결하기 위해 Hybrid Attention 아키텍처와 Reward-Yield Distribution Matching Distillation (Ry-DMD) 학습 전략을 결합한 **FlashVSR+**를 제안합니다 [Figure 2]. Hybrid Attention은 Pretrained VSR 모델에서 관찰된 Attention Locality를 기반으로, 대부분의 Attention Block을 효율적인 Local Spatiotemporal Attention으로 대체하고 소수의 Sparse Global-attention Block을 유지하여 장거리 Consistency를 보존합니다. 이 설계는 DiT 가속을 2배까지 달성하고 Peak Memory를 45% 낮춰 단일 24GB RTX 4090 GPU에서 Spatial Tiling 없이 4K VSR Inference를 가능하게 합니다 [Figure 6]. 실제 NVIDIA RTX 4090 GPU에서 Ours-Turbo는 4K 해상도에서 177초가 소요되는 SeedVR2 대비 14배 빠른 20초의 Inference 시간을 기록했습니다 [Figure 6].
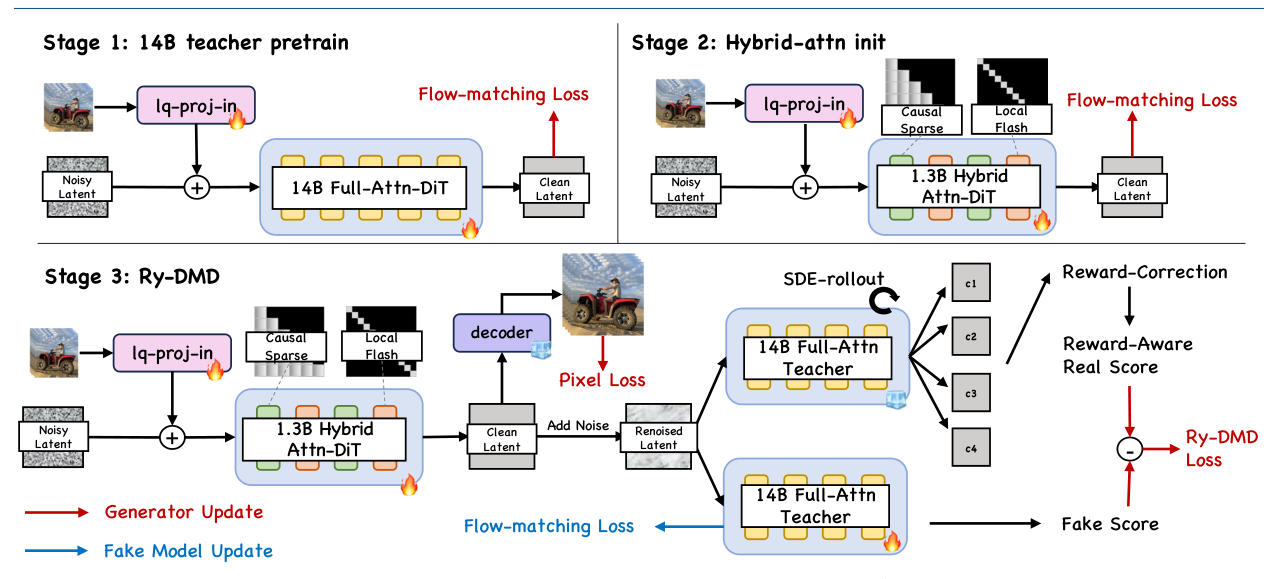
Figure 2 — FlashVSR+의 전체 3단계 훈련 파이프라인을 보여주는 핵심 다이어그램
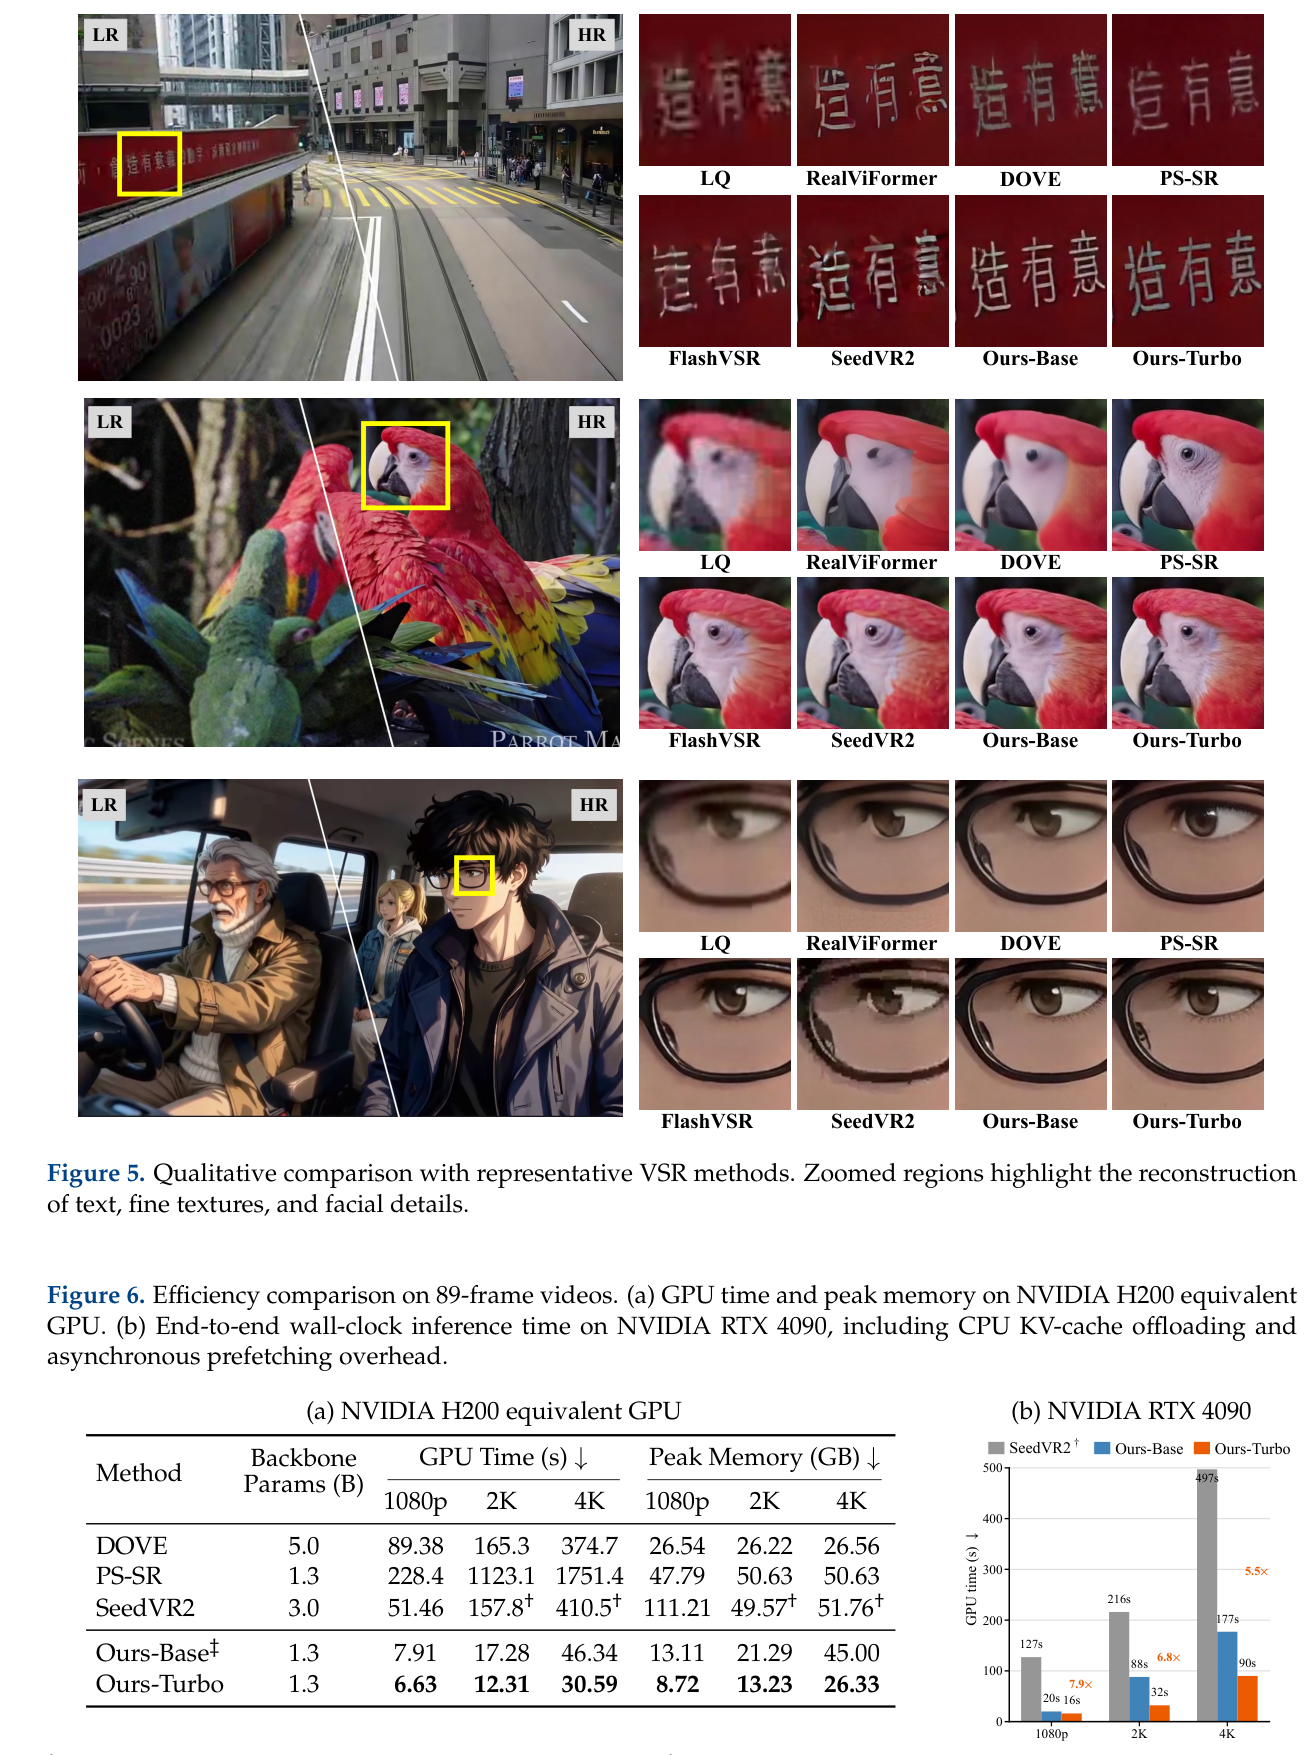
Figure 6 — FlashVSR+의 뛰어난 Inference Efficiency (GPU 시간 및 Peak Memory)를 정량적으로 비교하는 핵심 결과 그래프 및 표
Ry-DMD는 Human Preference에 부합하는 One-step Generation을 위해 Black-box Reward를 활용하는 새로운 Distillation 방법입니다. 이는 Reward-weighted Teacher Rollout을 사용하여 Black-box Reward를 Teacher Term Estimation에 통합하고, Reward Model의 Backpropagation 없이 Teacher Target을 Higher-reward Output 방향으로 조정합니다 [Figure 4]. 이 접근 방식은 OCR-guided VSR Post-training에서 Ry-DMD가 0.776의 OCR 점수를 달성하여 Baseline의 0.624와 DMDR의 0.527을 크게 능가하면서도 Restoration Quality를 유지하는 것으로 입증되었습니다 (LPIPS 0.240 vs 0.246) [Table 3]. 또한, Ry-DMD는 Text-to-Image Generation으로 일반화되어, One-step DMD2의 OCR Accuracy 0.087를 0.241로 향상시키고 PickScore 29.6와 같은 Quality Metric을 유지하거나 개선함을 보여주었습니다 [Table 4]. 사용자 선호도 연구에서 Ours-Base는 모든 비교 방법보다 선호되었으며, Ours-Turbo는 높은 Inference Efficiency에도 불구하고 비슷한 선호도를 유지했습니다 [Table 1].
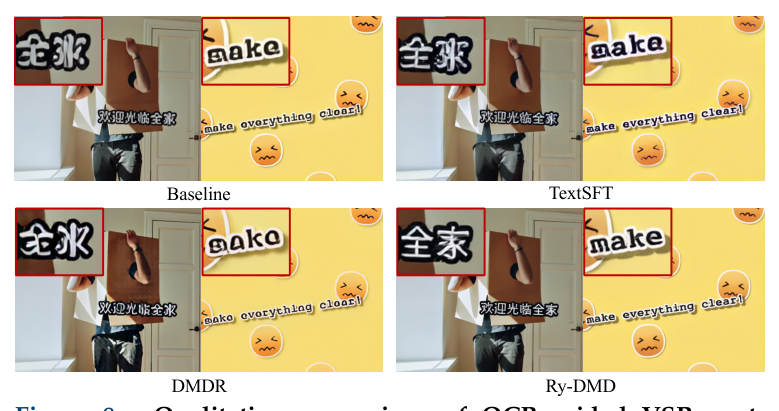
Table 3 — Ry-DMD가 OCR-guided VSR에서 Baseline 및 다른 Post-training 전략보다 우수한 성능을 보여주는 정량적 비교 테이블
4. Conclusion & Impact (결론 및 시사점)
**FlashVSR+**는 Hybrid Spatiotemporal Attention과 Reward-Yield Distribution Matching Distillation (Ry-DMD)을 결합하여 효율적이고 Reward-guided One-step Video Super-Resolution을 제공합니다. 본 프레임워크는 고해상도 VSR의 주요 Bottleneck인 Computational Efficiency와 Human Preference Alignment 문제를 성공적으로 해결했습니다. 특히, 단일 24GB RTX 4090 GPU에서 Spatial Tiling 없이 4K 해상도 Inference를 가능하게 함으로써, 소비 등급 하드웨어에서도 고품질 비디오 초해상도 기술의 광범위한 적용 가능성을 열었습니다. Ry-DMD는 Black-box Reward Optimization을 Reward Backpropagation 없이 가능하게 하여, VSR뿐만 아니라 Text-to-Image Generation과 같은 다른 Generative Task에서도 성능 향상을 보여주며 그 일반성을 입증했습니다. 이는 사용자 선호도와 밀접하게 연관된 Generative AI 모델 개발에 중요한 시사점을 제공하며, 향후 고품질/고효율 Generative AI 서비스의 발전에 기여할 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Glance Forcing: Making Bidirectional Diffusion Autoregressive at a Glance
- [논문리뷰] Multilinguality in Hybrid Attention LLMs
- [논문리뷰] Diffusion Reward Models
- [논문리뷰] Video DeltaNet: A Video-Native Hybrid Attention for Livestream Video Generation
- [논문리뷰] ZGCM-1: A Fully Open and Extremely Efficient Foundation Model for Math and Agentic Search
Review 의 다른글
- 이전글 [논문리뷰] ExeWorldBench: Benchmarking Code-Based Executable 3D World Modeling
- 현재글 : [논문리뷰] FlashVSR+: Efficient Video Super-Resolution via Hybrid Attention and Reward-Yield Distribution Matching
- 다음글 [논문리뷰] GreenWAM: A World Foundation Model for Robotics
댓글