[논문리뷰] SoL-Refiner: Speed-of-Light One-Step Refinement for High-Resolution Video
링크: 논문 PDF로 바로 열기
저자: Haozhe Liu, Tian Ye, Shuchen Xue, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- SoL-Refiner: 저해상도 비디오 모델의 출력을 단일 denoising step으로 고해상도 (예: 4K) 비디오로 변환하는 One-Step Video Refiner.
- Refiner-Bench: 다양한 비디오 제너레이터의 출력을 기반으로 구축된 새로운 비디오 refinement 벤치마크로, 공유 입력 프로토콜을 사용하여 refiner들을 비교하는 데 사용된다.
- Truncated-σ Flow Matching: SoL-Refiner 학습의 Stage I에서 사용되는 flow-matching objective로, low-fidelity latent의 정보를 유지하도록 denoising path를 잘라내어 vector field가 순수한 노이즈로부터의 재구성이 아닌 refinement를 지향하도록 한다.
- Reward Feedback Learning (ReFL): Stage II에서 적용되는 post-training 방법론으로, 프레임 기반의 image-quality 및 preference signal (HPSv3++, DeQA)을 사용하여 multi-step refiner의 perceptual quality 및 인간 선호도를 최적화한다.
- Distribution Matching Distillation (DMD-GAN): Stage III에서 multi-step refiner를 one-step 모델로 압축하기 위해 사용되는 distillation 기법으로, teacher distribution matching과 adversarial supervision을 결합한다.
- Sol-Engine: Kernel fusion과 sparse attention을 결합하여 denoising 연산량을 줄임으로써 비디오 생성 추론을 최적화하는 가속화 프레임워크이다.
- Tiny Autoencoder (TAE): Full Video Variational Autoencoder (VAE)를 대체하는 경량 autoencoder로, 비디오 인코딩 및 디코딩 지연 시간을 크게 줄인다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 고해상도 비디오 생성의 높은 컴퓨팅 비용 및 기존 refinement 방법론의 비효율성 문제를 해결하기 위해 SoL-Refiner를 제안한다. 고해상도 비디오 생성은 spatiotemporal token 수가 증가함에 따라 비용이 급격히 증가하는 문제를 안고 있다. 이에 대한 실용적인 대안으로 저해상도 비디오를 먼저 생성한 후 refiner를 적용하는 2단계 디자인이 있지만, 기존의 multi-step refinement 방식은 여러 denoising step을 필요로 하여 두 번째 sampling bottleneck을 초래한다. 또한, 많은 refiner들이 특정 base generator에 맞춰 개발되어 다른 generator의 출력에 대한 전이 성능이 충분히 평가되지 않는 한계점이 있었다. 저자들은 이러한 문제들을 극복하고 효율적이며 고품질의 비디오 refinement를 제공하는 동시에 다양한 base generator에 대한 transferability를 확보하는 데 중점을 두었다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 저해상도 비디오 출력을 고품질의 고해상도 비디오로 변환하는 SoL-Refiner를 제안하며, 이를 위해 3단계 학습 레시피와 추론 최적화 기법을 도입한다. SoL-Refiner는 저해상도 입력 비디오 x_low를 단일 denoising step으로 target resolution 출력으로 매핑하여 local detail을 복원하면서 원본 콘텐츠와 모션을 보존한다 [Figure 1, 2].
SoL-Refiner의 3단계 학습 레시피는 다음과 같다:
- Stage I: Continual Training: Paired low-fidelity 및 high-fidelity 비디오 (실제 비디오 데이터셋 또는 LTX-2.3 Refiner로 생성된 synthetic pair)를 사용하여 refinement 매핑을 학습한다. 이 단계에서는 Truncated-σ Flow Matching을 통해 학습된 vector field가 순수한 노이즈로부터의 재구성이 아닌 refinement를 지향하도록 한다.
- Stage II: RL Post-Training: Reward Feedback Learning (ReFL)을 사용하여 multi-step refiner의 perceptual quality 및 인간 선호도를 최적화한다. HPSv3++ 및 DeQA와 같은 프레임 기반 reward model을 활용하여 후반 denoising step에 대한 reward supervision을 적용한다.
- Stage III: Distillation and Acceleration: Distribution Matching Distillation (DMD-GAN)과 projected DiT discriminator를 통해 multi-step refiner를 one-step 모델로 점진적으로 압축한다.
추론 최적화를 위해 Sol-Engine을 활용하여 kernel fusion과 sparse attention 기반의 denoising 연산을 가속화하고, Tiny Autoencoder (TAE)를 도입하여 비디오 인코딩 및 디코딩 latency를 크게 줄였다.
핵심 정량적 결과는 다음과 같다:
- 2K 해상도에서 SoL-Refiner는 단일 refinement step만으로 Refiner-Bench의 VBench AVG에서 0.81048, UniPercept AVG에서 60.4150을 달성하며, 평가된 모든 외부 refiner (LingBot Stage-2, LTX-2.3, LTX-2.0, SEEDVR2)를 능가했다.
- LTX-2.3 Refiner와 비교하여 SoL-Refiner는 720p, 2K, 4K 모든 해상도에서 VBench 및 UniPercept 점수가 더 높았다 [Figure 3]. 특히 4K 해상도에서는 VBench AVG를 3.86%, UniPercept AVG를 22.79% 향상시켰다.
- 완전한 가속화 스택 (one-step distillation, TAE, Sol-Engine)을 적용했을 때, SoL-Refiner는 2K latency 설정에서 3-step LTX-2.3 Refiner 대비 refinement latency를 8.91x 가속화하여, 57.461초에서 6.447초로 단축시켰다 [Figure 6].
- MiniMax H3 base model과 결합된 2단계 pipeline은 direct full-resolution H3 generation 대비 27x 빠른 속도를 보여주었다 [Figure 1].
- WAN-5B, WAN-1.3B, Cosmos-Nano 등 다양한 base generator에 적용 시, pipeline은 latency를 각각 54.7%, 71.1%, 64.4% 감소시키면서 direct high-resolution generation 대비 평균 VBench 및 UniPercept를 향상시켰다 [Figure 4].
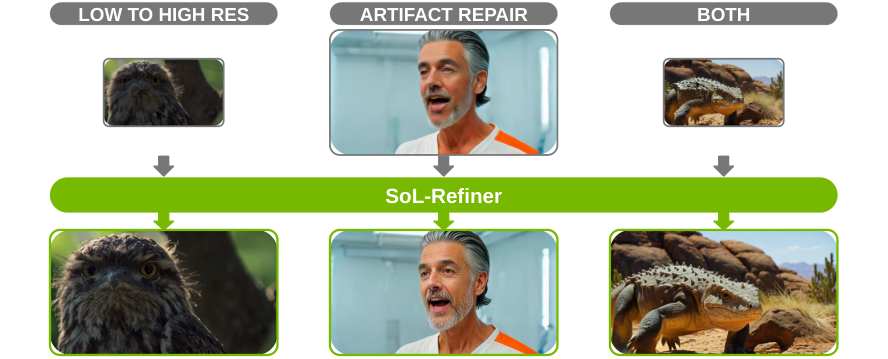
Figure 1 — SoL-Refiner의 개념도
4. Conclusion & Impact (결론 및 시사점)
SoL-Refiner는 대부분의 denoising 연산을 저해상도 base generator로 이전하고, 단일 target-resolution step을 refinement에 할당함으로써 고해상도 비디오 생성을 효율화한다. 연속 학습(continual training), reward feedback learning (ReFL)을 통한 perceptual quality 향상, 그리고 DMD-GAN distillation과 projected DiT discriminator를 이용한 one-step 압축의 3단계 훈련 방식을 통해 높은 효율성과 품질을 동시에 달성했다. Refiner-Bench에서의 실험 결과, one-step SoL-Refiner는 VBench 및 UniPercept 평균 점수에서 외부 refiner들을 능가했으며, 특히 2K latency 설정에서 TAE와 Sol-Engine을 통합하여 3-step LTX-2.3 Refiner 대비 8.91x의 현저한 refinement latency 감소를 입증했다.
이 연구는 고해상도 비디오 생성의 컴퓨팅 부담과 지연 시간을 크게 줄여, 실제 응용 분야에서의 활용 가능성을 높이고 다양한 AI 생성 비디오의 품질을 향상시키는 데 중요한 시사점을 제공한다. 또한, 새로운 벤치마크인 Refiner-Bench를 도입함으로써 향후 비디오 refinement 연구의 평가 기준을 제시하고 해당 분야의 발전에 기여할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Flash-DMD: Towards High-Fidelity Few-Step Image Generation with Efficient Distillation and Joint Reinforcement Learning
- [논문리뷰] AdaTutoRank: Learning to Rerank Document Sets via Adaptive Tutoring Optimization for RAG and Deep Research
- [논문리뷰] AV-GRPO: Modality-Anchored Decoupling Diffusion Reinforcement Learning for Joint Audio-Video Generation
- [논문리뷰] VideoGen-Agent: Reinforcing Video Generation Agents
- [논문리뷰] DriveZero: End-to-End Driving Beyond Human Demonstrations
Review 의 다른글
- 이전글 [논문리뷰] Selecting The Most Informative Tokens in Natural Language Autoencoders
- 현재글 : [논문리뷰] SoL-Refiner: Speed-of-Light One-Step Refinement for High-Resolution Video
- 다음글 [논문리뷰] TGRL: Temperature-Grouped Reinforcement Learning for Efficient Exploration in LLMs
댓글