[논문리뷰] AdaTutoRank: Learning to Rerank Document Sets via Adaptive Tutoring Optimization for RAG and Deep Research
링크: 논문 PDF로 바로 열기
저자: Kailin Jiang, Lei Liu, Jian Xi, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문은 Setwise Reranking을 위한 새로운 프레임워크인 AdaTutoRank를 제안하며, 핵심적으로 다음 용어들을 다룹니다:
- Setwise Reranking: 개별 문서의
Relevance에 기반하여 순위를 매기는 대신, 질문에 가장 적합한 문서 *집합(Set)*을 직접 선택하고 구성하는 방법론입니다. 이는 문서들이Complementarity,Redundancy,Conflict등 여러 차원에서 전체적인 품질을 이루도록 합니다. - Adaptive Tutoring Optimization (ATO):
AdaTutoRank학습에 사용되는 핵심 최적화 기법으로,Policy의Rollout Quality에 따라 다양한 형태의Hint를 제공하여Dense Token-level Supervision을 가능하게 합니다. - Rubrics: 문서 집합의 품질을 다차원적으로 평가하기 위해 사용되는 계층적 기준 체계입니다.
Document-level,Set-level,Global-level의 세 가지 레벨에 걸쳐Relevance,Authenticity,Quality,Complementarity,Redundancy,Conflict,Completeness,Density,Reachability등 아홉 가지Dimension을 포함합니다. 이Rubrics는Silver Labels생성,Reinforcement Learning을 위한Reward계산, 그리고Distillation Hint제공에 활용됩니다. - RAG (Retrieval-Augmented Generation):
Large Language Models (LLMs)이 자체 파라미터 외부에 있는Knowledge Source에서 정보를Retrieve하여 답변을 생성하는 시스템입니다. - Deep Research:
Agentic Search의 한 형태로,LLM기반Agent가 복잡한 정보 탐색 작업을 위해 여러 단계에 걸쳐Reasoning과Web Search를 반복하는 과정을 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 Document Reranker들은 주로 개별 문서의 Relevance 매칭에 기반하여 상위 k개의 문서를 선택하며, 이로 인해 Downstream Model (예: RAG 시스템이나 Deep Research Agent)에 전달되는 문서 Set은 Completeness, Complementarity, Non-Redundancy 등 복합적인 정보 요구를 충족하지 못하는 한계가 있습니다. 본 논문은 이러한 Mainstream Reranker의 Pointwise Optimization 한계를 지적합니다. 예를 들어, Relevance-based Reranking은 주제와는 관련이 있지만, 정보가 중복되거나 (Redundant), 질문의 일부 측면만을 다루어 불완전한 (Incomplete) 문서 집합을 제공할 수 있습니다 [Figure 1].
Figure 1 — AdaTutoRank의 개념 및 기존 방법론과의 차이점
이전 Rubric-based 연구들 (RubricRanker, Rubric4Setwise)은 문서 집합의 Aggregate Rubric Score를 Reward로 사용하여 Set Composition 목표로 전환하는 가능성을 보였으나, 이 Score는 Set-level Scalar로 모든 문서에 균일하게 적용되어 Supervision이 Sparse하다는 문제가 있습니다. 이는 Redundant Document가 좋은 Set Score 때문에 보상을 받거나, 결정적인 문서가 낮은 Set Score 때문에 불이익을 받는 Credit Assignment Problem을 야기합니다. 또한, 기존 On-policy Distillation 방식은 모든 Rollout에 동일한 Fixed Guidance를 제공하여, Strong Rollout에는 너무 지시적이고 Weak Rollout에는 너무 추상적이라는 한계가 있습니다. 따라서 저자들은 On-policy, Dense, 그리고 Adaptive Tutoring이 가능한 Supervision의 필요성을 제기합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 RAG 및 Deep Research를 위한 Setwise Reranker인 AdaTutoRank를 제안하며, Adaptive Tutoring Optimization (ATO)과 계층적 Rubric Supervision을 통해 학습됩니다. AdaTutoRank의 학습은 두 단계로 진행됩니다 [Figure 2]. 첫 번째는 Setwise Supervised Fine-Tuning (SFT)으로, Query-specific Rubrics로부터 생성된 Silver Labels를 사용하여 Policy를 Cold Start 상태로 초기화하여 필요한 형태의 Set을 선택하도록 학습합니다. 두 번째는 Adaptive Tutoring Optimization (ATO) 단계로, Scalar Reward가 부족한 Dense Signal을 제공합니다. 이 단계에서는 Frozen Policy Snapshot이 Rollout의 Reward에 맞춰 세 가지 형태의 Hint를 생성합니다: Rubrics 자체, Rubric-selected Sibling-set, 그리고 Rollout과 Sibling-set을 대조하는 Self-reflector의 Reflection. Rollout Quality에 따라 적절한 Hint 형태를 선택적으로 제공하며, 이를 통해 Hint의 효과를 Token-level Advantage로 Distill하여 Group-relative Outcome Advantage와 결합하여 Set-level Utility와 개별 문서의 Quality를 함께 최적화합니다.
Figure 2 — AdaTutoRank의 전체 방법론 개요
실험 결과, AdaTutoRank는 RAG, Deep Research, Setwise Evaluation을 아우르는 10개 벤치마크에서 전반적으로 최고의 성능을 달성했습니다. Answer-level Performance에서 AdaTutoRank는 45.28의 Overall Score를 기록하여, 가장 강력한 Baseline인 RubricRanker 대비 1.44 Point 그리고 Initial Retrieval 대비 6.20 Point 향상된 결과를 보였습니다 [Table 1]. 특히 Deep Research 시나리오에서 RAG 시나리오보다 더 큰 성능 향상(Deep Research 평균 53.06으로 Baseline 대비 2.05 Point 향상, RAG 평균 39.05로 Baseline 대비 0.80 Point 향상)을 보였는데, 이는 Deep Research에서 Reranker의 역할이 Trajectory 전체에 걸쳐 Compounding Effect를 가지기 때문입니다. Setwise-level Evaluation에서는 AdaTutoRank가 모든 세 가지 Rubric Level (Doc-Level, Set-Level, Global-Level)에서 가장 높은 평균 점수를 기록하며 Overall Score 48.97을 달성, RubricRanker 대비 2.17 Point 더 우수한 Evidence Quality를 입증했습니다 [Table 2]. 또한 AdaTutoRank는 Deep Research Agent에서 Retrieval Call 횟수를 줄이면서도 Set의 Quality를 높여 Search Efficiency를 향상시켰습니다 [Figure 5]. Ablation Study를 통해 ATO와 SFT 두 학습 단계의 상호 보완성, RL Advantage와 Distillation Advantage의 결합 효과, 그리고 Adaptive Tutoring Hint의 필요성이 검증되었습니다 [Table 3]. 다양한 Candidate Pool Size에서도 AdaTutoRank가 일관되게 강력한 성능을 유지하며, Training Range를 넘어선 Pool Size에서도 Set Selection 능력이 Transfer됨을 확인했습니다 [Figure 4].
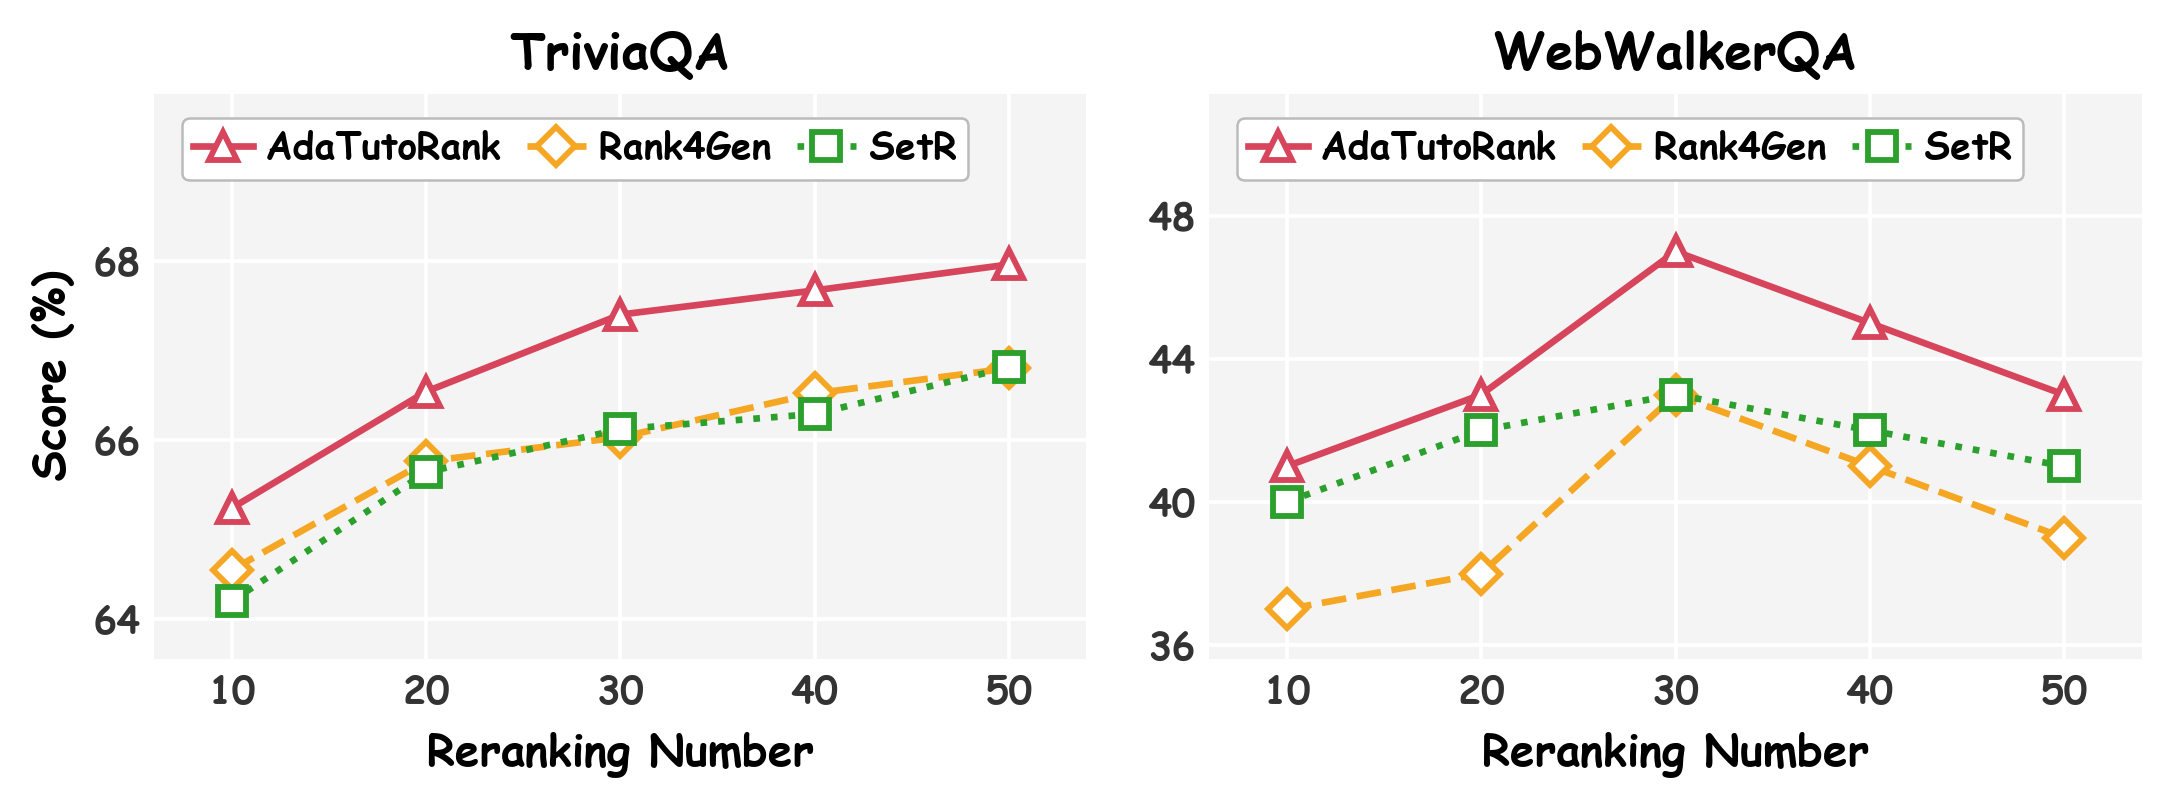
Figure 4 — 후보 문서 수에 따른 성능 변화
4. Conclusion & Impact (결론 및 시사점)
본 연구는 RAG 및 Deep Research를 위한 Set-level Utility를 최적화하는 Setwise Reranker인 AdaTutoRank를 제안합니다. AdaTutoRank는 문서, 세트, 전역 수준의 세 가지 계층으로 구성된 아홉 가지 Dimension의 Query-specific Rubrics를 통해 문서 집합의 다차원적 품질을 명시적으로 Optimize할 수 있게 합니다. 두 단계의 학습 프레임워크는 Rubric-conditioned Silver Labels를 통한 Cold Start와 Rollout Quality에 맞춰 Hint를 제공하는 Adaptive Tutoring Optimization을 통해 Outcome Reward와 Token-level Distillation Advantage를 결합합니다. 추론 시 AdaTutoRank는 Query-specific Rubrics나 Hint 없이도 고품질의 문서 Subset을 직접 선택합니다.
AdaTutoRank는 Answer-level 및 Setwise-level 평가 모두에서 일관된 성능 향상을 입증하였으며, Deep Research Agent의 Retrieval Call 횟수를 줄이는 Efficiency 증대 효과도 보였습니다. 이 연구는 Rubrics가 단순한 평가 기준을 넘어 Dense Token-level Supervision Signal로 활용될 수 있음을 보여주며, 향후 Information Retrieval 및 LLM 응용 분야에서 Context Selection의 Quality와 Efficiency를 개선하는 데 중요한 영향을 미칠 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] DriveZero: End-to-End Driving Beyond Human Demonstrations
- [논문리뷰] V-Rubrics: Visual Faithfulness via Rubric-Based Reinforcement Learning
- [논문리뷰] EXIMO: VLM Guided Exploration of VLA Policies
- [논문리뷰] AREX: Towards a Recursively Self-Improving Agent for Deep Research
- [논문리뷰] TREK: Distill to Explore, Reinforce to Refine
Review 의 다른글
- 이전글 [논문리뷰] ZooWork-ShopRanker: An Open, Preference-Aligned E-Commerce Reranker
- 현재글 : [논문리뷰] AdaTutoRank: Learning to Rerank Document Sets via Adaptive Tutoring Optimization for RAG and Deep Research
- 다음글 [논문리뷰] An RL View of OPD: Least Square Policy Distillation for Sample-Efficient LLM Reasoning
댓글