[논문리뷰] CrossBFM: Distilling a Shared Latent Behavior Space Across Humanoid Embodiments
링크: 논문 PDF로 바로 열기
저자: Tan-Dzung Do, Tuan Dat Phuong, Nico Bohlinger, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Behavior Foundation Models (BFMs): 로봇이 잠재 행동 공간(latent behavior space)을 통해 동작, 목표 자세 도달, 보상 최대화 등 다양한 프롬프트에 따라 행동할 수 있도록 하는 정책 모델이다.
- Forward–Backward (FB) representations: BFM을 구성하는 핵심 개념으로, 정책의 미래 궤적을 예측하는 Forward map과 보상 함수를 잠재 벡터로 변환하는 Backward map으로 구성된다.
- Latent-conditioned policies: 훈련된 잠재 벡터(latent vector)를 조건으로 받아 전신 제어(whole-body control)를 수행하는 정책으로, 특정 동작에 대한 명시적인 Joint-space 참조 없이 행동 의도(behavioral intent)를 따르도록 한다.
- Motion Retargeting: 인간 모션 캡처(mocap) 데이터를 로봇의 운동학적 구조에 맞춰 변환하는 과정으로, 본 논문에서는 Cross-embodiment Correspondence를 구축하는 데 활용된다.
- Unified Encoder: 다양한 휴머노이드 로봇의 고유수용성 감각(proprioception)을 입력으로 받아 로봇 독립적인 방식으로 공유된 잠재 행동 공간으로 매핑하는 아키텍처이다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 Behavior Foundation Models (BFMs)의 두 가지 주요 한계점인 높은 훈련 비용과 Embodiment-specific latent space 문제를 해결하고자 한다. 기존 BFM 훈련은 단일 로봇에 대해 수백 GPU-hours를 요구하며, 새로운 로봇에는 처음부터 훈련을 반복해야 한다. 이 과정에서 각 로봇마다 독립적인 Latent space가 생성되어, 한 로봇에서 학습된 행동 표현(behavioral representation)을 다른 로봇으로 재사용하거나 전이하기 어렵다. 이러한 한계는 다수의 휴머노이드 로봇에 BFM을 확장 적용하는 데 큰 제약이 되며, 특히 "원하는 보상을 최대화"하거나 "원하는 자세에 도달"하는 등의 Value-functional한 행동을 인코딩하는 데 어려움이 있다. 기존 Cross-embodiment Learning 연구들은 주로 단일 Task에 초점을 맞추거나 Embodiment 자체를 인코딩하는 데 집중하여 BFM의 Behavior-centric한 장점을 충분히 활용하지 못했다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 CrossBFM을 제안하여 기존 BFM의 고비용 문제와 Latent space 불일치 문제를 해결한다 [Figure 2]. CrossBFM은 두 단계로 구성된다: 첫째, 특정 로봇(Unitree G1)에 대해 사전 훈련된 BFM의 Backward map을 Frozen Source BFM latent로 고정하고, 이를 새로운 Embodiment에 Distill한다. Motion Retargeting을 통해 동일한 타임라인을 따르는 로봇 간의 Frame-level Correspondence를 구축함으로써, Target 로봇의 Backward map 학습 문제를 Supervised Regression 문제로 전환한다. 둘째, Unified Encoder Architecture를 도입하여 모든 로봇의 Proprioception을 Robot-independent한 방식으로 공유된 Latent space로 매핑하며, 이 과정은 1 GPU-hour 미만으로 완료된다. Unified Encoder는 고정된 너비의 입력(8개 Key-body indices, 33개 Canonical joint indices, Robot pelvis proprioception)을 사용하며, 존재하지 않는 Index는 Masking 처리하여 다양한 Morphology의 로봇에 범용적으로 적용할 수 있다. 이 Distilled Latent space를 기반으로 Latent-conditioned Trackers를 훈련하여 전신 제어를 수행하며, 이 단계는 약 10 GPU-hours가 소요된다.
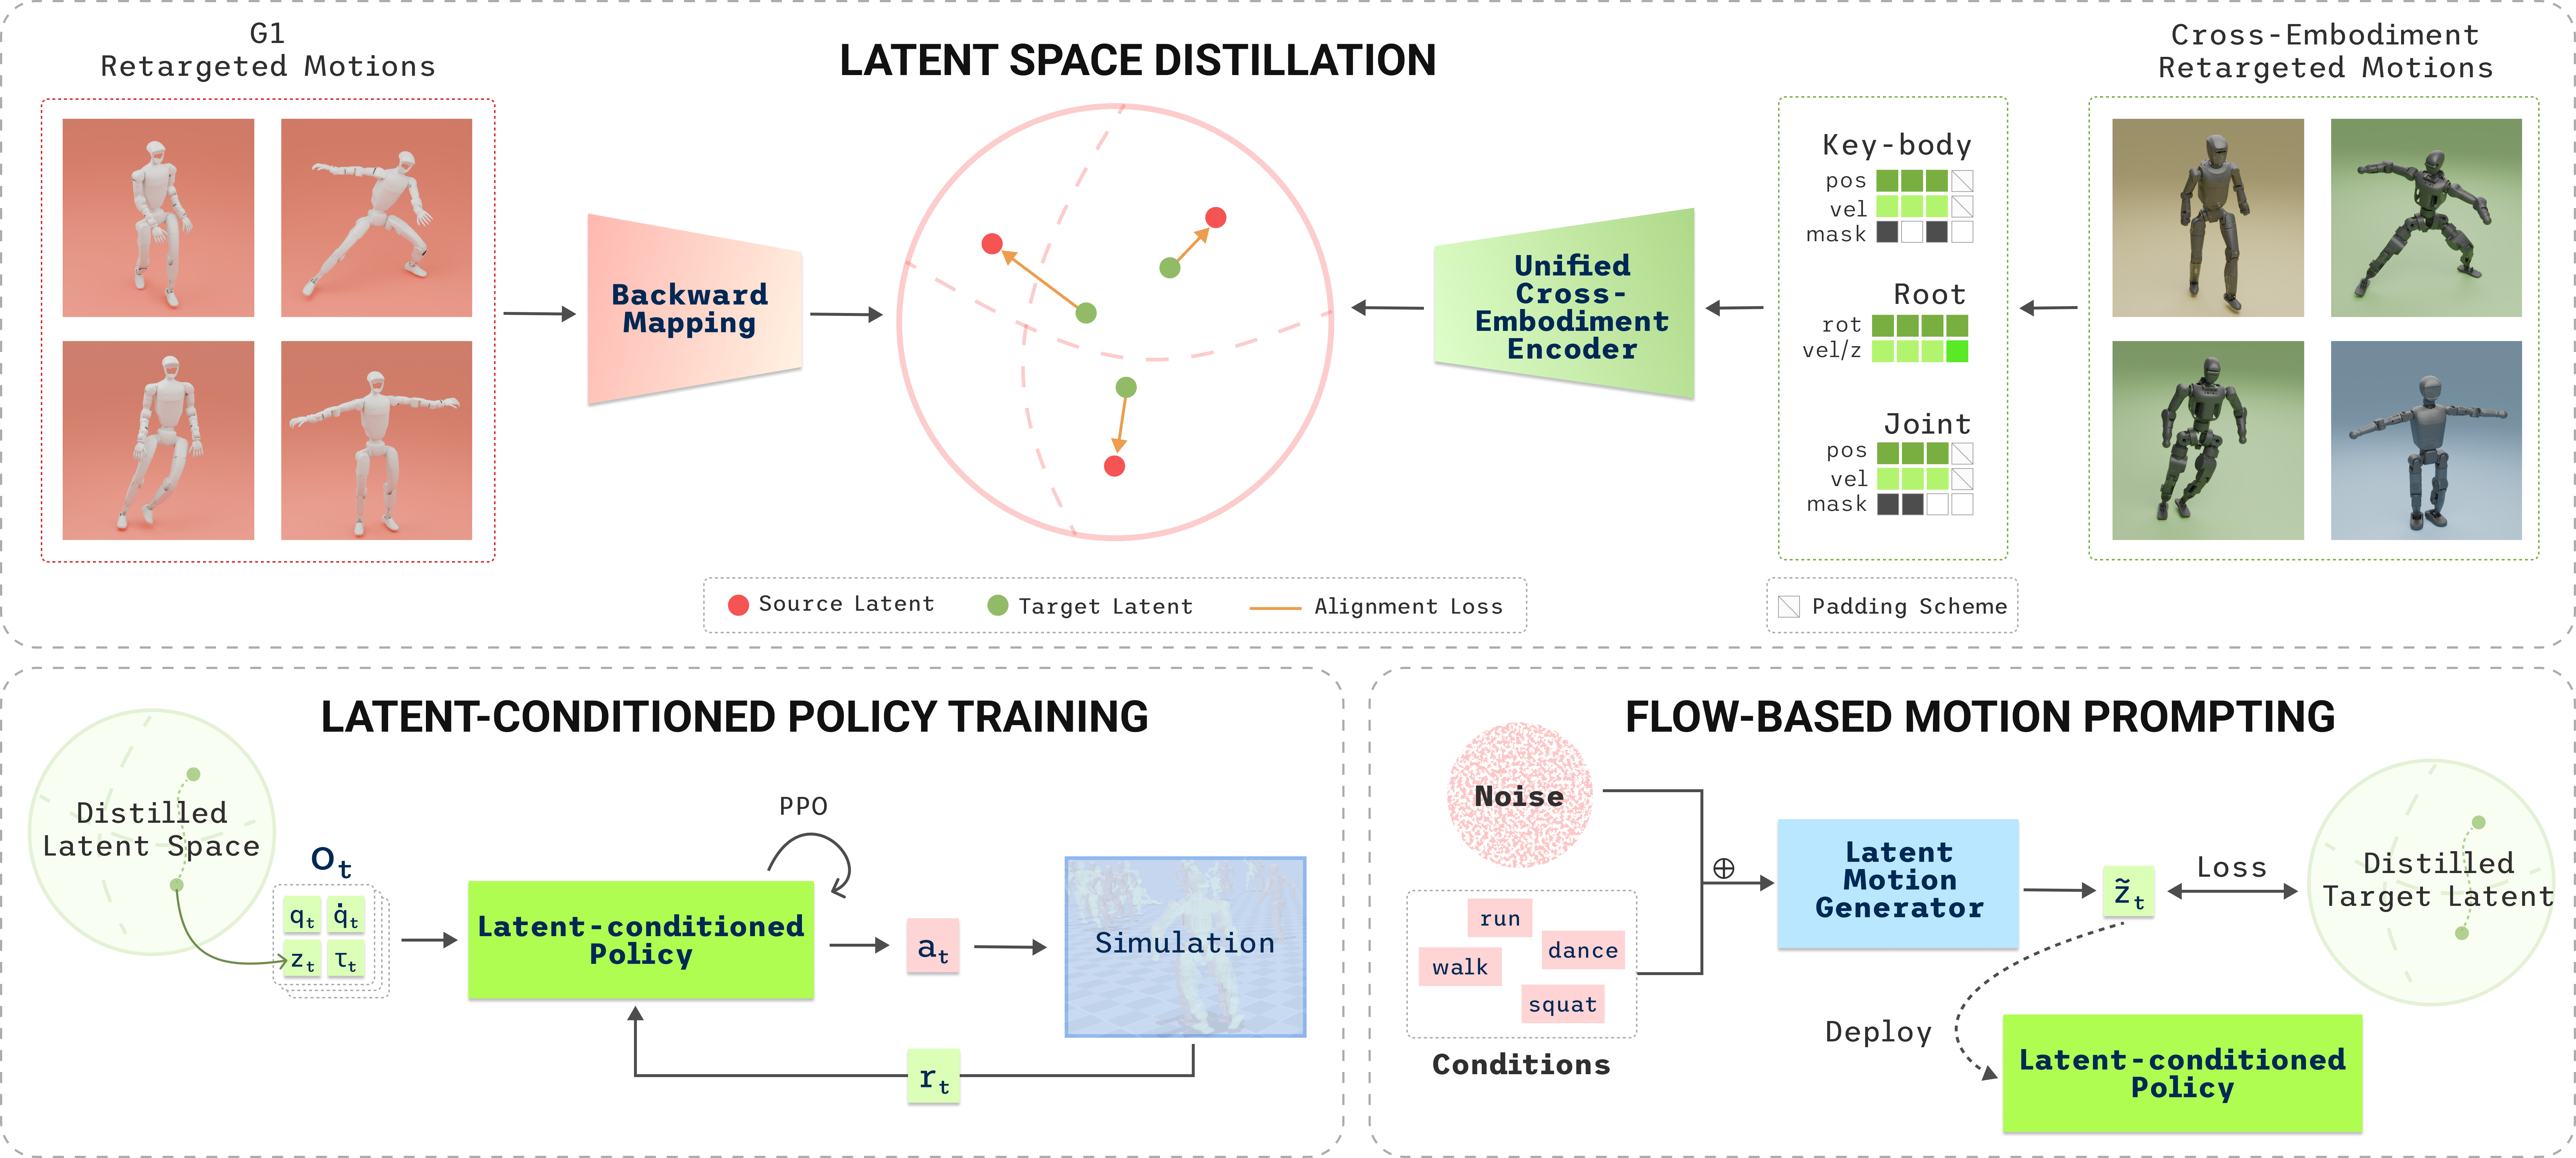
Figure 2 — CrossBFM 전체 파이프라인 개요
실험 결과, CrossBFM은 세 가지 Target 로봇(Inhouse M3, Booster T1, Fourier N1)에 대해 모든 세 가지 Prompting Mode (Motion Tracking, Goal Reaching, Reward Optimization)를 성공적으로 전이시켰다. Motion Tracking Task에서 Latent-conditioned policies는 Joint-conditioned policies 대비 0.025 rad 이내의 Joint Mean Absolute Error (MAE) 차이만을 보이며 유사한 성능을 달성했다 [cite: 1, Table 1]. 특히, Goal Reaching Task에서는 Latent interpolation을 통해 Smooth transition을 가능하게 하여, 최대 0.032 rad의 MAE로 목표 도달을 수행했다 [cite: 1, Table 1]. Reward Optimization Task에서는 본 논문의 접근 방식이 Source-side BFM의 Backward map을 직접 사용하는 것보다 M3 및 N1 로봇에서 각각 3.5배, 3.0배 더 나은 Normalized Returns를 기록했다 [cite: 1, Table 2]. 이는 Target 로봇의 Reachable set을 고려하여 Rewarded-weighted projection을 수행했기 때문이다. 또한, Unified Encoder는 Training set에 없는 새로운 Motion Clip에 대해서도 Latent Inference가 가능하며 [cite: 1, Table 3], t-SNE Projection 결과 Distilled Latent Trajectories가 Source Trajectories 위에 거의 동일하게 겹쳐지면서 명확한 행동 클러스터를 형성했다 [cite: 1, Figure 3]. 데이터 스케일링(Data Scaling) 실험에서는 전체 Motion Corpus의 1/4만 사용해도 Tracking Performance가 5%만 저하되며, Geometrical alignment 또한 잘 유지됨을 보였다. Unseen robots에 대한 일반화 실험에서는 Morphologically similar한 M3 로봇의 경우 89.3%의 Tracking Performance를 회복했으며 [cite: 1, Table 4], 이는 Unified Encoder가 새로운 로봇에 대해 의미 있는 Latent Signal을 생성함을 입증한다. 실제 로봇(M3, T1)에서도 세 가지 Prompting Mode 모두에서 시뮬레이션과 유사한 성능을 확인했다 [cite: 1, Figure 5, Table 5].
4. Conclusion & Impact (결론 및 시사점)
CrossBFM은 Retargeted data를 활용한 Supervised Learning 기반의 Latent distillation을 통해 휴머노이드 로봇 간의 Behavior space 전이 문제를 성공적으로 해결했다. 본 연구에서 제안하는 Unified Encoder는 로봇별 파라미터 없이 단일 훈련으로 다양한 Embodiment의 Proprioception을 공유된 Latent space로 효율적으로 매핑하며, 이는 기존 BFM 훈련 비용을 획기적으로 절감한다. Latent-conditioned trackers는 Motion tracking, Goal reaching, Reward optimization의 세 가지 Prompting mode에서 Joint-conditioned counterpart와 견줄 만한 성능을 보이며, 심지어 전체 데이터셋의 1/4만으로도 효과적인 Distillation이 가능함을 입증했다. 이 연구는 휴머노이드 로봇 제어 분야에서 Behavioral intent 기반의 자연스러운 인터페이스 개발을 위한 중요한 발판을 마련했으며, 향후 더 풍부한 훈련 데이터와 다양한 로봇 훈련 세트를 통한 확장 연구 및 Text instructions 기반의 Long-horizon loco-manipulation Task로의 적용 가능성을 제시한다.
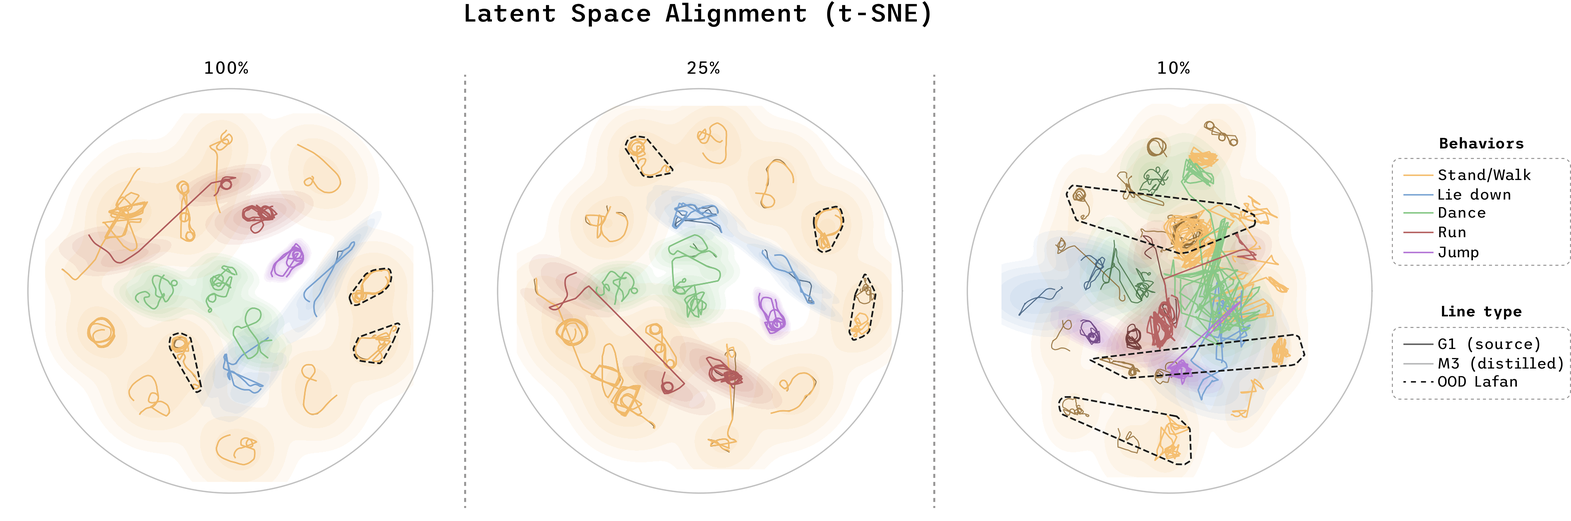
Figure 3 — Latent Trajectory t-SNE 투영 결과
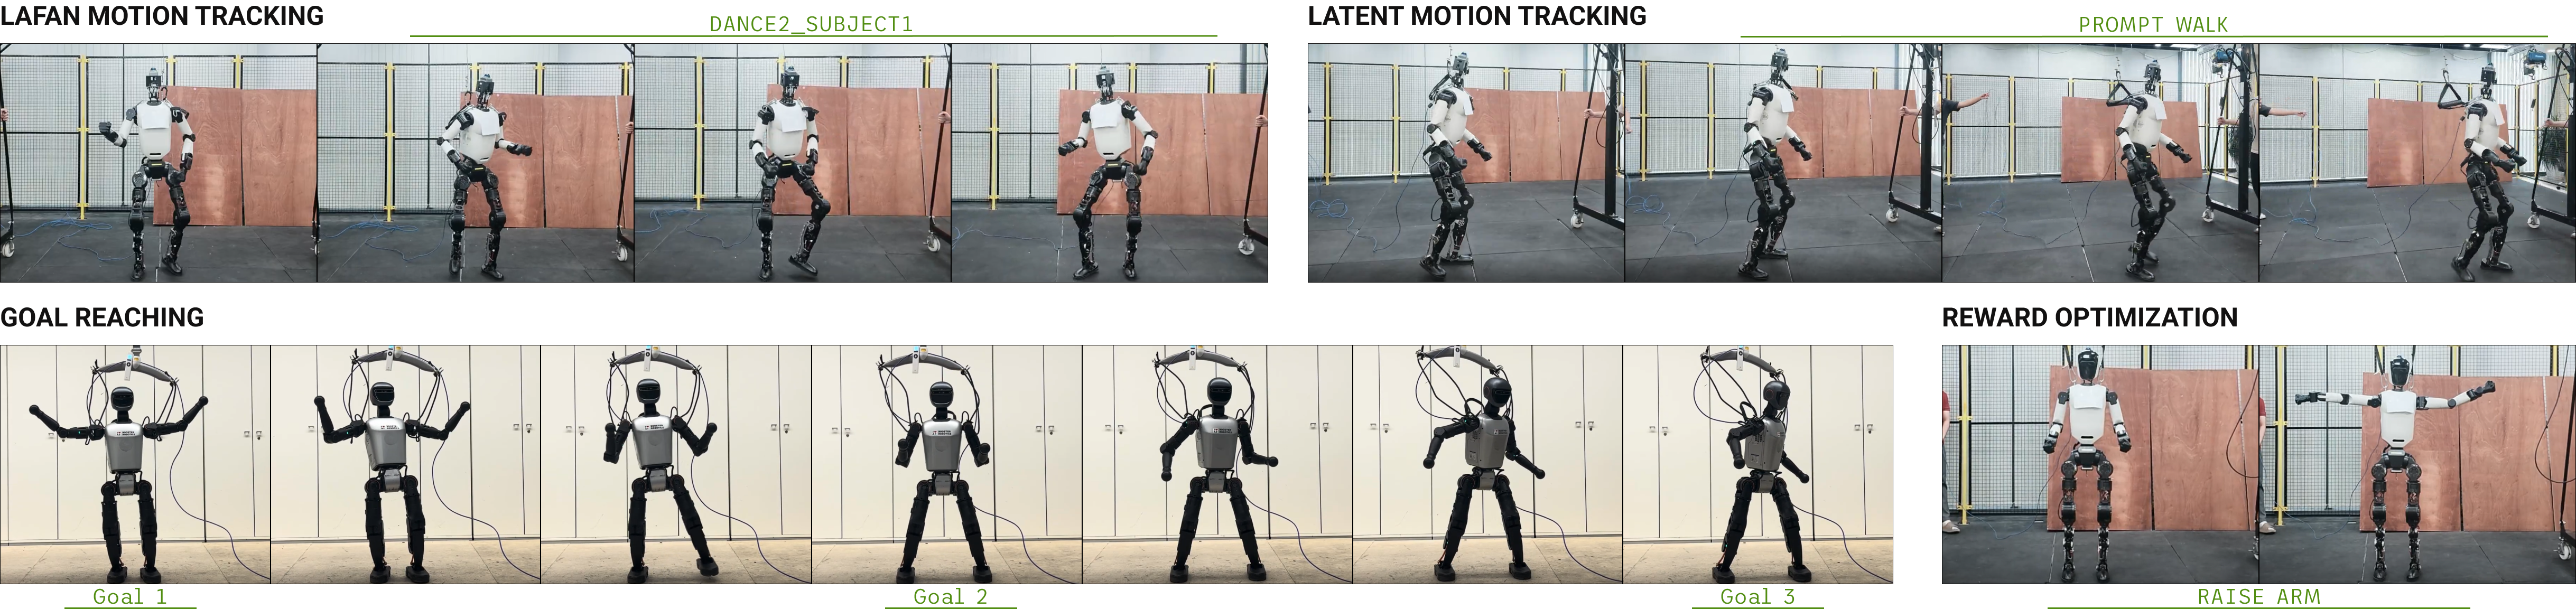
Figure 5 — 실제 로봇에서의 4가지 프롬프트 모드
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] One Symptom, Three Levers: A Critical Review of On-Policy Self-Distillation
- [논문리뷰] Distill Where You Fail: Recovering Learning Signals of Negative RL-Groups from Adaptive Teacher Guidance
- [논문리뷰] From Proprietary to Open-Source: Bridging the Distribution Gap via Multi-Agent Protocol Distillation in Agentic Search
- [논문리뷰] Distilled Reinforcement Learning for LLM Post-training
- [논문리뷰] On-Policy Delta Distillation
Review 의 다른글
- 이전글 [논문리뷰] Context Language Models
- 현재글 : [논문리뷰] CrossBFM: Distilling a Shared Latent Behavior Space Across Humanoid Embodiments
- 다음글 [논문리뷰] EVO-WAM: Evolving World Action Models through Video-Action Verification
댓글