[논문리뷰] EVO-WAM: Evolving World Action Models through Video-Action Verification
링크: 논문 PDF로 바로 열기
메타데이터
저자: Shiyang Zhou, Xionghao Wu, Wenbo Li, Shenghe Zheng, Jiyao Zhang, Songsong Yu, Yijun Yang, Jianhui Liu, Haoze Sun, Senqiao Yang, Li Jiang, Jingyong Su, Haoyang Huang, Zhuotao Tian
1. Key Terms & Definitions (핵심 용어 및 정의)
- World Action Models (WAMs): 로봇의 시각적 관찰, 상태, 작업 지침을 입력받아 미래의 비디오와 그에 대응하는 액션을 공동으로 예측하는 모델입니다.
- Autoregressive Rollouts: 외부 환경 피드백 없이 모델이 생성한 이전 비디오 프레임과 예측된 상태를 재귀적으로 입력받아 미래의 긴 비디오-액션 경로를 생성하는 방식입니다.
- Vision-Language Model (VLM): 생성된 비디오에서 시각적 단서를 분석하여 특정 작업(Task)이 성공적으로 완료되었는지 판별하는 역할을 수행합니다.
- Inverse Dynamics Model (IDM): 비디오 프레임 전환을 바탕으로 액션을 추론하여, WAM이 생성한 액션이 비디오의 시각적 내용과 일관성이 있는지 검증하는 모델입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 사전 학습된 WAM이 새로운 환경에서 추가적인 expert demonstration 없이 스스로 학습 능력을 개선하는 것을 목표로 합니다. 기존 WAM은 광범위한 비디오 사전 지식을 보유하고 있으나, 생성된 비디오가 항상 과업을 완료하지 않거나, 시각적으로 성공한 비디오라도 실제 액션과 불일치하여 로봇 실행에 실패하는 문제가 존재합니다 [Figure 1]. 이러한 불확실성으로 인해 모델이 생성한 경로를 무분별하게 학습 데이터로 활용할 경우, 잘못된 행동이 강화될 위험이 있습니다. 따라서 외부 환경에서의 물리적 실행 없이도, 모델 스스로 신뢰할 수 있는 비디오-액션 궤적을 선별하고 학습할 수 있는 체계적인 방법론이 필수적입니다.
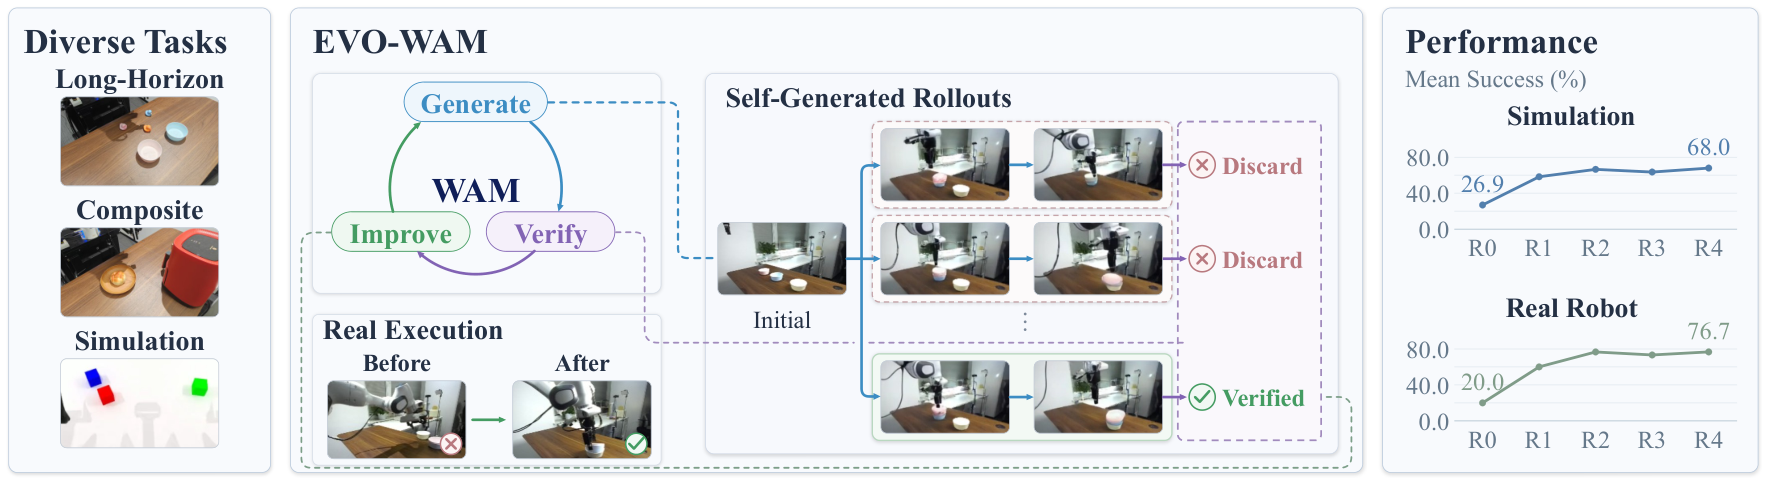
Figure 1 — EVO-WAM의 핵심 워크플로우
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 EVO-WAM 프레임워크를 제안하며, 이는 Autoregressive Rollouts를 통한 생성, VLM 및 IDM을 활용한 검증, 그리고 검증된 데이터를 통한 반복적 Self-Training으로 구성됩니다 [Figure 2]. 우선, 상태 예측과 멀티 프레임 컨텍스트 고정을 통해 모델이 외부 피드백 없이도 연속적인 미래 상태를 예측할 수 있게 개선하였습니다. 검증 단계에서는 VLM이 작업 완료 여부를 평가하고, IDM이 영상 내용과 생성된 액션의 Consistency를 확인하여 신뢰 가능한 데이터를 필터링합니다 [Figure 3]. RoboTwin 2.0 벤치마크 실험 결과, EVO-WAM_Cosmos3_ 모델은 기존 대비 평균 성공률을 26.9%에서 68.0%로, EVO-WAM_DreamZero_ 모델은 28.5%에서 46.4%로 크게 향상시켰습니다 [Table 1]. 또한, 실제 로봇을 이용한 복합 과제 환경에서도 EVO-WAM_Cosmos3_는 기존 20.0%의 성공률을 76.7%로 개선하며 우수한 성능을 입증하였습니다 [Table 2].
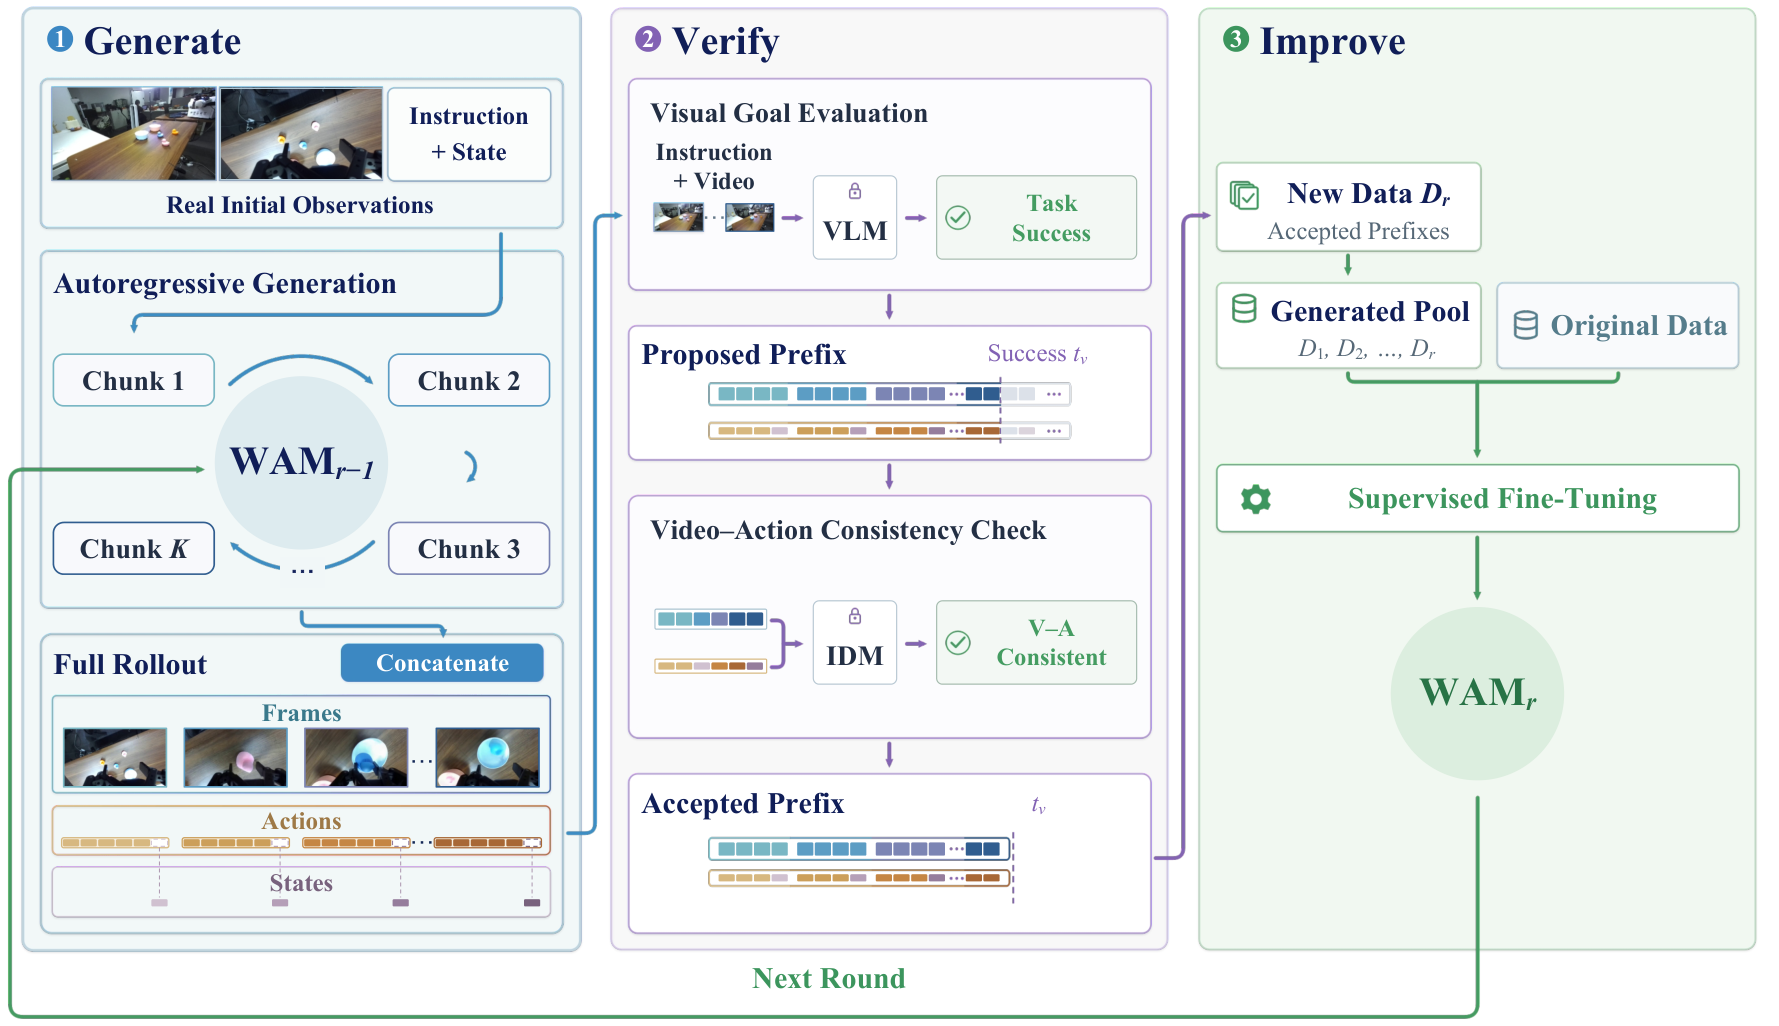
Figure 2 — EVO-WAM 전체 아키텍처
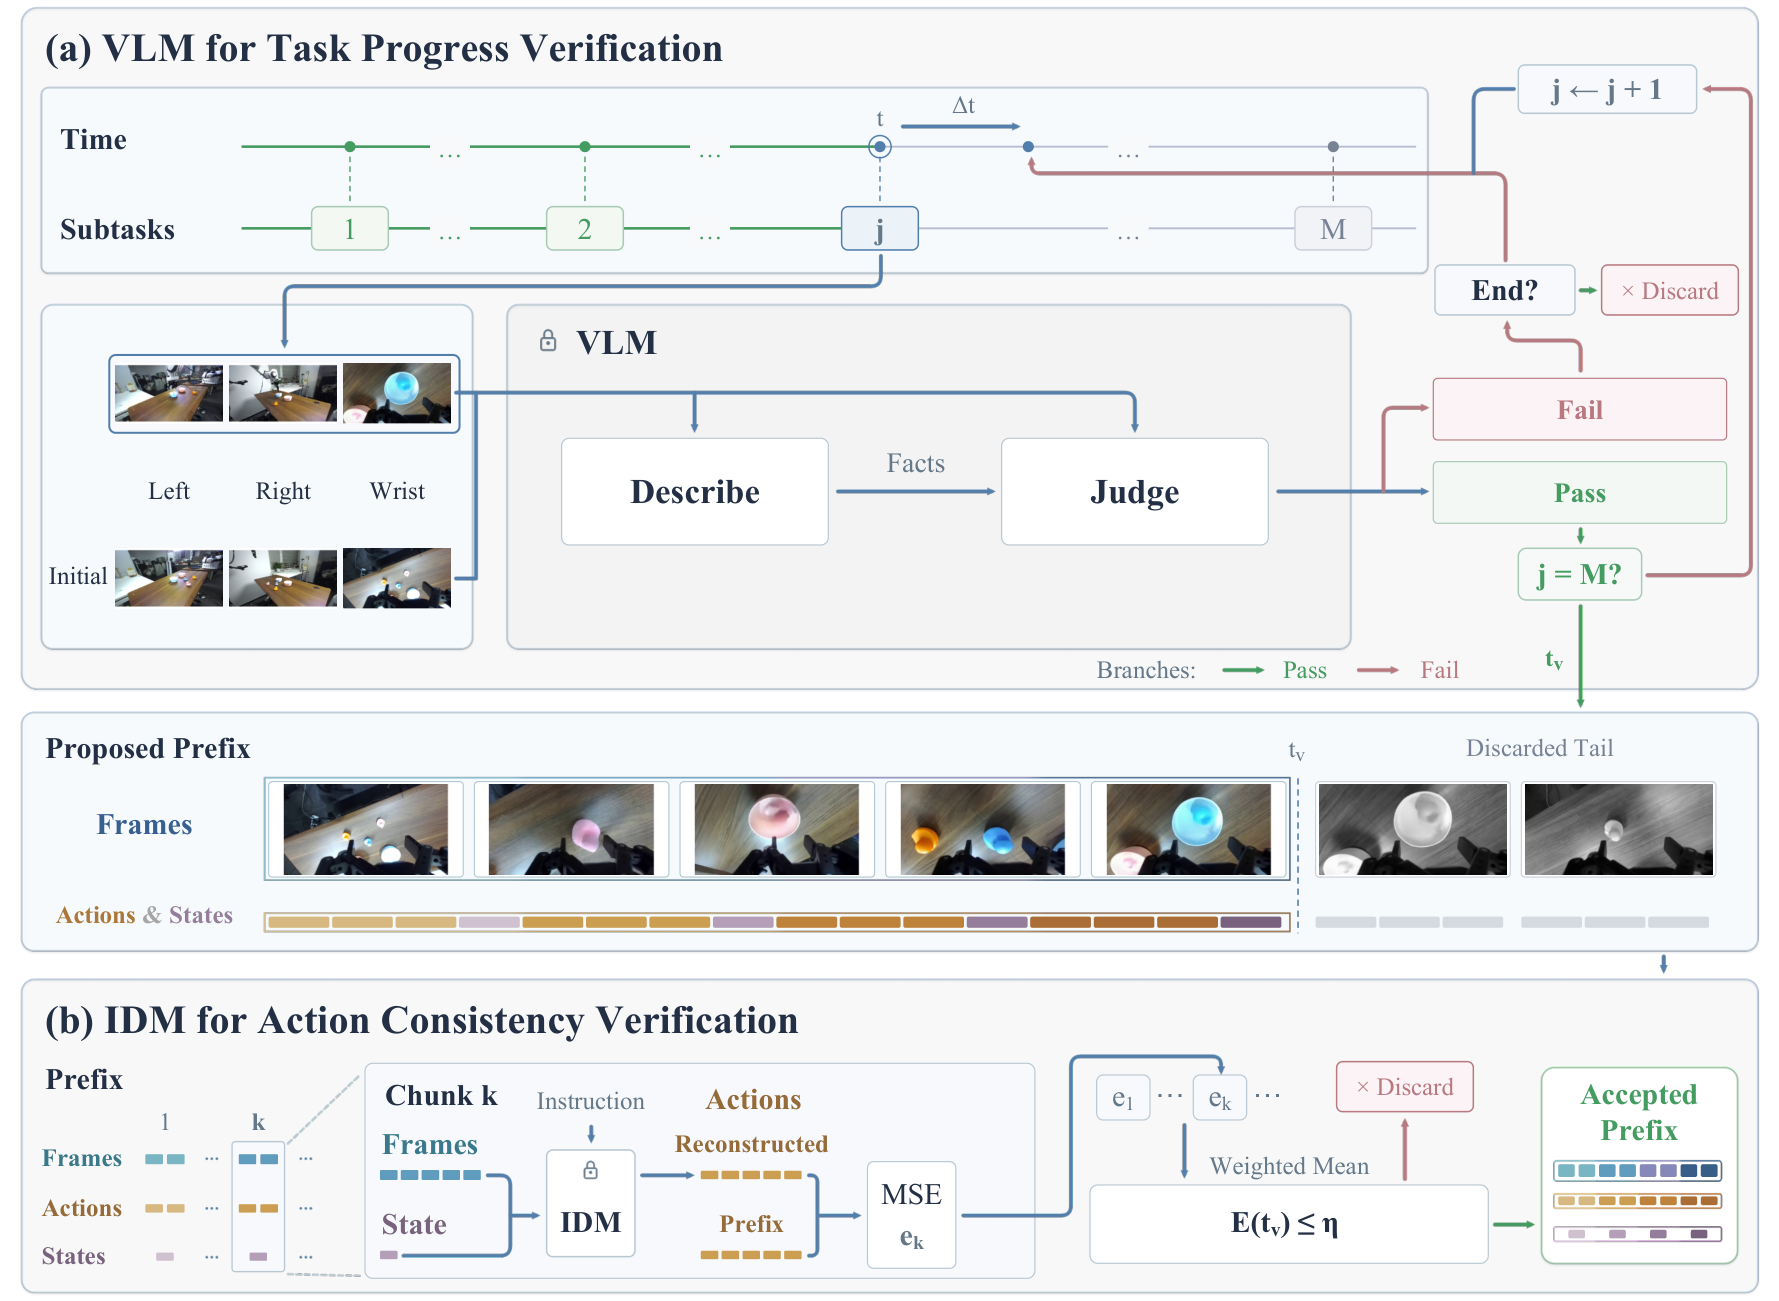
Figure 3 — 검증 단계 상세 과정
4. Conclusion & Impact (결론 및 시사점)
본 논문은 비디오 사전 지식과 검증 메커니즘을 결합하여 WAM이 스스로 진화할 수 있는 강력한 Self-Training 프레임워크를 구축하였습니다. 외부 환경의 시행착오 없이 VLM과 IDM만으로 신뢰성 있는 데이터를 확보하는 기법은 로봇 학습의 확장성 측면에서 중요한 이정표를 제시합니다. 본 연구는 다양한 WAM 백본과 과제에서 일관된 성능 향상을 보여주며, 향후 데이터 확보가 어려운 로봇 학습 분야의 효율적인 자기 개선 모델 설계에 폭넓은 영감을 제공할 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] In-Context Robot Learning with VLM Agents
- [논문리뷰] What Makes World Action Models Generalize? An Empirical Study of Test-Time Future Modeling
- [논문리뷰] Tactile-JEPA: Topology-Aware Self-Supervised Representation Learning for Distributed Tactile Sensors
- [논문리뷰] InternW0-Δ: A World Action Model Bridging Predictive Dynamics and Actions with 20K+ Hours of Open Data
- [논문리뷰] RoboFollow: Unveiling the Instruction Following Mirage in Embodied Agents
Review 의 다른글
- 이전글 [논문리뷰] CrossBFM: Distilling a Shared Latent Behavior Space Across Humanoid Embodiments
- 현재글 : [논문리뷰] EVO-WAM: Evolving World Action Models through Video-Action Verification
- 다음글 [논문리뷰] EasyPPO: Stabilizing the Critic Is Key
댓글