[논문리뷰] Context Language Models
링크: 논문 PDF로 바로 열기
저자: Rulin Shao, Shannon Zejiang Shen, Junjie Oscar Yin, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Context Language Models (CLMs): 컨텍스트를 하나의 '파일'로 취급하여 모델이 직접 읽고 쓰는(read/write) 방식을 통해 컨텍스트를 관리하는 모델 프레임워크입니다.
- Suffix Cache Reuse (SCR): 컨텍스트 내의 수정 사항이 발생했을 때, 접두사(prefix)뿐만 아니라 수정 이후의 유지되는 접미사(suffix)의 캐시 상태까지 재사용하여 서버 측 컴퓨팅 비용을 절감하는 최적화 기법입니다.
- Prefix-reuse FLOPs: 모델의 추론 비용을 측정하는 지표로, 컨텍스트가 수정된 후 발생하는 re-prefilling 비용을 포함하여 Trajectory 전체의 효율성을 평가합니다.
- ContextBench: 컨텍스트 관리 능력을 추론 및 지식 능력과 분리하여 독립적으로 평가하기 위한 4가지 합성 태스크 기반의 진단 벤치마크입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존의 LLM은 컨텍스트 관리를 외부의 하드코딩된 Harness나 제한된 Action Space에 의존하여 수행해 왔습니다. 이러한 방식은 복잡하고 긴 호라이즌을 가진 태스크에서 모델이 능동적으로 정보를 유지하거나 편집하는 데 한계를 보입니다. 특히 기존의 고정된 전략들은 Needle Retention이나 Sudoku Sketchpad 같은 태스크에서 정보 소실이나 비효율적인 리소스를 발생시킵니다 [Figure 2]. 따라서 본 연구는 모델이 스스로 컨텍스트를 관리하게 함으로써 보다 적응력 있고 효율적인 최적화 전략이 Emergent하게 나타나도록 하는 것을 목표로 합니다.
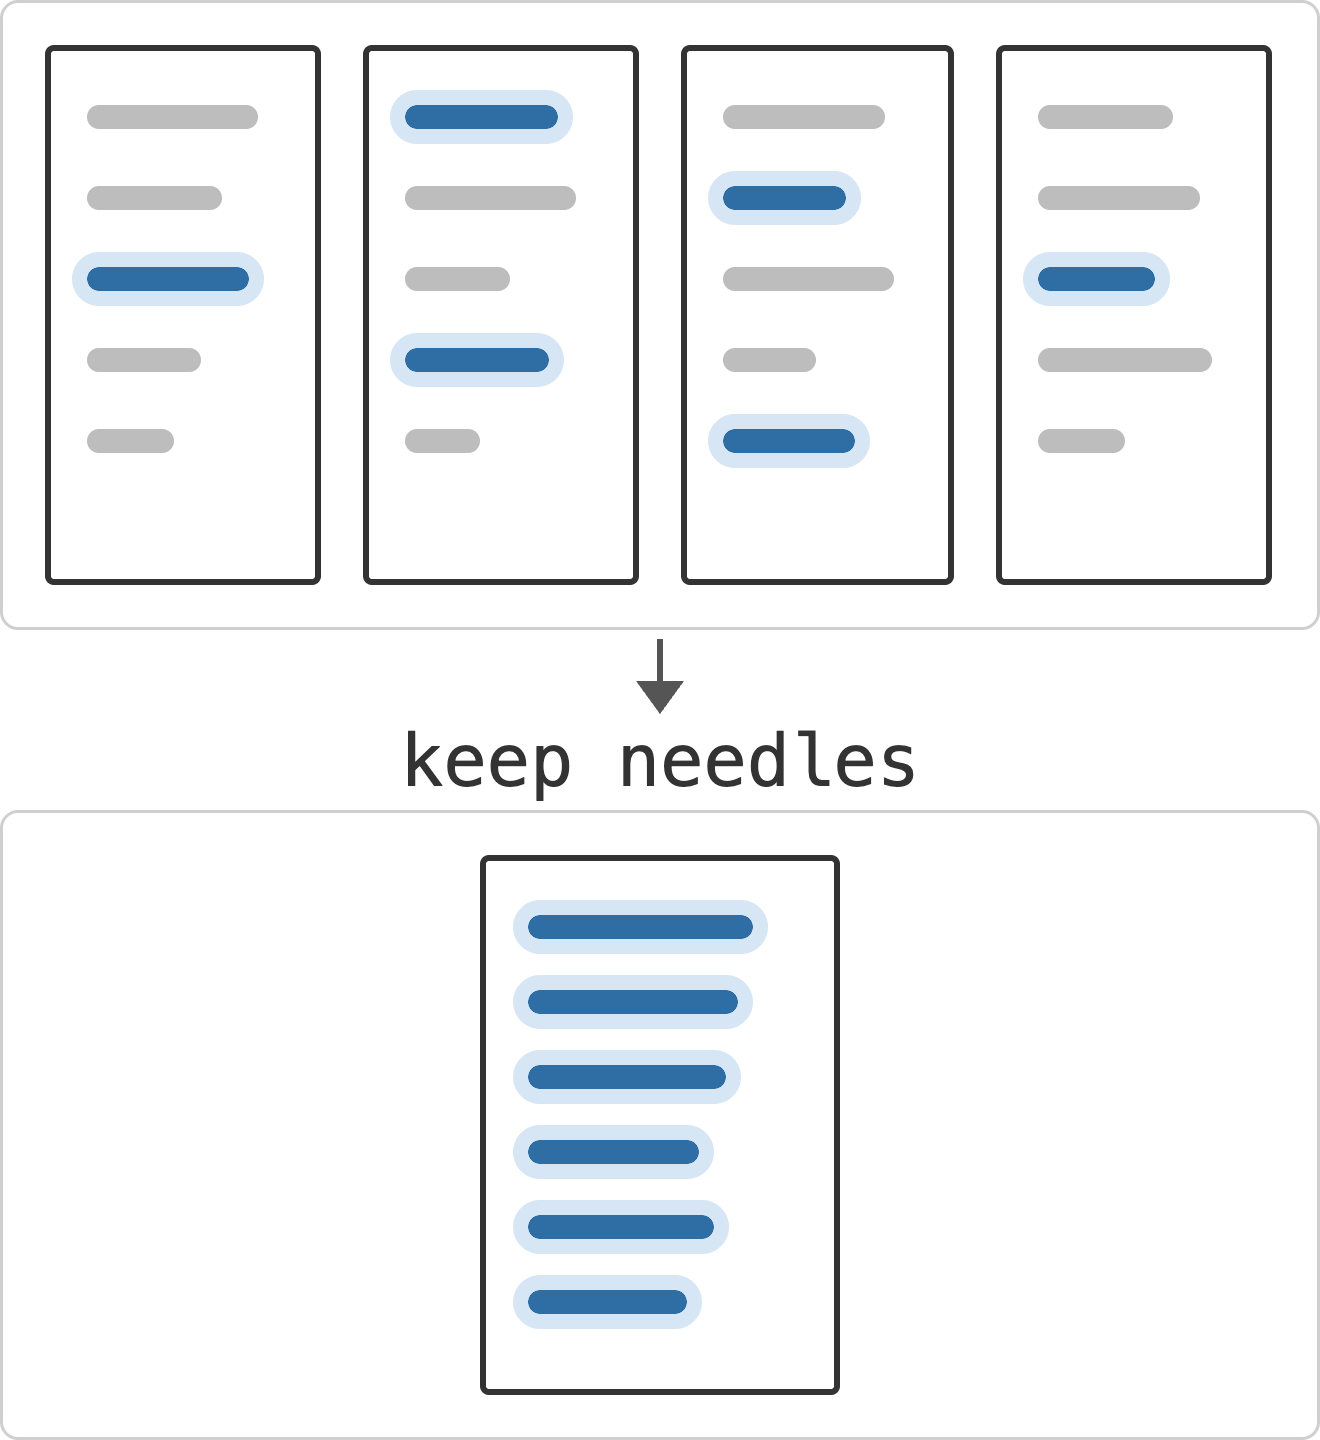
Figure 2 — ContextBench 벤치마크 태스크
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 컨텍스트를 파일 시스템처럼 구조화하여 모델이 Bash 커맨드를 통해 자유롭게 컨텍스트를 편집할 수 있도록 구현한 CLMs를 제안합니다. CLMs는 In-context learning을 통해 지시 사항을 학습하거나, Stepwise GRPO 및 Success-gated efficiency advantage를 이용한 Reinforcement Learning으로 컨텍스트 관리 전략을 내재화할 수 있습니다 [Figure 1, Figure 3]. 또한, 제안된 Suffix Cache Reuse (SCR) 기법은 컨텍스트 수정 시 유지되는 접미사 캐시를 재활용하여 서버 비용을 효율적으로 제어합니다 [Figure 4].
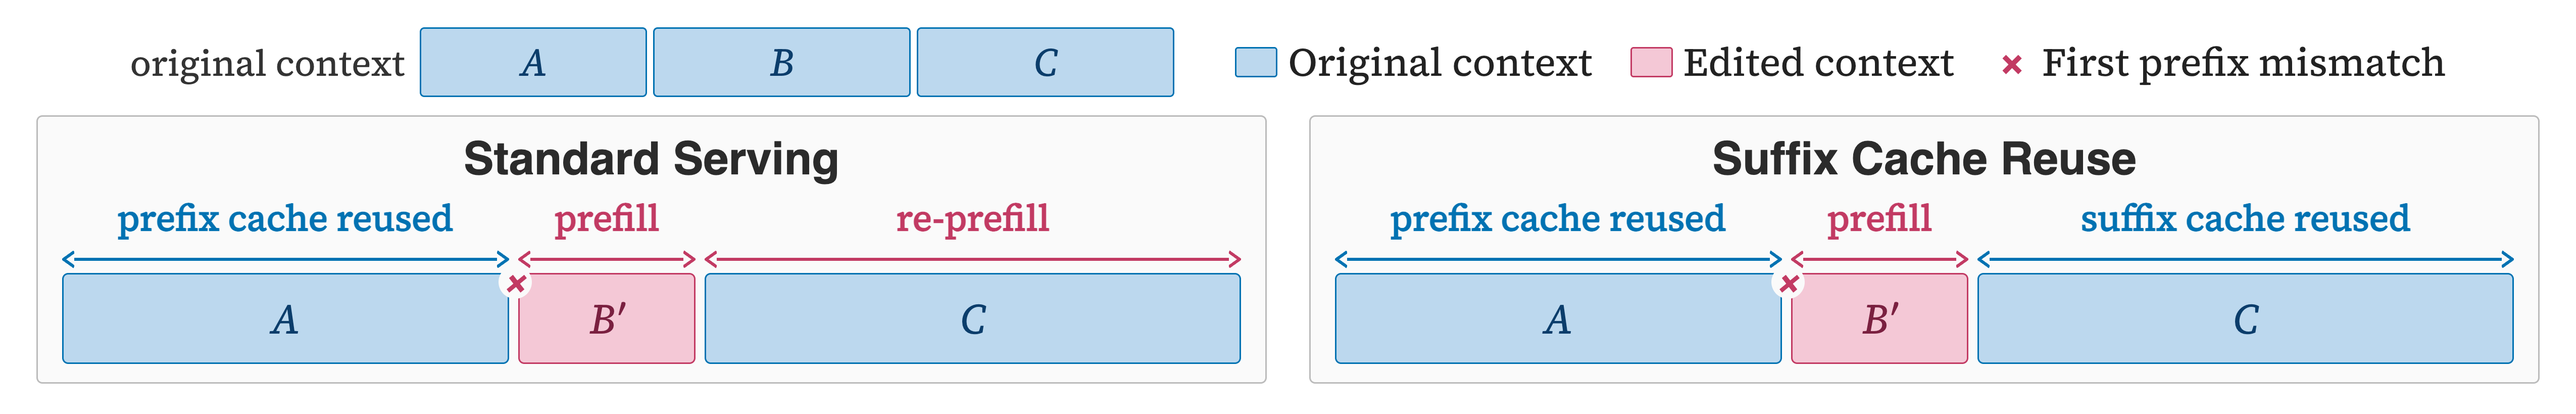
Figure 4 — Suffix Cache Reuse 구조
실험 결과, CLMs는 다양한 벤치마크에서 기존 SOTA 대비 우수한 성능과 효율성을 입증했습니다. BrowseComp-Plus 태스크에서 CLMs는 최고 성능 대비 11.4% 더 높은 정확도와 21.5% 적은 Prefix-reuse FLOPs를 기록했습니다. 또한 12시간 EdgeBench에서는 5% 더 높은 스코어를 달성함과 동시에 컴퓨팅 자원을 59% 절감했습니다 [Figure 8]. 더불어 Suffix Cache Reuse 적용 시 표준 SGLang 대비 서버 측 컴퓨팅 비용을 35% 추가로 감소시키는 성과를 보였습니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 컨텍스트 관리를 외부 제어에서 모델 내재적 역량으로 전환함으로써 대규모 에이전트 시스템의 효율성을 극대화할 수 있음을 입증했습니다. CLMs는 단순한 정확도 향상을 넘어, 복잡한 다중 에이전트 협업 및 장기 프로젝트 관리에서 필수적인 자원 효율성을 동시에 해결하는 혁신적인 방향성을 제시합니다. 향후 이 연구는 모델이 더 긴 컨텍스트를 효과적으로 처리해야 하는 엔터프라이즈 환경 및 고도화된 자율 에이전트 시스템 개발에 중요한 학술적·기술적 토대가 될 것입니다.
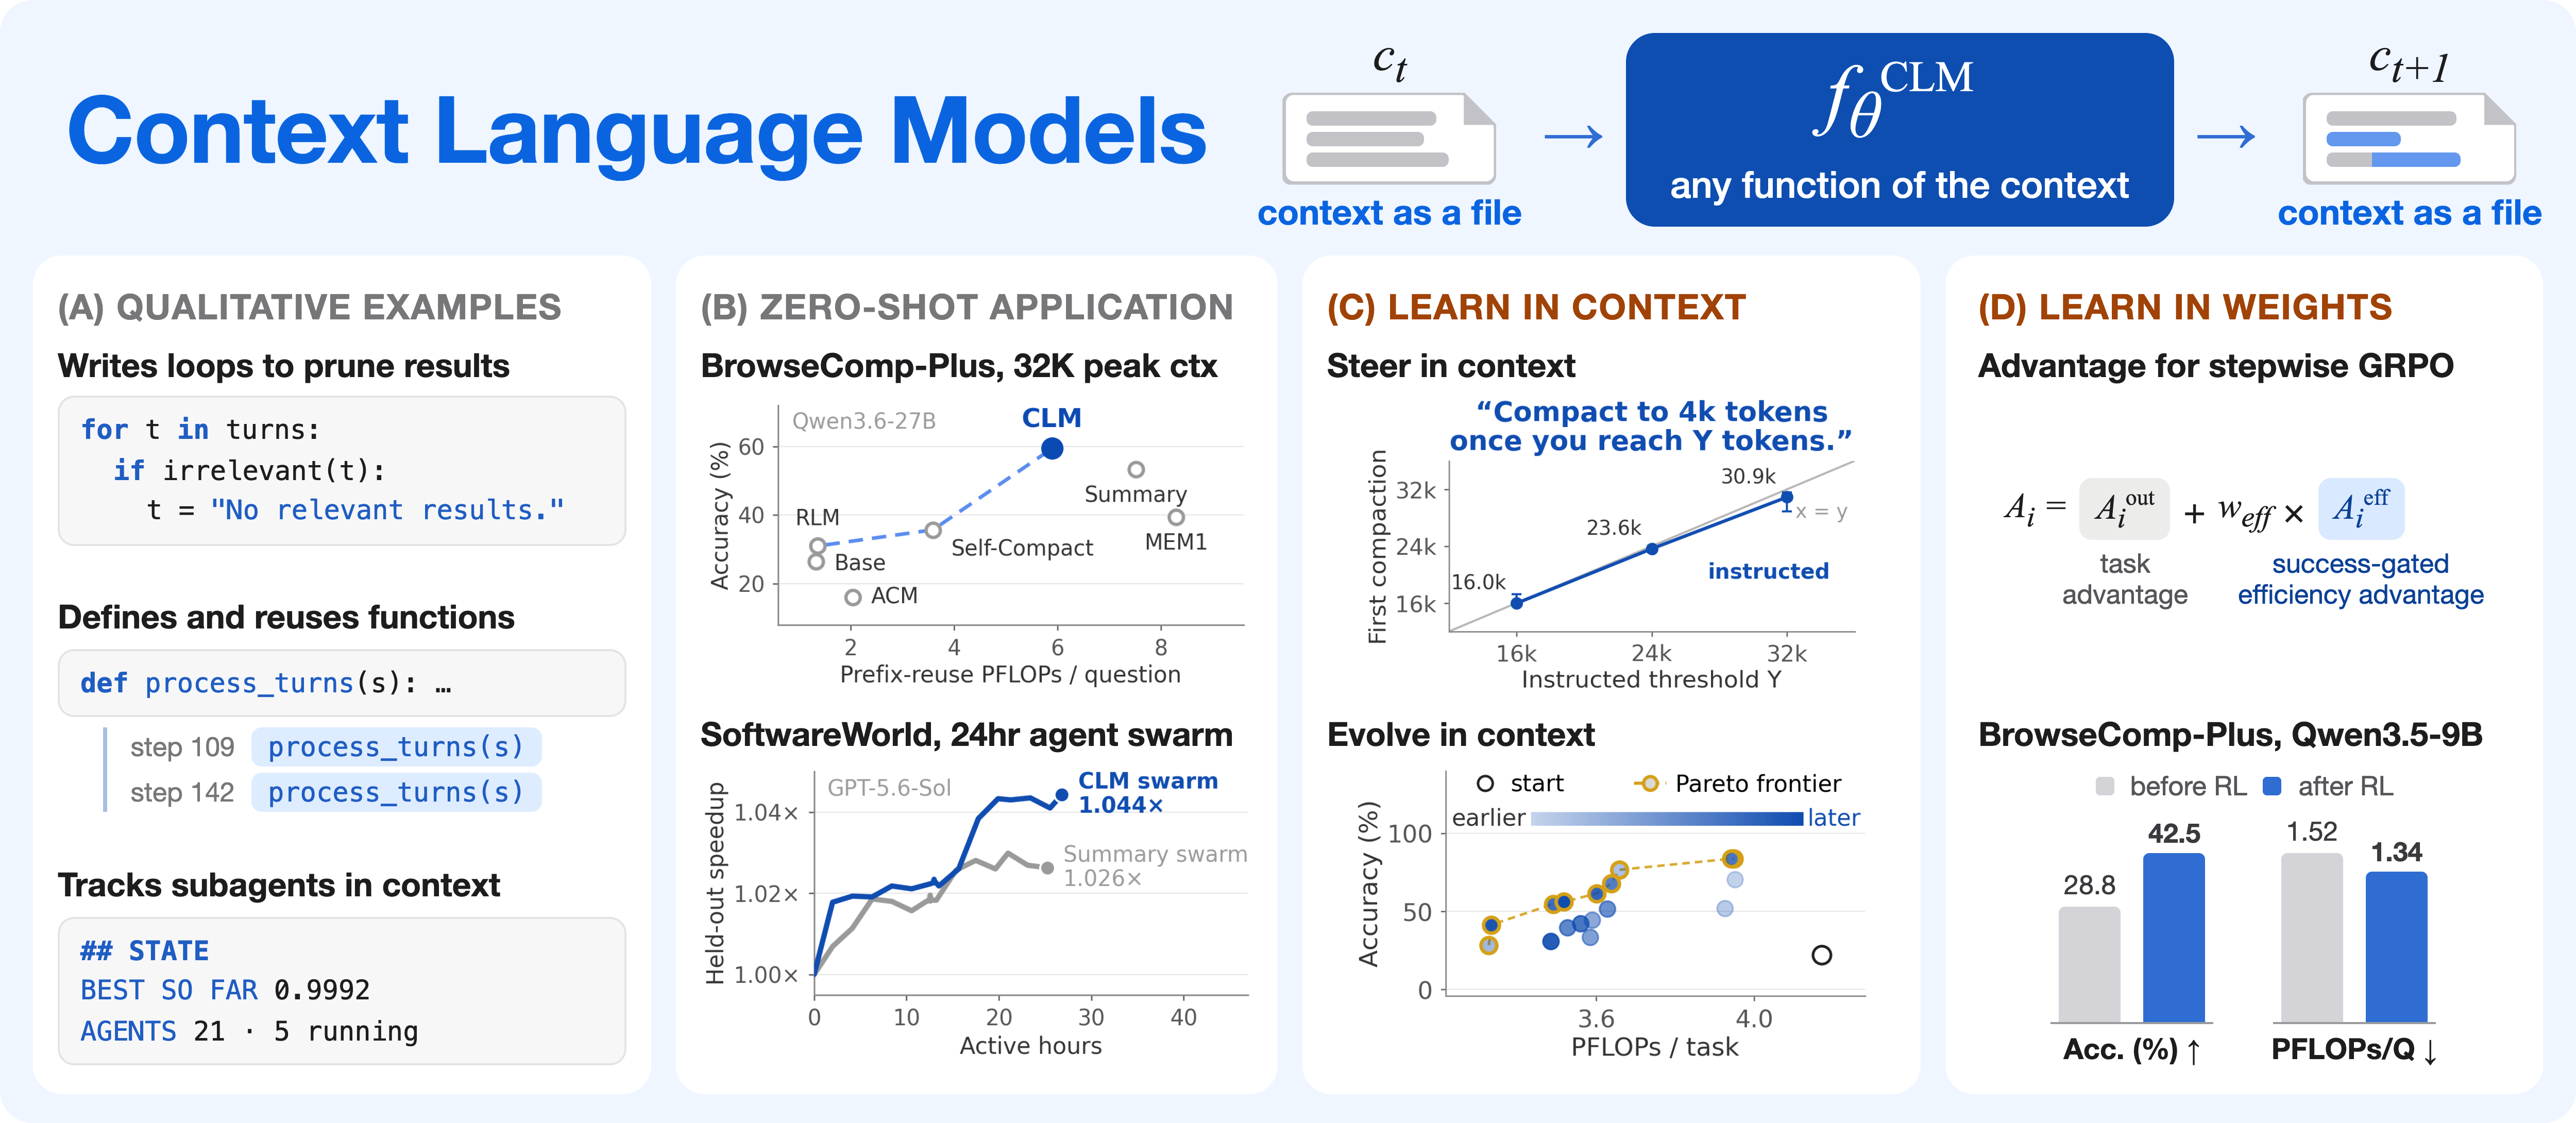
Figure 1 — CLMs 개요 및 주요 장점
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Iris: Climbing to the Search Frontier
- [논문리뷰] QUEST: Training Frontier Deep Research Agents with Fully Synthetic Tasks
- [논문리뷰] RewardHarness: Self-Evolving Agentic Post-Training
- [논문리뷰] Act Wisely: Cultivating Meta-Cognitive Tool Use in Agentic Multimodal Models
- [논문리뷰] In-Context Reinforcement Learning for Tool Use in Large Language Models
Review 의 다른글
- 이전글 [논문리뷰] Chinese-Jev: Bringing System One Model to Chinese-Language Tasks
- 현재글 : [논문리뷰] Context Language Models
- 다음글 [논문리뷰] CrossBFM: Distilling a Shared Latent Behavior Space Across Humanoid Embodiments
댓글