[논문리뷰] ProVe: Proposer-Verifier Decoding
링크: 논문 PDF로 바로 열기
저자: Ziqi Jin, Weiwen Xu, Jiaxi Li, Yujie Zhong, Qi She, Aixin Sun
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- ProVe (Proposer-Verifier Decoding): 대형 모델이 다수의 토큰을 하나의 블록으로 제안하고, 이를 별도의 verifier가 검증하여 커밋하는 방식의 추론 가속 기법입니다.
- Block Proposal: 한 번의 forward pass를 통해 여러 미래 토큰에 대한 분포를 생성하는 기법으로, MARS를 기반으로 합니다.
- ProVe-lossless: Proposer 모델이 자기 자신의 제안을 직접 검증하여, greedy AR decoding과 동일한 출력을 보장하면서 가속을 달성하는 설정입니다.
- AR-matching prefix: 모델이 생성한 블록 내에서, 실제 token-by-token greedy decoding 결과와 일치하는 토큰의 길이를 의미하며 성능 최적화의 핵심 지표입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 기존 Speculative Decoding이 가진 고정된 역할 분담 모델, 즉 느린 small draft 모델과 빠른 대형 verifier 모델의 한계를 극복하고자 제안되었습니다. 기존 방식은 draft 모델의 직렬 연산 병목으로 인해 가속 효율에 제한이 있었습니다. 저자들은 대형 모델 자체가 한 번의 forward pass로 다수의 토큰을 제안(Block Proposal)할 수 있다면, 굳이 작은 draft 모델을 사용할 필요가 없다는 점에 주목했습니다. 이를 통해 추가적인 draft head 학습 없이, 제안된 블록을 검증하는 별도의 가볍고 효율적인 pass를 추가함으로써 전반적인 추론 처리량(Throughput)을 극대화하고자 합니다.
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 논문은 Qwen2.5-32B-Instruct 모델을 block-proposing proposer로 fine-tuning하고, verifier의 역할을 수행할 작은 모델을 활용하여 ProVe 프레임워크를 구성합니다. Proposer는 [MASK] 토큰을 활용한 single causal forward pass를 통해 16개의 토큰 블록을 제안하며, verifier는 제안된 trajectory를 읽고 검증하여 최종적으로 커밋할 prefix의 길이를 결정합니다 [Figure 2]. 주요 실험 결과, ProVe-lossless는 별도의 draft head 없이도 기존 greedy AR decoding 대비 평균 **2.54×**의 처리량 향상을 달성했습니다 [Table 1]. 또한, 3B 크기의 verifier를 사용하는 ProVe는 **2.72×**의 높은 평균 처리량을 보이면서도, 정확도 측면에서 AR 대비 -2.6 포인트 이내의 제어 가능한 오차 범위를 유지하며 우수한 속도-정확도 trade-off를 입증했습니다 [Table 1], [Figure 5].
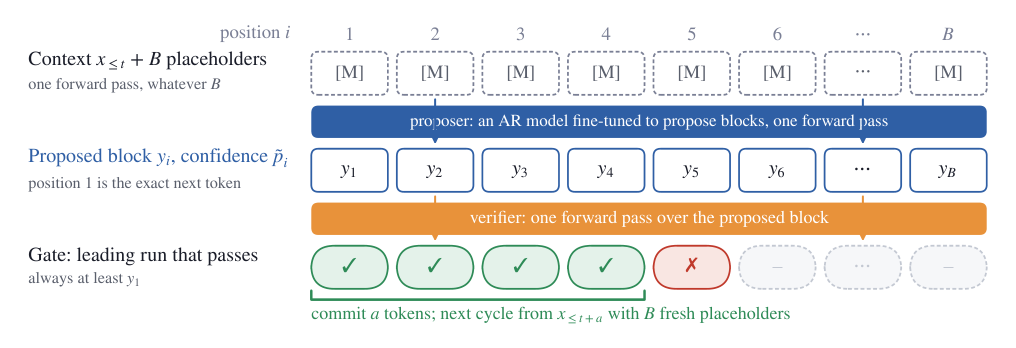
Figure 2 — ProVe의 제안 및 검증 프로세스를 설명하는 핵심 아키텍처 다이어그램
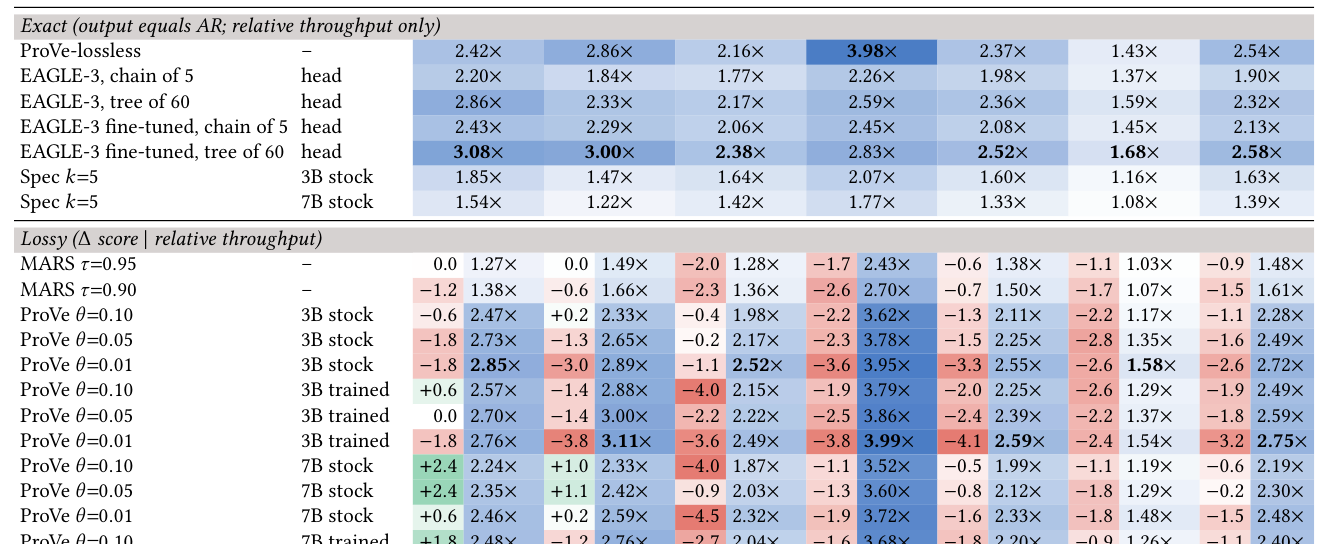
Table 1 — 다양한 벤치마크 환경에서 각 방법론의 처리량 및 정확도 성능을 비교한 핵심 테이블
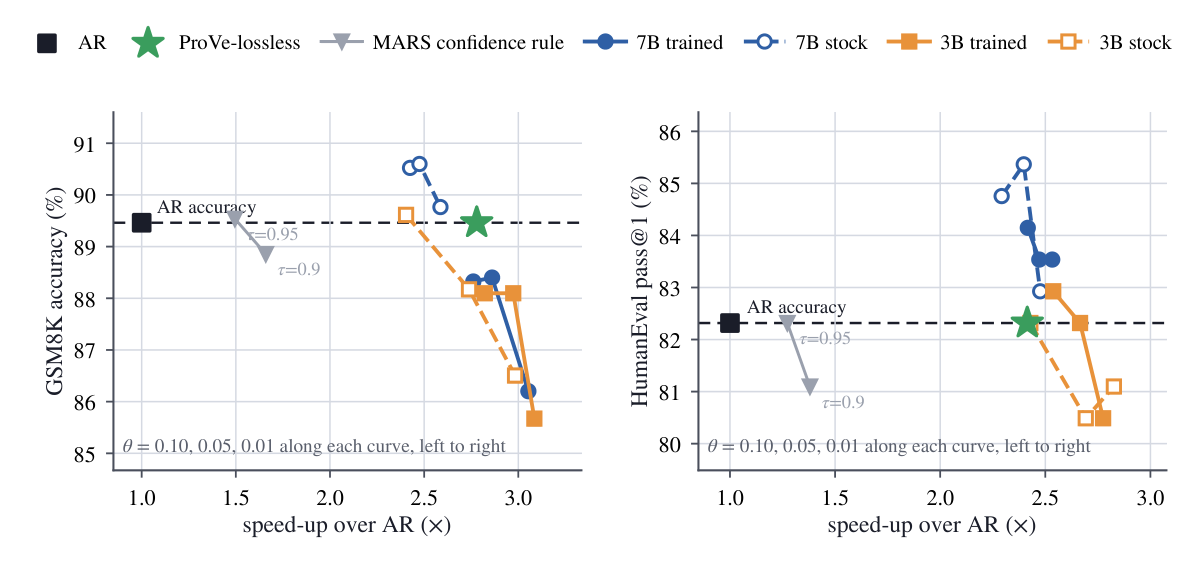
Figure 5 — 다양한 설정에 따른 속도와 정확도의 Trade-off를 시각화한 핵심 그래프
## 4. Conclusion & Impact (결론 및 시사점) 본 연구는 블록 제안과 검증 과정을 재구성하여, 대형 언어 모델의 추론 가속화에서 전통적인 speculative decoding의 역할 분담이 필수적이지 않음을 입증했습니다. 제안된 ProVe는 별도의 draft network 학습 없이도 강력한 성능 향상을 제공하며, 특히 ProVe-lossless 설정을 통해 정확도 손실 없는 가속이 가능함을 보여주었습니다. 이러한 결과는 향후 더 긴 문맥이나 복잡한 추론 작업에서 모델의 효율적인 배포와 운영을 위한 새로운 설계 방향성을 제시할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] On the SPOT: Enhancing Speculative Decoding for Diffusion Language Models via Commit-Order Prediction
- [논문리뷰] DLite: History-free Speculative Decoding for Agentic AI
- [논문리뷰] PreSTO: Predictive Subtree Prefetching for Fast LLM Power Sampling
- [논문리뷰] Contextual Correction of Parallel Draftsfor Speculative Decoding
- [논문리뷰] Unlocking Lossless Speedups in LLMs via Discrete Diffusion
Review 의 다른글
- 이전글 [논문리뷰] PhotoGuider: Composition-Aware Cropping and 360^{circ} View Framing with Explainable Photographic Assessments
- 현재글 : [논문리뷰] ProVe: Proposer-Verifier Decoding
- 다음글 [논문리뷰] Reviso: Not All Visual Evidence Deserves Equal Attention in Video Captioning
댓글