[논문리뷰] Unlocking Lossless Speedups in LLMs via Discrete Diffusion
링크: 논문 PDF로 바로 열기
저자: Subham Sekhar Sahoo, Lingjie Chen, Khiem Pham, Jonathan Geuter, Chaitanya Dwivedi, Varad Pimpalkhute, Yash Akhauri, Alexander Moreno, Mikhail Yurochkin, Zhenting Wang, Mostafa Elhoushi, Nolan Dey, Shane Bergsma, Joel Hestness, John Thickstun, Eric Xing, Zhengzhong Liu
1. Key Terms & Definitions
- Diffusion-augmented LLMs (Uno): Autoregressive (AR) model의 품질과 Discrete Diffusion의 병렬 생성 능력을 통합한 새로운 LLM 클래스로, AR weights는 응답 품질을, diffusion weights는 생성 속도를 담당한다.
- Discrete Diffusion: 순차적인 토큰 생성 대신 여러 토큰을 병렬로 생성하도록 훈련된 모델로, 노이즈가 있는 시퀀스에서 깨끗한 토큰을 예측한다.
- Ψ-Spec Sampler: Diffusion-augmented LLM에서 Lossless, AR-verified Acceleration 및 Inference-time Scaling을 가능하게 하는 샘플러 패밀리이다.
- Diffusion Distillation: 기존 LLM training pipeline에 미미한 오버헤드만 추가하여 diffusion weights를 훈련하는 단계로, 여러 토큰을 동시에 생성하는 것을 목표로 한다.
- Tokens-Per-Forward-pass (TPF): 단일 forward pass 당 모델이 생성하고 AR verifier에 의해 수락된 토큰의 평균 개수를 측정하는 지표로, 생성 속도를 나타낸다.
2. Motivation & Problem Statement
본 논문은 Autoregressive (AR) Large Language Models (LLMs)의 핵심 bottle-neck인 느린 순차적 토큰 생성을 해결하고자 한다. 기존 AR LLMs는 한 번에 하나의 토큰만 생성하므로 추론 시 높은 Latency를 유발하고 GPU utilization을 저하시킨다. Speculative Decoding과 같은 기존 가속화 방법들은 별도의 draft model을 필요로 하며, 큰 batch size에서는 speedup이 감소하는 한계를 가진다. 또한, 기존 Diffusion LLMs (d-LLMs)는 종종 품질-속도 Trade-off를 겪거나, AR 모델의 Distribution을 Lossless하게 유지하지 못하고, 큰 batch size에서 speedup이 사라지는 문제가 있었다. 이러한 한계점들로 인해 agentic workload와 같이 동시 요청이 많은 실제 LLM 애플리케이션에서는 실질적인 가속 효과를 얻기 어려웠다.
3. Method & Key Results
저자들은 AR 모델의 품질을 희생하지 않으면서 Lossless speedup을 제공하는 Diffusion-augmented LLMs (Uno) 프레임워크를 제안한다. Uno는 단일 아키텍처 내에서 AR weights (표준 NTP objective로 훈련되어 응답 품질 결정)와 diffusion weights (경량화된 LoRA adapters로 구현되며, 병렬 토큰 생성을 위해 훈련됨)를 분리하여 사용한다. Diffusion Distillation 단계에서 AR weights를 고정하고 diffusion weights를 학습시켜, 병렬 토큰 생성을 위한 능력을 부여한다. 이 과정은 기존 LLM training pipeline에 미미한 오버헤드를 추가한다. 추론 시에는 Ψ-Spec Sampler가 diffusion pathway를 통해 토큰 블록을 병렬로 제안하고, AR weights가 이 제안을 Lossless하게 검증하여 AR 모델의 output distribution을 정확히 보존한다. 이는 별도의 draft model이 필요 없는 self-speculative decoding 방식의 개선된 형태이다.
핵심 실험 결과, Uno는 모든 평가 batch size에서 base AR model 대비 최대 3x의 speedup을 달성했으며, 주요 speculative decoding 방법론인 EAGLE-3 및 DFlash보다 높은 throughput을 보였다 [Figure 1, Figure 2]. 특히, 최대 batch size에서 1.5x 이상의 speedup을 기록하여 multi-user serving 및 RL post-training에 효과적임을 입증했다. 또한, 8B Uno 모델은 agentic tool use, coding, long-context reasoning 벤치마크에서 26B DiffusionGemma 및 proprietary Mercury 2와 같은 선도적인 open d-LLM들을 능가하는 성능을 보였다 [Figure 1, Table 1]. 예를 들어, Uno의 System Throughput은 5255 tokens/sec로, DiffusionGemma (1136 tokens/sec) 및 Mercury 2 (1197 tokens/sec)보다 현저히 높았다. 또한, Uno는 EAGLE-3 (0.40B)나 DFlash (1.05B) 대비 더 적은 추가 파라미터(약 0.35B)를 사용하며 shared draft-verifier KV cache를 통해 peak memory usage를 줄이는 이점을 제공한다 [Table 2].
4. Conclusion & Impact
본 연구는 Diffusion-augmented LLMs (Uno)라는 새로운 LLM 프레임워크를 성공적으로 도입하여, AR 모델의 강점인 고품질 생성과 Discrete Diffusion의 병렬 처리 능력을 결합함으로써 Lossless speedup을 달성한다. 이 접근 방식은 기존 AR LLMs의 느린 순차적 생성이라는 근본적인 한계를 극복하며, Speculative Decoding과 같은 기존 방법들의 단점(별도 draft model 필요, batch size에 따른 speedup 감소)을 해결한다. Uno는 AR 모델의 distribution을 Lossless하게 보존하면서도 높은 throughput을 제공하여 low-latency inference, high-throughput serving, 그리고 RL post-training의 가속화에 크게 기여한다. 이는 LLM의 효율성과 확장성을 개선하여 LLM 애플리케이션의 광범위한 배포와 활용에 중요한 영향을 미칠 것으로 예상된다.
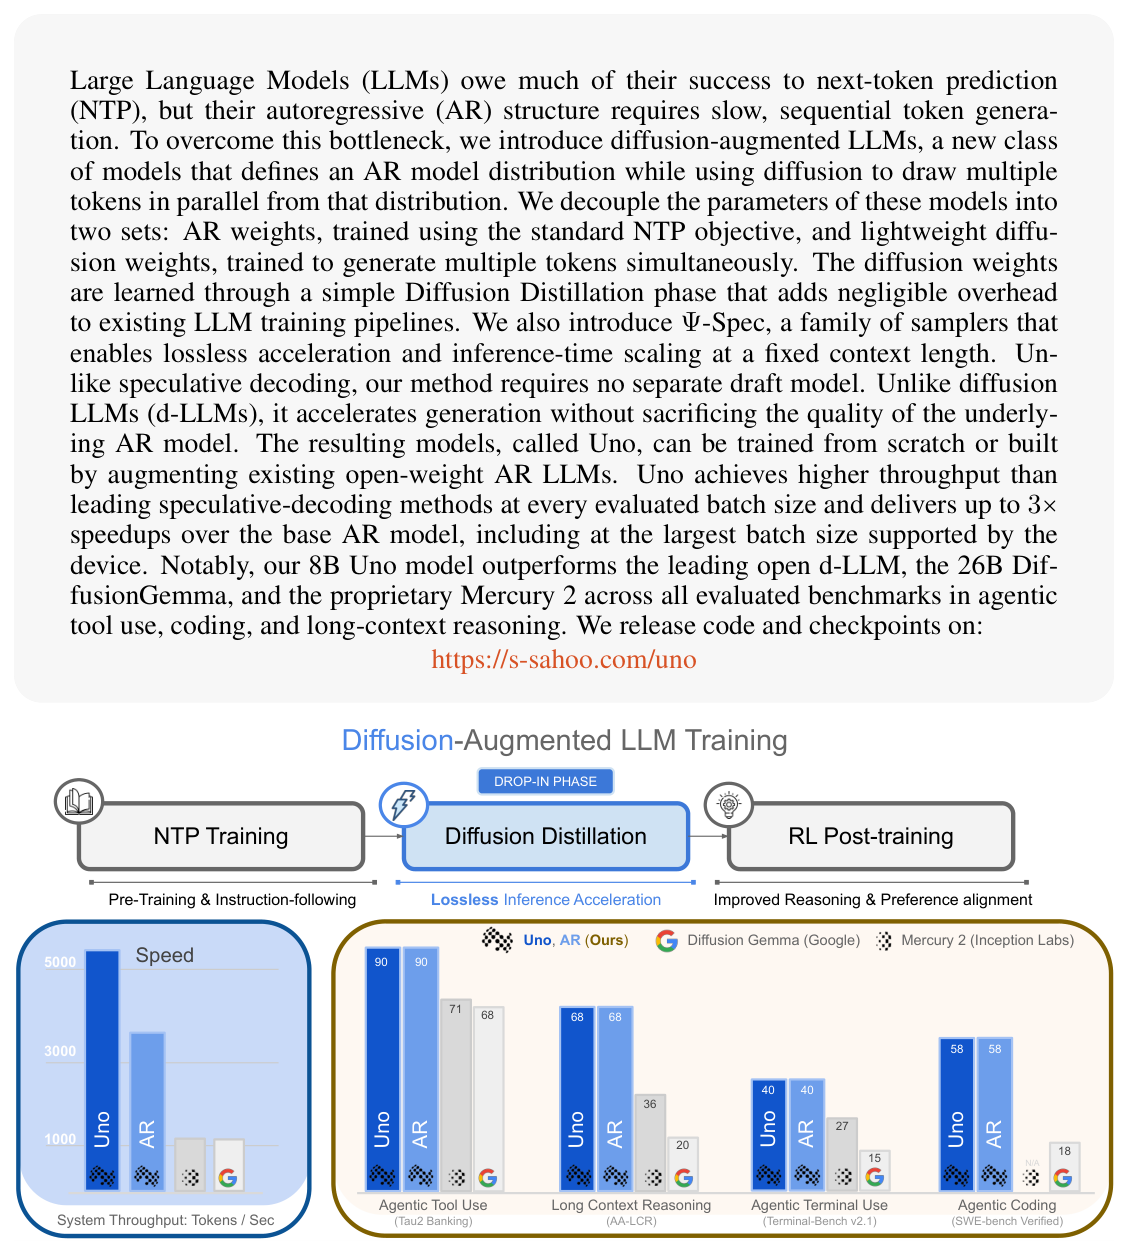
Figure 1 — Diffusion-augmented LLM의 전체 training pipeline 및 주요 성능 비교 결과
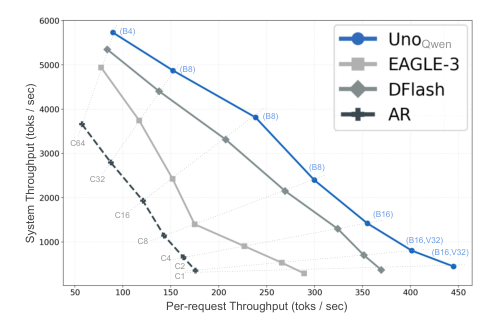
Figure 2 — 다양한 batch size에서의 시스템 및 요청당 throughput을 시각적으로 비교하여 Uno의 우수성 강조
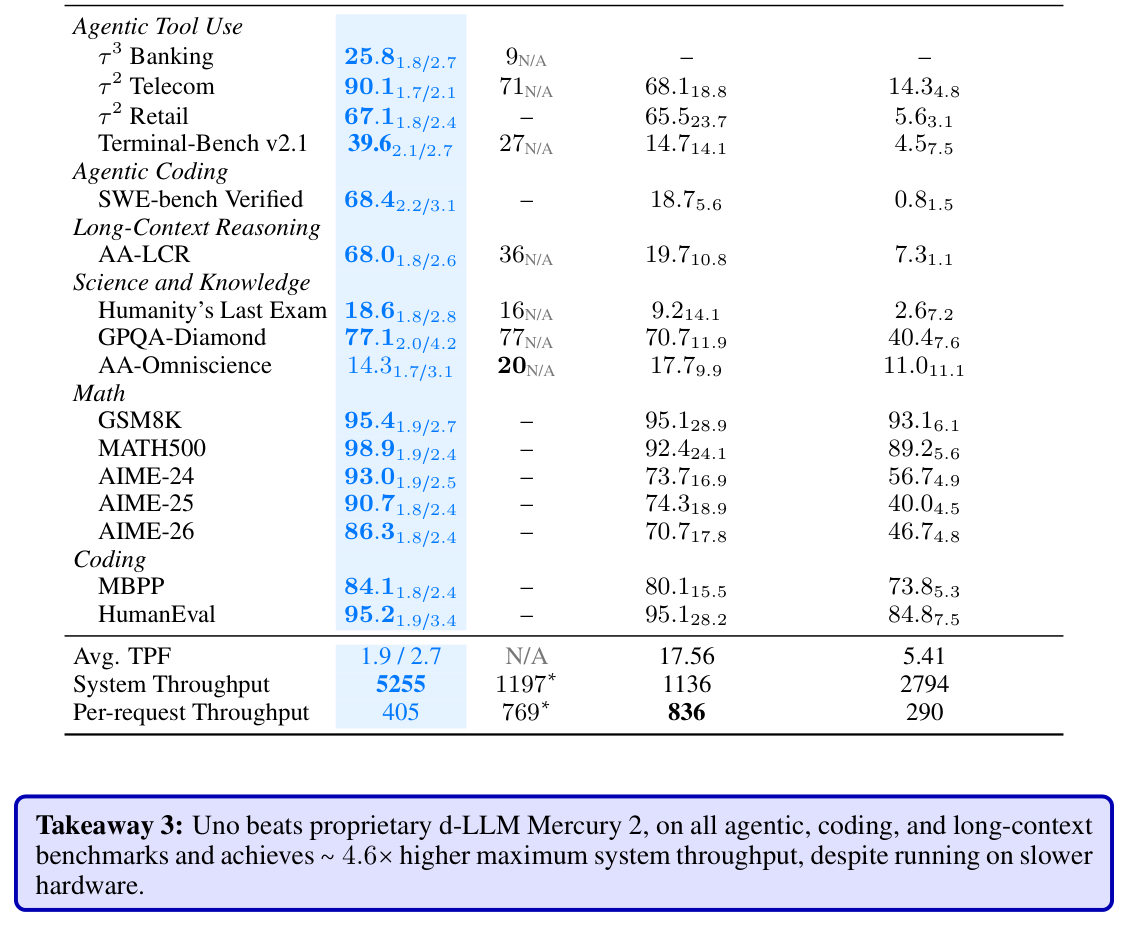
Table 1 — 다양한 벤치마크에서의 정확도(Accuracy) 및 Tokens-Per-Forward-pass (TPF)를 통한 모델 성능의 정량적 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Speculative Pipeline Decoding: Higher-Accruacy and Zero-Bubble Speculation via Pipeline Parallelism
- [논문리뷰] Online Draft Co-Training for Speculative Decoding in Large-Scale, Long-Context RL Post-Training
- [논문리뷰] Compile by Training: Turning Natural-Language Specifications into Local Neural Functions
- [논문리뷰] Verification-Aware Training for Speculative Decoding
- [논문리뷰] Normalized Low-Rank Adaptation
Review 의 다른글
- 이전글 [논문리뷰] Unifying Conformal Language Tasks with In-Context Ensembles
- 현재글 : [논문리뷰] Unlocking Lossless Speedups in LLMs via Discrete Diffusion
- 다음글 [논문리뷰] Verify Before You Distill: Prompt-Level Teacher Gating for On-Policy Distillation
댓글