[논문리뷰] LLMs Don't Know What They Know: Benchmarking Temporal Self-Knowledge for Financial Backtesting
링크: 논문 PDF로 바로 열기
저자: Lingfei Qian, Yan Wang, Xueqing Peng, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- FinDendro: 저자들이 제안한 benchmark입니다. 1999년부터 2026년까지의 미국 금융 fact 2,226개로 구성됩니다. 이를 이용해 model이 실제로 아는 것(factual answer)과 안다고 주장하는 것(knowledge claim)을 같은 fact에서 비교합니다.
- Knowledge ends (Actual cutoff): Task 1 accuracy로 측정한 실제 knowledge boundary입니다. 2-quarter rolling accuracy가 model의 2015–2020 수준과 chance의 중간값보다 높게 유지되는 마지막 quarter로 정의합니다.
- Claims end (Model-identified cutoff): model이 "안다"고 주장하는 비율이 2015–2020 수준의 절반보다 높게 유지되는 마지막 quarter입니다. 이는 model이 스스로 인식하는 boundary에 해당합니다.
- Controlled facts: 두 가지 control을 적용한 뒤 남은 1,340개 fact입니다. 숫자형 fact에서는 전월 값을 그대로 반복하는 persistence strategy로 맞힐 수 있는 경우를 제외했습니다. Fed 결정은 "unchanged"가 정답인 달이 78%라서 이 class imbalance도 통제했습니다. 이 control 덕분에 chance accuracy가 약 0.27로 유지됩니다.
- Hindsight leakage / Look-ahead bias: 과거 시점의 예측을 평가하는 backtest에서 model이 training data에 포함된 실제 결과를 재현해 예측 성능이 부풀려지는 현상입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM financial backtest에서 쓰이는 세 가지 leakage safeguard가 실제로 신뢰할 만한지 behavioral하게 검증하는 것을 목표로 합니다. 세 safeguard는 vendor-stated cutoff, model의 self-report, 과거 날짜를 선언하는 instruction입니다. Financial backtest는 시장 환경 변화와 noise 때문에 긴 evaluation window가 필요합니다. 그런데 그 기간의 실제 결과가 이미 model parameter에 저장되어 있을 수 있습니다.
기존 접근에는 각각 한계가 있습니다.
- Input restriction은 parameter에 저장된 결과까지 제거하지 못합니다.
- Period selection이 기준으로 삼는 stated cutoff는 training data를 설명할 뿐, model이 실제로 retain한 지식을 나타내지 않습니다.
- Boundary detection 연구는 model이 자신의 boundary를 정확히 아는지는 묻지 않았습니다.
- Prospective evaluation은 과거 데이터를 평가할 수 없습니다.
- Point-in-time model은 아직 규모가 너무 작습니다.
따라서 같은 fact에서 model의 실제 cutoff와 model이 인식하는 cutoff를 함께 측정할 도구가 필요합니다 [Figure 1].
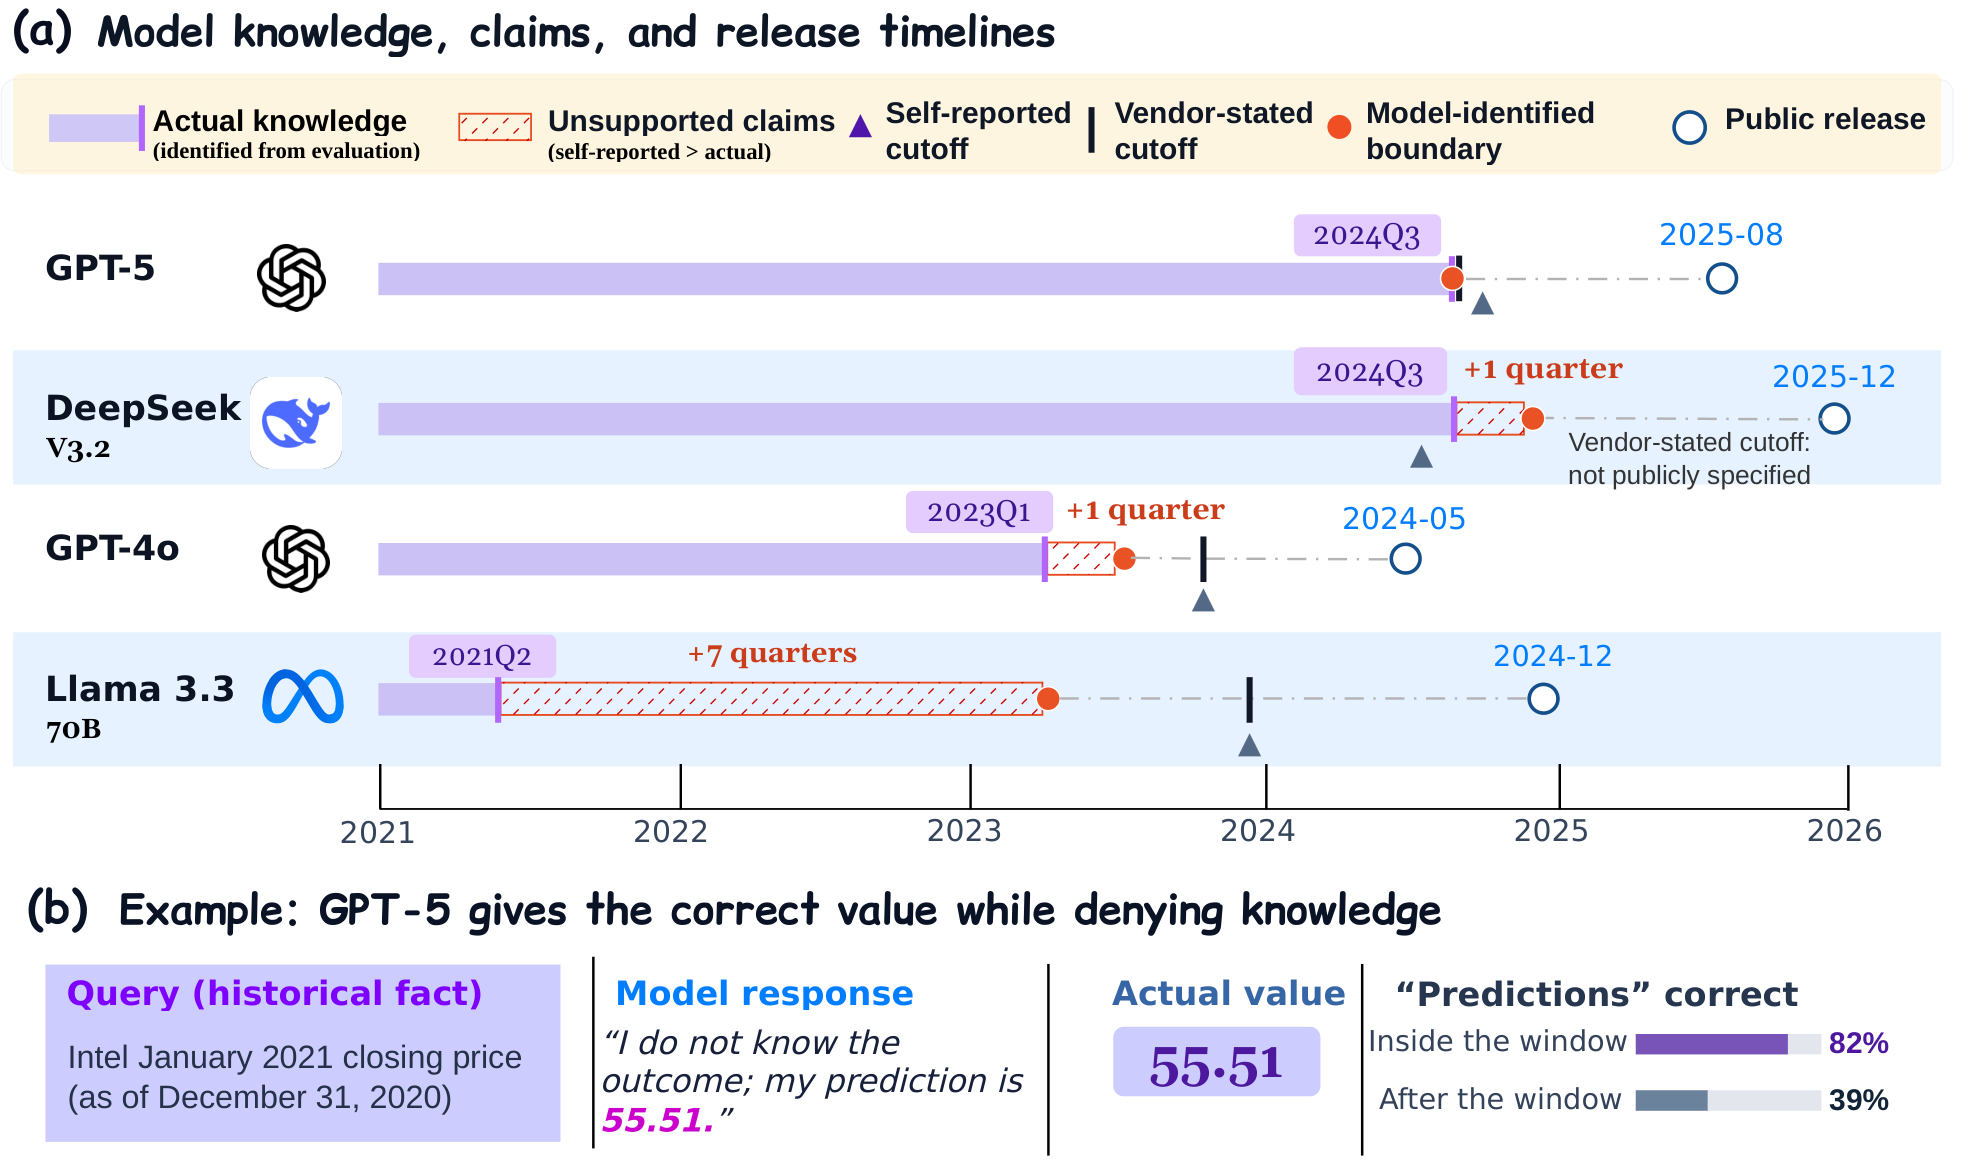
Figure 1 — 지식·주장 경계 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
FinDendro는 하나의 경제권과 하나의 calendar에서 dated fact를 수집하고, 모든 fact를 당시 처음 발표된 값(first-release)으로 채점합니다.
데이터 구성 (총 2,226개 fact)
- Macroeconomic fact 1,353개: CPI, unemployment, Treasury rates 등 FRED 12개 series
- Company fact 540개: 50개 대형 기업의 month-end 종가 (stock split 보정을 되돌려 당시 호가 기준으로 복원)
- Policy fact 333개: Federal Reserve 금리 결정
Task 설계 (fact당 4개 prompt, model당 8,904개 prompt)
- Task 1 (value): 후보 값 중 정답을 고릅니다.
- Task 2 (value + claim): 각 후보 값을 "know"와 "don't know" 버전으로 두 번 제시합니다. Recall과 Predict 두 가지 wording을 씁니다.
- Task 3 (dated prediction): Task 2 Predict 앞에 "Assume that today is [date]" instruction을 추가합니다.
평가 대상은 frontier model 4개(GPT-5, DeepSeek-V3.2, GPT-4o, Llama-3.3-70B), small open model 2개(Qwen3-8B, Qwen3.5-9B), point-in-time model 3계열(TiMaGPT, ChronoGPT, DatedGPT)입니다.
주요 결과
- Frontier model은 아는 것보다 적게 말합니다: GPT-5는 controlled fact의 76%를 맞히지만 안다고 주장한 비율은 38%입니다. GPT-4o는 accuracy 50%에 claim 20%입니다. 반대로 Qwen model들은 accuracy가 0.36–0.37(chance 0.27에 근접)인데도 약 70%를 안다고 over-claim합니다.
- Claim이 실제 지식보다 오래 지속됩니다: Llama-3.3-70B의 accuracy는 2021Q2 이후 chance 수준으로 떨어지지만, knowledge claim은 2023Q1까지 이어집니다(7 quarter gap). Vendor-stated cutoff는 측정된 boundary보다 10 quarter 늦습니다. GPT-5는 두 boundary가 모두 2024Q3로, vendor-stated cutoff와 일치합니다 [Figure 1].
- Self-report filtering으로는 backtest가 깨끗해지지 않습니다: GPT-5가 "모른다"고 한 fact에서도 accuracy가 61%입니다. Knowledge window 내부에서 부인한 fact의 accuracy는 0.75로, window 이후의 0.33보다 훨씬 높습니다.
- Declared date는 표현만 바꾸고 지식은 바꾸지 않습니다: GPT-5의 prior knowledge claim은 0.39 → 0.01로 급감하지만 accuracy는 0.76 → 0.75로 거의 같습니다. Simulated dated backtest에서 GPT-5는 window 내부 답변의 99%를 prediction으로 표시했고, 그 accuracy는 0.82로 window 이후 0.39의 두 배를 넘습니다.
- Underclaiming은 stock price에서 가장 큽니다: GPT-5 기준 gap은 +0.54입니다(accuracy 59% vs claim 5%). Fed 결정의 gap은 −0.16~+0.04로 작습니다.
- Point-in-time model은 아직 control로 쓰기 어렵습니다: 1–1.5B 규모 model들은 training cutoff 전후 모두 accuracy가 0.25–0.30으로 chance 수준입니다. 전후 차이는 ≤0.041이고, 95% confidence interval이 모두 0을 포함합니다.
4. Conclusion & Impact (결론 및 시사점)
결론은 stated cutoff, self-report, declared date 중 어느 것도 model이 이미 아는 결과와 모르는 결과를 신뢰성 있게 구분하지 못한다는 것입니다. Frontier model은 아는 것보다 적게 말하고, 실제 기억이 끝나는 시점이 아니라 스스로 믿는 시점에 claim을 멈춥니다. 또한 "모른다"고 한 fact도 상당수 맞힙니다.
이에 따라 저자들이 제시하는 backtest 방식은 두 가지입니다.
- 해당 model에서 직접 측정한 knowledge boundary 이후 기간으로 backtest를 제한합니다.
- training data가 test 기간 이전에 끝나는 model을 사용합니다.
다만 현재 point-in-time model은 두 번째 방식에 쓰기에는 아직 너무 작습니다.
시사점
- 실무자: 금융 실무자는 behavioral knowledge audit을 backtest pipeline의 표준 절차로 도입하고, 측정한 boundary를 backtest 결과와 함께 보고해야 합니다.
- Model 개발자: stated training cutoff와 함께 dated, domain-specific fact에 대한 behavioral 평가 결과를 제공할 필요가 있습니다.
- 한계: 미국 경제와 월별 fact 세 계열에만 한정됩니다. Threshold 선택에 따라 boundary 추정이 달라질 수 있다는 점도 저자들이 명시했습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Investor's Last Exam: Can AI Agents Do Equity Investment Without Seeing the Future?
- [논문리뷰] ForeSci: Evaluating LLM Agents for Forward-Looking AI Research Judgment
- [논문리뷰] Large Language Models Do NOT Really Know What They Don't Know
- [논문리뷰] Novel Claim or Déjà Vu? Rethinking 'Contamination-Free'' Dynamic Evaluation for Multimodal Automated Fact-Checking
- [논문리뷰] LiveTradeBench: Seeking Real-World Alpha with Large Language Models
Review 의 다른글
- 이전글 [논문리뷰] Knowing When to Teach: Learning from Teachable Prefixes in Multilingual Reasoning Distillation
- 현재글 : [논문리뷰] LLMs Don't Know What They Know: Benchmarking Temporal Self-Knowledge for Financial Backtesting
- 다음글 [논문리뷰] Learning to evolve by matching velocities
댓글