[논문리뷰] P^2-MOPD: Accelerating Multi-Teacher On-Policy Distillation via Parameter Priors
링크: 논문 PDF로 바로 열기
저자: Sinuo Wang, Jiacheng Lu, Zeyu Zhang, Maojia Song, Rui Sun, Beidi Luan, Yutong Xie, Jing Li, Daxin Jiang, Qi Wu, Zuo Bai
1. Key Terms & Definitions (핵심 용어 및 정의)
- MOPD (Multi-Teacher On-Policy Distillation): 각 domain의 RL-trained expert(teacher)를 하나의 generalist student로 통합하는 방법입니다. Student가 생성한 rollout을 해당 prompt domain의 teacher가 teacher forcing으로 채점하고, 이를 token-level reward로 사용합니다. Reward는 support-restricted reverse-KL 신호입니다.
- Task Vector / Task Arithmetic (TA): Task vector는 expert와 base model의 parameter 차이(τ_k = θ_k − θ_0)입니다. TA는 base model에 task vector들의 가중합을 더하는 training-free merging 방식입니다. 본 논문에서는 uniform 계수 λ_k = 1/K를 사용하며, 이렇게 얻은 merged model은 task vector들이 span하는 K차원 affine span 안에 갇힙니다.
- Parameter Priors: Frozen expert parameter를 initialization이나 1회성 merge에만 쓰지 않고, 학습 전 과정에서 student weight에 learnable하게 결합되는 사전 정보로 쓰는 개념입니다. 표현 가능한 model class는 바꾸지 않고, optimization path에만 bias를 줍니다.
- Mixing Coefficients (α) & Coefficient Granularity: 각 linear projection module m에 대해 expert k의 task vector를 얼마나 섞을지 정하는 학습 가능한 scalar α_{k,m}입니다. Granularity는 module(기본 설정), layer, model 세 수준으로 계수를 공유(tying)할 수 있습니다.
- Recovery: Domain별 성능 회복률로, (s − s_base)/(s_teacher − s_base)로 정의됩니다. 핵심 지표는 Average Recovery이고, 균형을 보는 지표로 Worst-domain Recovery와 AULC도 함께 보고합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문이 다루는 문제는 두 가지입니다. MOPD는 학습 비용이 크고 domain 간 recovery가 불균형하며, Task Arithmetic은 output이 supervision을 받지 않아 품질이 보장되지 않습니다. MOPD는 매 step마다 student rollout을 sampling하고 teacher forcing으로 label을 만들어야 해서 pipeline이 무겁습니다. 또한 TA merge에서 시작해도 특정 domain(본 실험에서는 MedQA)을 크게 뒤처지게 남기고, 학습을 이어가면 merge가 이미 갖고 있던 능력까지 잃을 수 있습니다. 반대로 uniform TA merge는 base와 teacher 사이 gap의 절반도 회복하지 못합니다(Average Recovery 42.98%(4B) / 32.41%(1.7B)). 가장 가까운 선행 연구인 IM-MOPD도 expert parameter를 재사용하지만, 외부 validation 규칙에 따라 정해진 시점에만 rule-based로 merge합니다. 그 결과 seed에 따라 결과가 크게 흔들립니다(1.7B에서 seed 간 약 18 point 차이). 저자들은 TA가 부분적으로라도 성공한다는 점에서 expert parameter가 유용한 prior를 담고 있다고 보고, 이 prior를 distillation gradient로 연속적으로 학습하는 방식이 필요하다고 주장합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 student와 frozen expert parameter의 linear combination을 하나의 differentiable model로 보고, mixing coefficient와 student weight를 같은 MOPD objective로 함께 최적화하는 P²-MOPD를 제안합니다 [Figure 2].
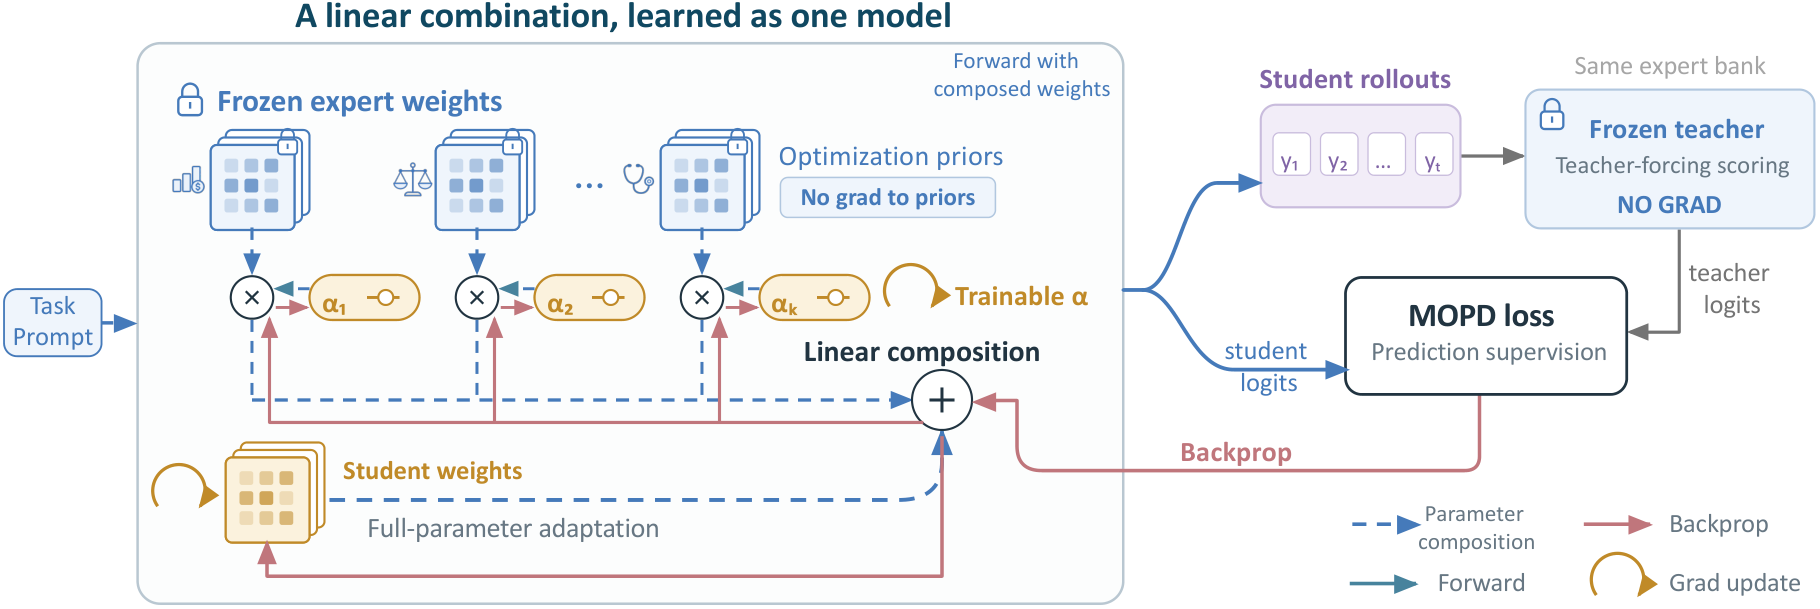
Figure 2 — P²-MOPD 전체 구조
방법론
- Parameterization: 각 module의 weight를 W_m = B_m + Σ_k α_{k,m} τ_{k,m}으로 둡니다. Full tensor B와 scalar α는 학습 가능하고, task vector τ는 frozen 상태로 둡니다.
- Gradient: α의 gradient는 ⟨G_m, τ_{k,m}⟩입니다. 즉 task vector 방향의 directional derivative이므로 추가 backward pass가 필요 없습니다.
- Two-channel update: weight channel(AdamW)과 coefficient channel(Adam)은 같은 pre-update gradient를 공유하지만 clipping은 따로 적용합니다. 그래서 한 channel이 다른 channel의 clipping budget을 소모하지 않습니다.
- Initialization: TA merge(α = λ = 0.25)에서 시작합니다.
- Inference 비용: 학습이 끝나면 α를 weight에 fold-in해 일반 checkpoint로 내보내므로 inference 비용은 그대로입니다.
- TA와의 차이: B가 계속 학습 가능하므로 student가 task-vector span 안에 갇히지 않습니다.
핵심 결과 (Qwen3-4B / Qwen3-1.7B, 4개 domain: MedQA, CaseHOLD, FinQA, IFBench)
- Final Average Recovery: P²-MOPD는 94.85%(4B) / 94.74%(1.7B)를 기록했습니다. 같은 시작점의 MOPD (TA init)는 83.13% / 80.93%, IM-MOPD는 88.02% / 67.81%, Open-MOPD는 84.20% / 79.79%였습니다.
- Worst-domain Recovery: MOPD (TA init)의 47.2 / 32.0에서 89.4 / 88.0으로 올랐습니다. Domain 간 recovery std는 21.8 → 4.6(4B), 28.4 → 4.8(1.7B)로 줄었습니다.
- 학습 속도: 학습 step의 절반(step 50)에서 이미 92.3 / 90.5에 도달해, 모든 seed pair에서 MOPD (TA init)의 최종 성능을 넘었습니다.
- Wall-clock 비용: step당 비용은 1.24× / **1.09×**로 늘지만, MOPD (TA init)의 최종 성능에 도달하는 시간은 ≤0.31× / **≤0.55×**에 그칩니다.
- MedQA 집중 개선: 성능 향상은 MOPD가 놓친 domain에 집중됩니다. MedQA recovery가 평균 +29.0(4B) / +48.2(1.7B) point 올랐습니다.
- 원인 분석(Reachability): Student weight만 업데이트하는 MOPD (TA init)는 τ_med 방향으로 +0.03만 움직였습니다. P²-MOPD는 +0.40 / +0.42로 13–15배 더 멀리 움직였고, α_med는 0.25에서 0.63 / 0.65로 올랐습니다. Coefficient channel은 displacement energy의 81% / 84%를 담당했고, weight channel은 거의 전부 span 바깥에서 움직였습니다.
- Ablation:
- Coefficient만 학습(span 내부)하면 Average Recovery는 52.98 / 49.31에 그칩니다. P²-MOPD 수준에 도달하려면 span을 벗어나는 weight channel이 필수입니다.
- Task vector 대신 random direction을 쓰면 효과가 없습니다(1.7B Avg. 70.2).
- α_med만 학습해도 대부분의 이득이 재현됩니다(1.7B Avg. 95.0).
4. Conclusion & Impact (결론 및 시사점)
P²-MOPD는 expert parameter를 학습 내내 learnable prior로 유지합니다. 이를 통해 MOPD보다 2배 적은 step으로 더 높은 average recovery에 도달하고, worst-domain recovery를 절반 이하에서 약 90%까지 끌어올립니다. 저자들은 그 원인을 reachability로 설명합니다. Student weight만 업데이트해서는 뒤처진 domain의 task vector 방향으로 거의 움직이지 않지만, module당 scalar 하나를 학습하면 그 방향에 도달할 수 있습니다. 저자들은 merged initialization 없이도 이점이 유지되고, 학습된 coefficient가 student에게 가장 필요한 teacher를 스스로 찾아낸다고 보고합니다.
시사점은 expert의 prediction(logit)뿐 아니라 weight 자체도 multi-teacher consolidation의 supervision source가 될 수 있다는 것입니다. 추가 parameter가 최대 10³개 수준의 scalar에 불과하고 inference 비용도 그대로여서, DeepSeek, Kimi, Xiaomi 등의 frontier model 기술 보고서에서 쓰이는 MOPD pipeline에 실용적으로 적용할 수 있습니다. 다만 이 결과는 4개 domain과 최대 4B scale에서 얻은 것이며, 더 큰 model에서의 검증은 명시되지 않았습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Open-MOPD: Diagnosing and Fixing Capability Imbalance in Multi-Teacher On-Policy Distillation
- [논문리뷰] On the Generalization Limitation of On-Policy Distillation for Post-RL Consolidation
- [논문리뷰] D^3-MOPD: Adaptive Dynamic Domain ScheDuling for Efficient Multi-Teacher Distillation
- [논문리뷰] From Gradients to Capabilities: Understanding Multi-Teacher On-Policy Distillation
- [논문리뷰] Composing What Each Teacher Learned: Multi-Teacher On-Policy Distillation through Teacher-Relative Shifts
Review 의 다른글
- 이전글 [논문리뷰] OneTrans-GSR: A Generative Slate Ranking Paradigm Unifying Reranking and Mix-Ranking with One Autoregressive Transformer
- 현재글 : [논문리뷰] P^2-MOPD: Accelerating Multi-Teacher On-Policy Distillation via Parameter Priors
- 다음글 [논문리뷰] PCBRouteAgent: How Close Are LLM Agents to Becoming PCB Routing Engineers?
댓글