[논문리뷰] On the Generalization Limitation of On-Policy Distillation for Post-RL Consolidation
링크: 논문 PDF로 바로 열기
저자: Yichen Wang, Yufa Zhou, Siqi Zhu, Haozheng Luo, Jingzhi Bao, Zhichao Liu, Zijun Wei
1. Key Terms & Definitions (핵심 용어 및 정의)
- OPD (On-Policy Distillation): student가 스스로 생성한 trajectory 위에서 각 token 위치마다 student-to-teacher reverse KL을 최소화하는 distillation 방식이다. RLVR의 on-policy state distribution과 knowledge distillation의 dense token-level supervision을 결합한다.
- MOPD (Multi-teacher On-Policy Distillation): 여러 data source마다 대응되는 teacher를 고정 할당한다. 각 OPD objective를 mixture weight로 가중합하여 여러 capability를 하나의 student로 consolidation한다.
- Extrapolative Generalization: 같은 domain 안에서 supervised range를 넘어서는 문제(예: GSM8K → AIME24/25)에 대한 성능을 뜻한다. 저자들은 이를 두 가지로 나누어 측정한다.
- OOD retention: base의 OOD 성능을 유지하는 것
- OOD generalization: base보다 OOD 성능을 높이는 것
- Compositional Generalization: 별도로 supervision된 component capability들(예: code + long context)을 동시에 요구하는 composed task(예: LongBench-v2 Code)에서의 성능이다.
- Self-RL Specialist vs. External Generalist Teacher
- Self-RL Specialist: student와 동일한 base(Qwen3-8B)에서 GRPO로 개별 학습된 teacher이다.
- External Generalist: pipeline 외부에서 가져온 더 강한 모델(예: Qwen3-32B)이다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문의 핵심 주장은 (M)OPD가 보여주는 near-perfect IND distillation 성능이 OOD 및 compositional capability의 불완전한 consolidation을 가릴 수 있다는 것이다.
- 배경: MOPD는 MiMo, DeepSeek, Kimi, Nemotron 등 frontier 모델의 post-RL consolidation 단계에서 domain specialist들을 하나의 student로 합치는 데 쓰이고 있다.
- 기존 연구의 한계: 대부분의 선행 연구는 target task의 IND 성능 향상에 집중한다. 그래서 teacher의 generalization 능력이 실제로 student에 전달되는지는 검증되지 않았다.
- 문제의식의 근거: grokking 연구가 보여주듯 generalization은 training data를 fit한 시점보다 훨씬 뒤에 나타날 수 있다. 따라서 OPD의 빠른 IND convergence가 teacher의 generalization 전이를 보장한다고 볼 수 없다.
- Preliminary study: Qwen2-100M을 operation 수 2-10의 GSM-Infinite 문제로 pretraining한 synthetic 실험을 수행했다 [Figure 1].
- pretraining IND의 distillation ratio는 96-104%, post-training IND는 93-96%였다.
- 반면 OOD(15-17 operations)에서는 76-86%로 떨어졌다.
- 이 결과를 바탕으로 저자들은 실제 task(math, code, agent, long-context)에서도 같은 한계가 나타나는지 체계적으로 검증한다.
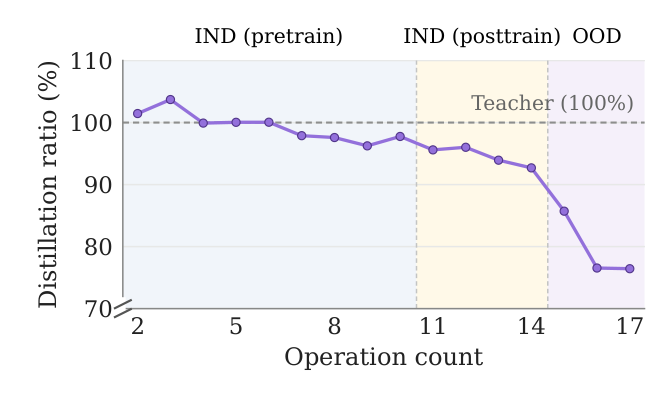
Figure 1 — IND에서는 near-perfect distillation이지만 OOD에서 transfer ratio가 76-86%로 떨어지는 핵심 현상을 보여주는 preliminary 결과
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Qwen3-8B student를 기준으로 OPD/MOPD를 각 RL baseline(single-task GRPO, mixed RL)과 비교했다. teacher setup은 self-RL specialist와 external generalist 두 가지이며, 평가는 extrapolative와 compositional의 두 generalization 축으로 이루어졌다.
IND/OOD 구분 기준: 세 self-RL teacher가 모두 base 점수의 97%를 넘는 benchmark를 IND로 정의했다.
- IND: GSM8K, MATH500
- OOD: AMC23, AIME24/25
Extrapolative 결과
- Single-teacher OPD (self-RL teacher): teacher IND 점수의 97.10%에 도달했다. 그러나 OOD는 base 대비 10.78% (8.56pt) 하락했다. self-RL teacher 대비로는 OOD forgetting을 25.09% 줄였다(손실 11.43 → 8.56pt).
- MOPD: OOD가 base 대비 14.07% (11.18pt) 낮았다. 다만 mixed RL(손실 15.73pt)보다 forgetting이 28.92% 적었다.
- External teacher (Qwen3-32B → Qwen3-8B): teacher IND의 99.34%를 달성했다. 그런데도 OOD는 base보다 3.73% 낮았다. 즉 강한 teacher만으로는 OOD 전이가 보장되지 않는다.
Compositional 결과
- MOPD는 IND에서 base 대비 +9.24% 향상되었지만, composed task에서는 best teacher보다 23.82% 낮았다.
- Code + Agent: SWE-bench Verified 점수는 다음과 같았다.
- base 6.63, MOPD 8.05, mixed RL 7.79, teacher 9.84
- Code + Long Context: component 성능은 모두 올랐지만 LongBench-v2 Code는 base와 같은 44.00에 머물렀다. 두 teacher는 각각 50.00, 58.00이었다.
Bottleneck 분석
- teacher capability와 data coverage를 함께 완화하는 실험을 했다. 구성은 Qwen3-32B teacher에 GSM8K 90% + OpenR1 10% data를 사용한 것이다.
- 그 결과 다섯 benchmark 모두에서 base를 넘어섰다. AMC23에서는 100.00으로 teacher(95.00)도 능가했다.
Update Geometry 분석 [Table 1]
- OPD의 update norm은 RL의 55.4% 수준이었다(0.154 vs. 0.278).
- update가 더 spectrally concentrated되어 있었다.
- top-64 energy: 69.0% vs. 39.9%
- stable rank: 6.90 vs. 19.0
- MOPD update는 single-OPD update의 span으로 11.0-18.6%가 설명되었다. 반면 mixed RL은 single-RL span으로 <0.240%만 설명되었다.
- Appendix D에서는 local 이론 분석을 제시한다. KL-regularized RL-optimal teacher를 가정하면 g_OPD = η·g_RL이 성립하며, OPD가 RL 방향을 보존하면서 크기를 축소한다는 것을 보인다.
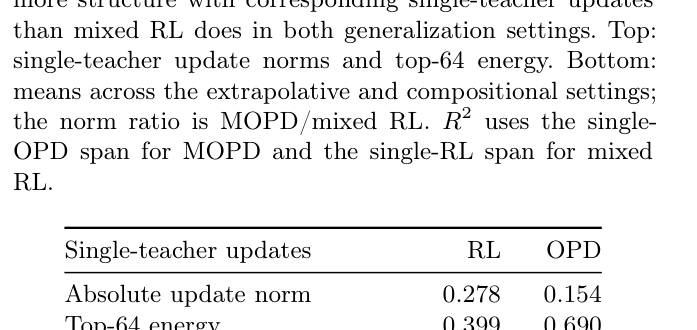
Table 1 — (M)OPD가 RL보다 compact하고 spectrally concentrated하며 shared structure가 큰 update를 만든다는 geometry 분석 핵심 수치
Mitigation
- Procrustes-attention patching: OPD update를 RL-teacher update에 orthogonal Procrustes로 정렬한 뒤, 맞지 않는 성분을 α=0.40으로 보정한다. 그 결과 AIME25 avg@8이 60.83% → 65.00%로 올랐고, GSM8K는 93.48%를 유지했다.
- Base-preserving replay: base model이 supervision하는 coding prompt를 섞어 학습한다. 그 결과 OOD 8개 중 5개 지표가 개선되었다. AIME25는 67.50으로 base와 RL teacher를 모두 넘어섰고, GSM8K 감소폭은 0.18pt에 그쳤다.
4. Conclusion & Impact (결론 및 시사점)
이 논문은 (M)OPD의 near-perfect IND distillation이 OOD retention, extrapolative generalization, compositional generalization을 보장하지 않는다는 점을 실증했다.
- RL 대비 장점: (M)OPD는 RL baseline보다 compact하고 shared structure가 큰 update를 만들며, forgetting도 덜하다.
- 남은 한계: 그럼에도 base 대비 OOD 손실과 composed task에서의 gap은 여전히 남는다.
- 원인 진단: 주요 bottleneck은 teacher capability와 data coverage이며, 두 가지를 함께 완화해야 OOD forgetting을 해소할 수 있다.
- 산업적 시사점: frontier 모델의 post-RL consolidation pipeline에서 IND 지표만으로 distillation 성공을 판단하는 관행에 경고를 준다. 따라서 OOD retention을 명시적으로 지원하는 algorithm(replay, parameter-space patching 등)이 필요하다.
한계 (저자 명시)
- geometry와 generalization 사이의 causal link는 아직 확립되지 않았다.
- 실험은 Qwen3-8B student 중심이다.
- 일부 실험은 single-seed로 수행되었다.
- synthetic setting에서는 mixed RL이 MOPD를 능가하는 경우도 있어, MOPD의 우위가 보편적이지 않을 수 있다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Every Coin Has Two Sides: On the Dual Nature of Generalization in On-Policy Distillation of Large Language Models
- [논문리뷰] From Gradients to Capabilities: Understanding Multi-Teacher On-Policy Distillation
- [논문리뷰] Dense Supervision, Sparse Updates: On the Sparsity and Geometry of On-Policy Distillation
- [논문리뷰] On the Geometry of On-Policy Distillation
- [논문리뷰] Beyond Domain-Routed Supervision: Cross-Teacher Guarding for Multi-Teacher On-Policy Distillation
Review 의 다른글
- 이전글 [논문리뷰] NitroFusion2: Bringing Adversarial Loss to the Text Stream of Multimodal Diffusion Transformers
- 현재글 : [논문리뷰] On the Generalization Limitation of On-Policy Distillation for Post-RL Consolidation
- 다음글 [논문리뷰] PyRUA-DataFarm: LLM Agent as a Cost-Efficient Teleoperator for Real-Ready Robot Data
댓글