[논문리뷰] AutoVend: Benchmarking LLM Agents on Long-Horizon Autonomous Vending Operations
링크: 논문 PDF로 바로 열기
저자: Qiming Shi, Yikun Li, et al. (Beidi Luan, Rui Sun, Sinuo Wang, Delin Wang, Yan Ma, Jing Li, Daxin Jiang, Zuo Bai; StepFun 등)
1. Key Terms & Definitions (핵심 용어 및 정의)
- AutoVend: 이 논문이 제안하는 Benchmark입니다. LLM agent 하나가 Web 기반 운영 interface로 5개 site type에 걸친 20대 vending machine을 180 simulated days 동안 운영합니다. 시작 자본은 40,000 CNY입니다.
- O2O (Online-to-Offline) Commerce: 의사결정은 Web platform에서 내리지만 실제 성과는 비용이 드는 physical execution(현장 보충 등)을 거쳐 나타나는 상거래 형태입니다.
- Net Assets (NA_T): 핵심 평가 지표입니다. 종료 시점의 cash에 shelf, warehouse, transit 상태에 있는 미만료 inventory를 원가로 평가한 값을 더해 계산합니다.
- POMDP formulation: 과제를 partially observable Markov decision process로 정의한 방식입니다. Agent의 action은 tool invocation이며, demand parameter와 unmet demand는 agent에게 숨겨져 있습니다.
- API Efficiency: 추정 API 비용 1 USD당 얻은 net-asset growth(CNY)입니다. 운영 수익과 inference 비용을 함께 평가하는 지표입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문은 LLM agent가 Web에서 내린 판단이 물리적 실행 비용을 거친 뒤에도 장기적인 경제적 수익으로 이어지는지 측정할 Benchmark가 없다는 문제를 다룹니다 [Figure 1]. 기존 commerce agent 평가는 대부분 product discovery, shopping, customer support 같은 buyer-side 과제였고, 평가도 단일 task나 transaction이 끝나는 시점에 멈춥니다. Seller-side Benchmark들은 운영 단위가 제한적입니다. Vending-Bench는 단일 machine, RetailBench는 단일 supermarket, E-Commerce Bench는 최대 4개 online store만 다룹니다. 이들 Benchmark는 이질적인 다수의 물리적 site에 shared inventory를 배분하면서 현장 보충마다 비용과 지연이 발생하는 상황을 평가하지 못합니다. 저자들은 이런 환경에 필요한 세 가지 능력을 제시합니다. Cross-site Resource Coordination, Physical Execution Planning, Continual Strategy Improvement이며, 이를 함께 측정할 통합 환경이 필요하다고 주장합니다.
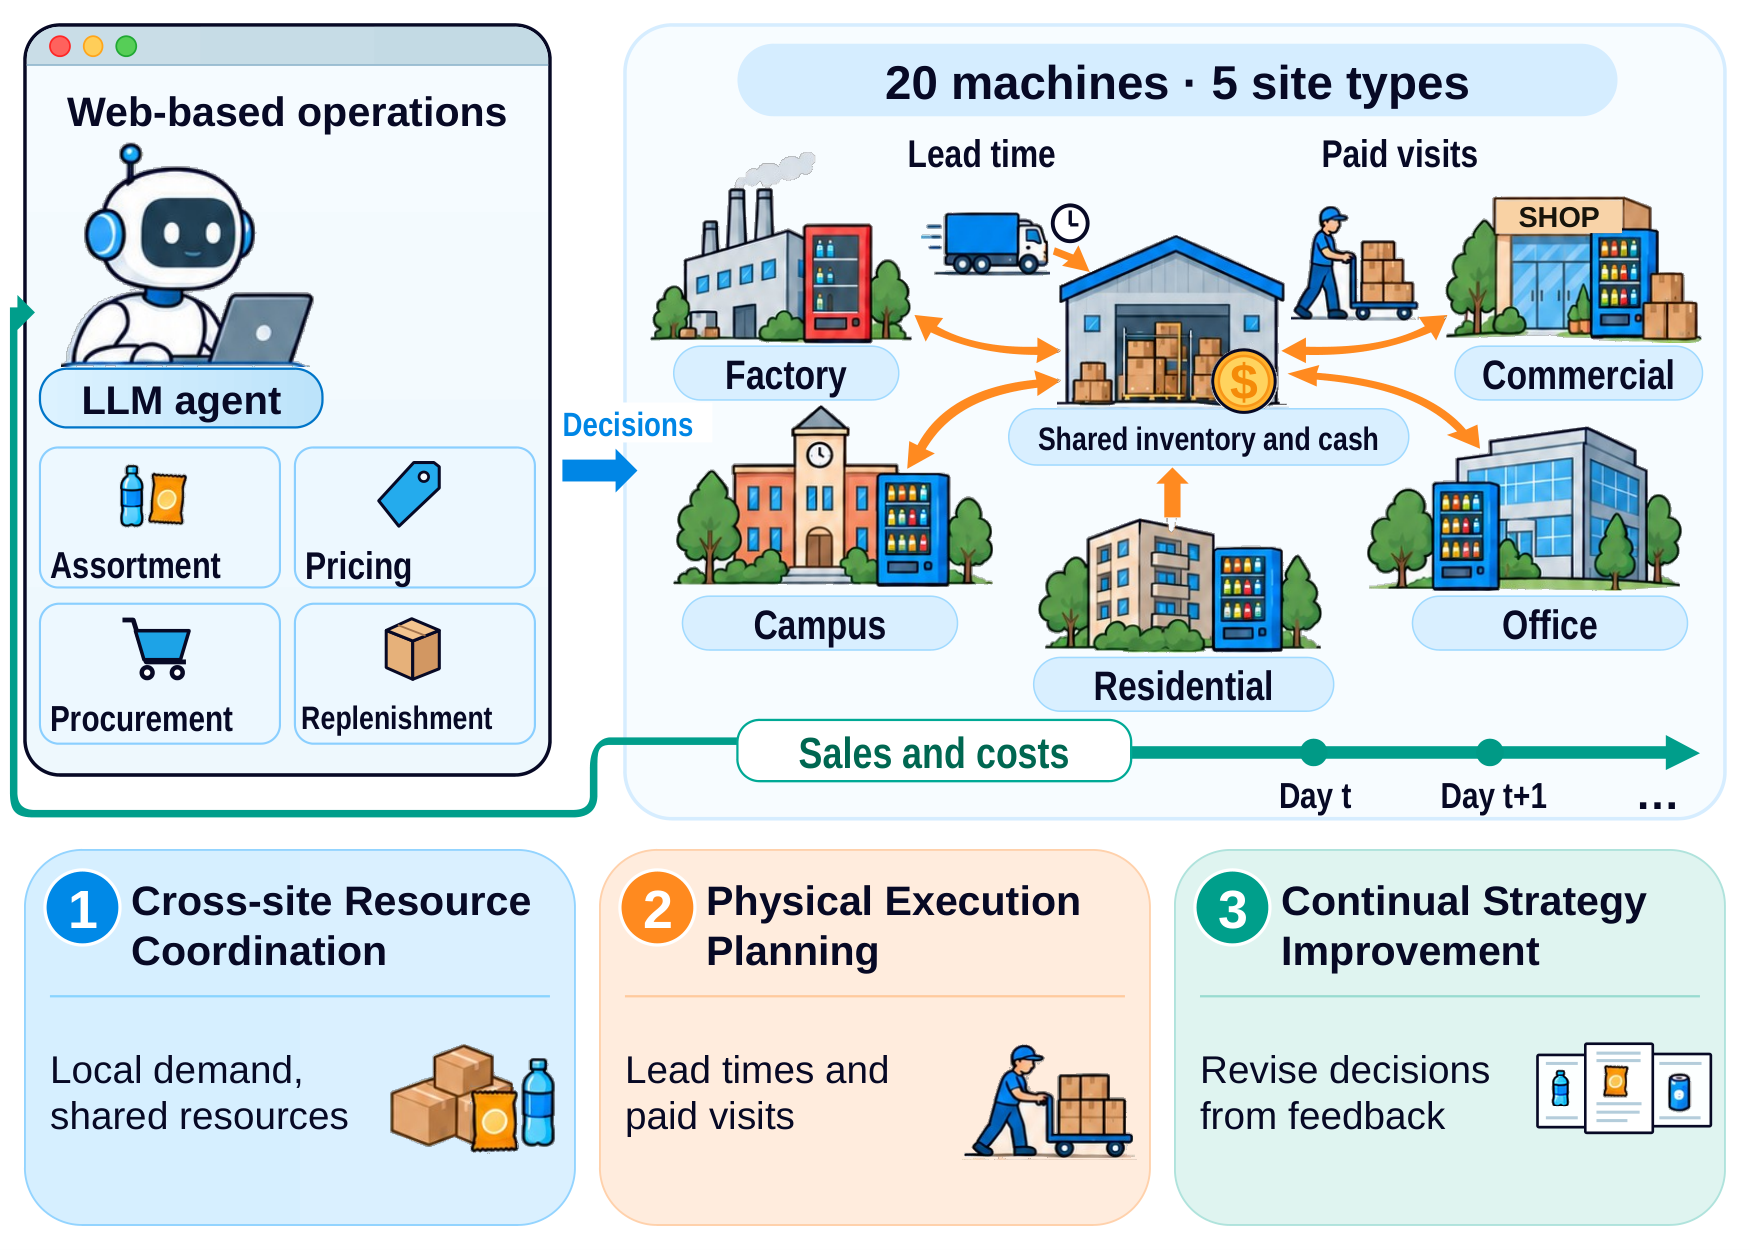
Figure 1 — AutoVend 개념도
3. Method & Key Results (제안 방법론 및 핵심 결과)
AutoVend는 실제 판매 데이터에 기반한 World Simulator와 MCP 기반 Agent Interface를 결합해 하루 단위 상호작용 loop를 구성합니다 [Figure 2].
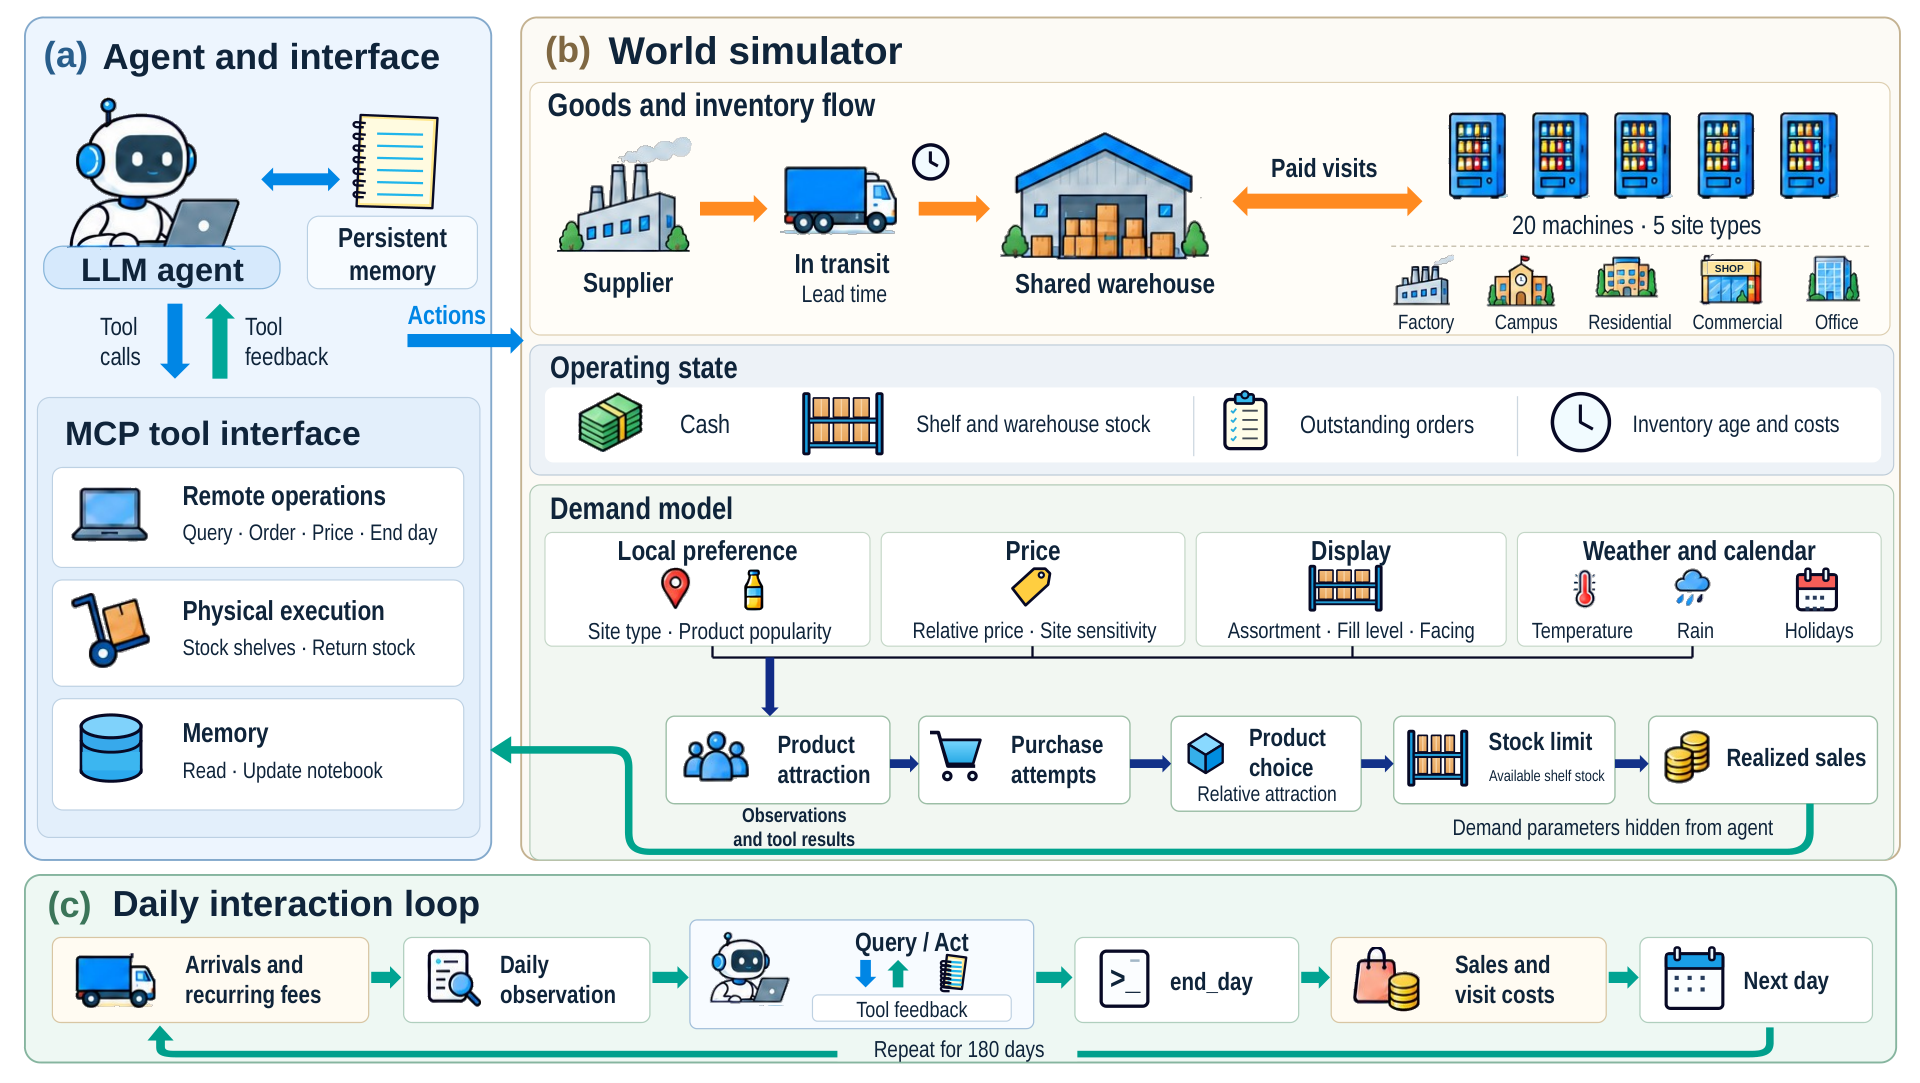
Figure 2 — 전체 프레임워크 구조
Simulator 구성
- Network는 worksite, campus, residential, commercial, office로 구성된 20대 machine과 shared warehouse 하나입니다. 각 machine의 용량은 200 units입니다.
- 운영 제약은 다음과 같습니다.
- Procurement lead time 3일
- On-site visit 비용 machine당 하루 35 CNY
- 상품 유통기한 30일 또는 90일
- 만료 상품 판매 시 unit당 1,000 CNY 벌금
- Demand는 multinomial logit model with no-purchase option으로 생성합니다. 진열 충만도(fill fraction), price elasticity, 날씨와 holiday 효과를 반영하고, 날짜 간 상관이 있는 overdispersed shock을 더합니다.
Data grounding
- 상용 smart vending 업체의 99대 machine, 6개월 분량, 220,128 units 판매 기록으로 parameter를 calibration했습니다. Catalog는 1,372개 상품입니다.
- Held-out 검증에서 total volume을 0.7% 이내로 재현했습니다.
- Machine-week WAPE: 0.473 (naive reference 0.606, persistence reference 0.561)
- Subcategory TVD: 0.153 (naive reference 0.206)
Agent Interface
- 18개 tool을 제공하며, remote operation, physical execution, memory notebook의 세 그룹으로 나뉩니다.
실험 설정
- 평가 모델: GPT-6.1 Sol, Claude Sonnet 5.5, DeepSeek V4.1 Flash, Kimi K3, GLM-5.3-Flash
- 비교 기준: newsvendor critical ratio와 periodic order-up-to replenishment를 결합한 rule-based baseline
- 각 모델당 3회 실행했습니다.
주요 결과
- Overall: 5개 모델 중 4개가 rule-based baseline(210.97K CNY)에 미치지 못했습니다. GPT-6.1 Sol만 309.35K CNY로 baseline을 넘었고, 3회 실행 모두에서 앞섰습니다. 나머지 모델은 GLM 148.43K, DeepSeek 133.92K, Claude 103.04K, Kimi 91.52K 순입니다.
- Variability: Kimi K3의 coefficient of variation은 45.6%였습니다. GPT, GLM, Claude는 약 11% 수준이었습니다.
- API Efficiency: DeepSeek이 31,010 CNY/USD로 가장 높았습니다. GPT는 API 비용이 DeepSeek의 약 80배였지만 net-asset growth는 약 2.9배에 그쳤습니다. 수익만으로 매긴 순위와 비용 대비 수익 순위가 다르다는 뜻입니다.
- 개별 운영 지표:
- Claude는 가장 낮은 Waste Rate(0.16%)와 Pricing Regret(1.32)를 기록했습니다. 하지만 25.21%의 site-day에서 shelf가 비어 있었습니다.
- GPT는 Pricing Regret이 30.18로 가장 컸지만 수익성은 가장 높았습니다.
- Site coordination: 기존 assortment를 site 간에 최적 재배치했을 때와 비교한 gap이 GPT 7.05%, baseline 2.61%였습니다.
- Feedback 기반 개선: Days 16–45 대비 days 136–165의 daily asset growth가 5개 모델 평균 모두에서 감소했고, 15회 실행 중 13회에서 감소했습니다.
- Failure modes: trajectory 분석에서 네 가지 실패 유형이 확인됐습니다.
- Infeasible allocation (예: Kimi의 allocation 49건 전부 reject)
- 판매되지 않는 상품의 반복 발주
- 분절된 site visit (gross profit 5.14 CNY인데 35 CNY 방문)
- 같은 오류의 재발
4. Conclusion & Impact (결론 및 시사점)
AutoVend 평가 결과, 현재 LLM agent는 대부분 장기 분산 retail 운영에서 단순한 rule-based inventory policy조차 넘지 못했습니다. 높은 총수익을 낸 경우에도 site coordination에 gap이 남아 있었습니다. Waste나 pricing 같은 개별 지표가 개선돼도 inventory와 execution 비용이 이득을 잠식하면 경제적 성장으로 이어지지 않았습니다. 이 연구는 agent 평가를 task 완료 중심에서 inference 비용을 포함한 누적 경제 성과 중심으로 옮기는 framework를 제시합니다. 산업 측면에서는 seller-side agent를 배포하기 전에 state verification과 persistent policy update 같은 보완 장치가 필요하다는 점을 보여줍니다. 다만 저자들도 밝히듯, 결과는 단일 환경에서 모델당 3회 실행한 데이터에 근거합니다. 다양한 운영 조건에서의 검증은 향후 과제입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] E-Commerce Bench: Evaluating LLM Agents on Long-Horizon Autonomous Business Operation
- [논문리뷰] MerchantBench: Benchmarking LLM Agents for Long-Term Coherence in E-Commerce Operations
- [논문리뷰] CEO-Bench: Can Agents Play the Long Game?
- [논문리뷰] CoffeeBench: Benchmarking Long-Horizon LLM Agents in Heterogeneous Multi-Agent Economies
- [논문리뷰] FM-Bench: A Benchmark for Long-Horizon Management with Competing Agents
Review 의 다른글
- 이전글 [논문리뷰] Auriga Technical Report: A Task-Agnostic Agent Harness for Zero-Shot Embodied Manipulation
- 현재글 : [논문리뷰] AutoVend: Benchmarking LLM Agents on Long-Horizon Autonomous Vending Operations
- 다음글 [논문리뷰] Click3R: Interactive Stereo 3D Reconstruction with Sparse Correspondence Clicks
댓글