[논문리뷰] Don't Just Trust Your Memory: Evidence-Linked Memory Reduces Memory-Induced Degradation in LLM Agents
링크: 논문 PDF로 바로 열기
저자: Yukyeong Lee, Yumin Choi, Jinheon Baek, Sung Ju Hwang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Memory-Induced Degradation: Memory 없이는 풀던 task를 memory를 붙였을 때 오히려 실패하는 현상. 주된 원인은 agent가 잘못된 lesson을 따르거나, 맞는 lesson을 적용 범위 밖에서 쓰거나 잘못 해석하는 것이다.
- WikiTrace: 저자들이 제안한 evidence-linked memory system. 각 lesson을 원래 trajectory와 연결해 두고, agent가 lesson을 따르기 전에 원본 근거와 대조해 볼 수 있게 한다.
- Insight / Compilation / Raw Trajectory: WikiTrace memory를 이루는 3개 layer.
- Insight: 무엇을 언제 해야 하는지와 출처 run, 그리고 그 run의 성공 여부를 담은 짧은 lesson
- Compilation: 해당 run이 왜 성공 또는 실패했는지 정리한 요약(diagnosis)
- Raw Trajectory: 각 turn의 reasoning·action·observation을 가공 없이 보존한 원본 기록
- Descent: Test time에 agent가 insight의 link를 따라 compilation이나 raw trajectory로 내려가 근거를 확인하는 행위. bash, read 같은 terminal tools를 사용한다.
- Gain / Regression: Memory 효과를 둘로 나눠 보는 지표.
- Gain: No Memory가 실패하던 task를 memory가 성공으로 바꾼 비율, 즉 Pr(M=1 | B=0)
- Regression: No Memory가 성공하던 task를 memory가 실패로 바꾼 비율, 즉 Pr(M=0 | B=1)
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문이 다루는 문제는, 기존 agent memory가 lesson만 주고 그 lesson이 나온 trajectory는 주지 않아서 agent가 잘못된 lesson을 검증할 방법이 없다는 점이다. 이 때문에 memory-induced degradation이 생긴다 [Figure 1]. Trajectory에는 성공/실패라는 binary outcome 하나만 붙어 있다. 그래서 수많은 action 중 무엇이 결과를 만들었는지 알 수 없고, lesson을 뽑는 과정은 결국 "어떤 action이 중요했는가"를 추측하는 일이 된다. 저자들은 No Memory로 3회 모두 성공한 task 가운데 memory를 붙이자 실패한 사례를 LLM judge로 분석했다. 그 결과 52%가 agent가 따른 memory item 때문이었고, 가장 흔한 경우는 item 자체가 틀린 것(20%)이었다. 기존 방법(AWM, ExpeL, ReasoningBank)은 Regression이 memory 없이 agent를 다시 돌렸을 때(rerun baseline)와 비슷하거나 더 높았다. Average accuracy만 봐서는 이런 퇴행을 알아차리기 어렵다. 한편 잘못된 lesson을 잡아낼 근거는 원본 trajectory에 남아 있는 경우가 많기 때문에, lesson과 원본 사이의 연결을 보존하는 접근이 필요하다는 것이 저자들의 주장이다.
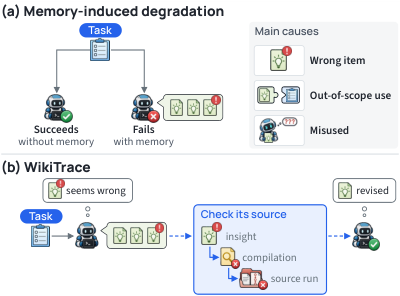
Figure 1 — Memory 퇴행과 해결
3. Method & Key Results (제안 방법론 및 핵심 결과)
WikiTrace는 lesson을 원본 trajectory와 연결한 3-layer memory와 test time의 Descent 메커니즘으로 memory-induced degradation을 줄인다 [Figure 2].
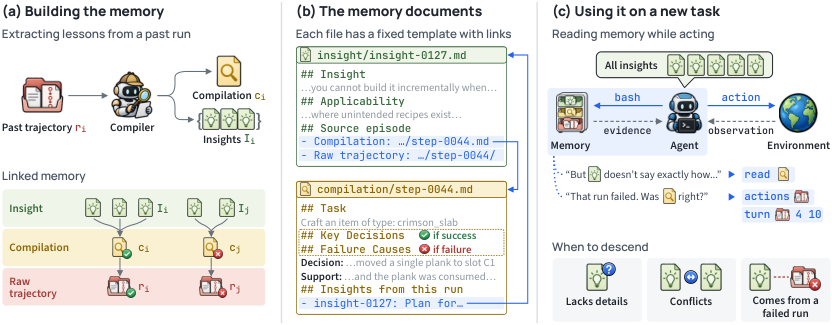
Figure 2 — WikiTrace 전체 구조
방법론
- Memory 구성: Memory는 ℳ=(R, C, I, E)로 정의된다. Compiler가 각 run (x, r, s)를 독립적으로 처리해 compilation 하나와 최대 3개의 insight를 만든다.
- Template 분리: 성공 run과 실패 run에 서로 다른 template을 쓴다. Compilation은 검증된 설명이 아니라 하나의 해석으로 취급한다.
- Insight 관리: Insight는 한 번 작성되면 수정하거나 삭제하지 않는다. 중복되거나 서로 충돌하는 insight가 있을 때 무엇을 적용할지는 agent가 판단한다.
- Test-time 입력: Agent는 모든 insight와 함께, 현재 task와 가장 비슷한 과거 run 3개를 받는다.
- Descent 조건: Insight가 행동에 필요한 정보를 충분히 담고 있지 않을 때, failed run에서 나왔을 때, 다른 insight와 충돌할 때, 또는 action이 실패했을 때 read-only로 mount된 파일을 bash/read로 탐색해 근거를 확인한다.
- 실험 설정: 5개 benchmark의 8개 suite(ALFWorld, ScienceWorld, PlanCraft, τ³-bench Retail, AppWorld)에서 평가했다. Backbone은 deepseek-v4-flash이다.
- 통제 baseline: Insights Only는 WikiTrace와 똑같은 insight를 받지만 원본 source에 접근할 수 없어, source 접근의 효과만 분리해 볼 수 있다.
핵심 결과
- 전체 성능: WikiTrace는 8개 suite 모두에서 1위였다. 평균 90.2로 No Memory(79.5)보다 +10.7, Insights Only(87.0)보다 +3.2 point 높다. 또한 모든 suite에서 No Memory와 같거나 더 높은 성능을 낸 유일한 memory 방법이다.
- Regression: WikiTrace 4.5%, Insights Only 6.5%, rerun baseline 9.7%였다. 95% confidence interval이 rerun 범위보다 완전히 아래에 있는 방법은 WikiTrace뿐이다.
- Gain: Rerun baseline보다 +35%p 높았다. 비교하면 Insights Only는 +27%p, 기존 방법들은 +7~14%p였다.
- Descent 패턴:
- Descent 비율은 Easy task에서 22%, Hard task에서 44%로 어려운 task일수록 높았다.
- Blocked attempt 이후 특정 fact를 찾으러 descent했을 때 Insights Only 대비 우위가 +17.3 point로 가장 컸다.
- 열어 본 run 때문에 plan이 바뀐 경우(43%)는 +8.3 point, plan이 그대로인 경우는 +4.4 point 우위였다.
- 실패 run에서 얻은 lesson: Failed run으로만 memory를 만들었을 때 Insights Only의 Regression은 PlanCraft 9.3%, ScienceWorld 9.4%였다. WikiTrace는 이를 각각 7.1%, 8.9%로 낮췄다.
- 비용: Test-time 비용은 Insights Only의 1.17배였다. Baseline의 memory 구축 budget을 3~9배로 늘려도 WikiTrace가 평균 성능 1위를 유지했다.
- 다른 backbone: GLM-5.3-flash에서도 평균 92.7로, Insights Only보다 +1.8, No Memory보다 +21.5 point 높았다.
- 정성 사례: PlanCraft에서 잘못된 insight를 두 source run과 대조해 수정하고 task에 성공한 예가 제시된다 [Figure 11].
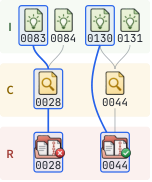
Figure 11 — Insight 수정 사례
4. Conclusion & Impact (결론 및 시사점)
Agent memory는 재사용할 lesson뿐 아니라 그 lesson을 다시 검토할 수 있는 evidence까지 보존해야 한다는 것이 이 논문의 결론이다. 성공/실패 결과만으로는 lesson이 맞는지 검증되지 않는다. WikiTrace는 insight를 compilation과 raw trajectory에 연결해, 같은 insight만 주는 방식보다 Gain을 높이고 Regression을 낮췄다.
시사점
- Memory를 평가할 때 average accuracy만이 아니라 Gain/Regression을 분리해서 보는 방식을 제안했다는 점이 의미 있다.
- Failed run에서 얻은 경험은 유용하지만 위험도 크다. 원본 evidence와 함께 보관하는 것이 이 위험을 줄이는 실용적인 방법임을 보여 준다.
한계 (저자 명시)
- Source link는 insight를 원본과 대조할 수 있게 해 줄 뿐, insight가 옳다는 것을 검증해 주지는 않는다.
- 모든 insight를 첫 prompt에 넣기 때문에 memory가 커지면 prompt도 계속 길어진다. 이 retrieval 문제는 해결되지 않은 과제로 남아 있다.
- 퇴행 원인 분석과 descent label은 LLM judge가 agent의 reasoning을 읽고 붙인 것이다. 따라서 reasoning에 적힌 내용을 반영할 뿐, 실제로 결과를 만든 원인이라고 단정할 수는 없다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] DexForesight: Grounding Dexterous Policies with Implicit Spatial Foresight
- 현재글 : [논문리뷰] Don't Just Trust Your Memory: Evidence-Linked Memory Reduces Memory-Induced Degradation in LLM Agents
- 다음글 [논문리뷰] DyCraft: An Agentic System for Long-Horizon 4D Scene Generation
댓글