[논문리뷰] MACaQ: Fast, Model Agnostic Calibrated Quantization for Low-Precision Weights and Activations
링크: 논문 PDF로 바로 열기
저자: Lorenz K. Muller, Philippe Bich, Chiara Boretti, Hyun-Min Chang, Jiawei Zhuang, Lukas Cavigelli
1. Key Terms & Definitions (핵심 용어 및 정의)
- MXFP4 (OCP Microscaling FP4): 32개 element를 하나의 block으로 묶는 4-bit 포맷입니다. block마다 E8M0 shared scale(exponent bit 8개, mantissa bit 없음)을 두고, 각 element는 FP4 E2M1 code(sign 1bit, exponent 2bit, mantissa 1bit)로 표현됩니다. element당 약 4.25 bits입니다.
- Layer Locality: 모든 basis transform과 quantization 결정을 하나의 linear layer 안에서만 처리하는 MACaQ의 핵심 설계 원칙입니다. 인접한 normalization layer, projection, residual branch는 전혀 수정하지 않습니다.
- Online Scaling & Micro-Rotation: inference 시점에 activation에 직접 적용하는 두 가지 가벼운 transform입니다. 하나는 per-channel scale(D)이고, 다른 하나는 MXFP4 block 크기와 같은 size-32 block-Hadamard rotation(B)입니다. weight 쪽에는 역변환(W·D⁻¹·B)을 offline으로 흡수합니다.
- Hessian-Weighted Exponent Selection: MXFP4 block마다 shared exponent를 고르는 단계입니다. 표준 exponent에 offset {+1, 0, −1}을 더한 후보를 비교해, layer-input Hessian(H = XᵀX)으로 가중한 reconstruction error가 가장 작은 exponent를 선택합니다.
- Flip-Refinement: round-to-nearest(RTN) 결과에서 출발하는 Hessian-aware coordinate-descent 기법입니다. 각 FP4 code를 바로 인접한 E2M1 level로 옮기는 move 가운데 gain이 가장 큰 것을 output row마다 greedy하게 하나씩 받아들입니다. gain은 closed-form으로 계산되고, gradient는 incremental하게 업데이트됩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문이 다루는 문제는 기존 W4A4 quantization 기법들이 basis transform을 layer 사이로 propagate해서 흡수하기 때문에 생기는 engineering 복잡도와 긴 quantization time입니다. 저자들은 이를 per-layer 방식으로 해결하고자 합니다. QuaRot, FlatQuant, MR-GPTQ, DuQuant++ 같은 기존 방법은 activation 쪽 transform의 runtime 비용을 없애려고 그 transform을 앞쪽 layer(normalization, projection 등)에 흡수시킵니다. 이 방식에서는 layer마다 적절한 absorption target을 찾아야 하고, layer 간 dependency가 생깁니다. 그래서 새 architecture에 적용하려면 architecture별 수정이 필요하고, 일부 architecture에서는 모든 layer에 transform을 흡수시키는 것 자체가 불가능합니다. 여기에 더해 GPTQ류의 순차적 weight assignment나 transform 최적화는 quantization time이 길고 memory 요구량도 큽니다. 저자들은 transform을 online으로 유지해서 생기는 작은 inference overhead를 감수하는 대신, layer locality로 단순성과 속도를 얻자고 주장합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
MACaQ는 각 linear layer를 독립적으로 calibrate, transform, quantize하는 MXFP4 W4A4 post-training quantization pipeline입니다. 처리 단계는 다음과 같습니다.
- 목적 함수: GPTQ와 마찬가지로 layer output reconstruction error ‖XWᵀ − XŴᵀ‖²_F를 최소화합니다.
- Online Scaling: per-channel scale을 tⱼ ∝ (σⱼᵂ / rmsⱼˣ)^α 형태로 정해 outlier activation channel을 줄이고 weight column과 균형을 맞춥니다. α는 0.75를 사용합니다. rmsⱼˣ는 Hessian의 diagonal에서 바로 얻습니다.
- Online Micro-Rotation: 이어서 32-size block-Hadamard rotation을 적용합니다. block 크기를 MXFP4 block과 같게 해서 outlier가 서로 독립적으로 scale되는 여러 block으로 퍼지지 않도록 합니다.
- Exponent 선택과 Flip-Refinement: Hessian-weighted exponent screening으로 block exponent를 고정한 뒤, Flip-Refinement로 각 code를 인접 level로 옮기며 objective를 줄입니다. output row 단위로 병렬 처리하며, 더 이상 개선할 move가 없는 row는 active set에서 제거합니다.
- 연산량과 memory: online transform의 연산량은 output dimension m과 무관한 반면, matmul의 연산량은 m에 비례해 커집니다. 따라서 큰 layer일수록 overhead 비율이 줄어듭니다. Llama-3-8B의 가장 작은 layer(m = 1024)에서도 arithmetic 비율은 0.3% 미만입니다. 또한 한 번에 하나의 layer만 GPU에 올라가면 되므로 streaming quantization이 가능합니다.
주요 정량 결과:
- Perplexity: Llama-3-8B에서 MACaQ는 WikiText-2/C4 perplexity 6.90 / 11.01을 기록했습니다. 비교 대상은 MR-GPTQ (7.13 / 11.37), DuQuant++ (GPTQ) (7.17 / 11.66), FlatQuant (7.21 / 11.65)이며, FP16은 6.14 / 9.46입니다. 평가한 다른 모델에서도 대부분 가장 낮은 perplexity를 보였습니다. 예외로 Qwen3.5-35B-A3B의 C4에서는 MR-GPTQ(11.22)와 MACaQ(11.21)가 거의 같은 수준입니다.
- Quantization time: baseline들의 최고 perplexity를 11× 적은 quantization time으로 달성했습니다. 기본 설정(K = 128, calibration token 2×10⁵)에서 Llama-3-8B quantization은 약 150s가 걸렸습니다.
- Large model: Qwen3.5-122B-A10B(FP16 기준 약 244GB)를 GPU memory 32.5GB만 사용해 64분 만에 quantize했습니다. WikiText-2 perplexity는 5.14로, FP16의 5.06과 큰 차이가 없습니다. 결과 모델은 74GB로, 96GB GPU 한 장에서 구동됩니다.
- Generative tasks: Qwen3-32B에서 IFEval 83.20%(FP16 83.60%), MATH-500 97.26%를 기록했습니다. IFEval은 quantized 방법 중 가장 높고, MATH-500은 MR-GPTQ(97.44%)에 이어 두 번째입니다.
- Image diffusion: architecture별 수정 없이 FLUX.2 Klein 4B에 적용했습니다. 공식 NVFP4 checkpoint(4.50 bits)와 비교하면, MACaQ MXFP4(4.25 bits)가 BF16 출력에 더 가까웠습니다. 지표는 PSNR 15.04 vs 14.85, LPIPS 0.218 vs 0.235, DINO global 0.882 vs 0.878입니다 [Figure 4].
- Speed: Qwen3-32B batch 1 decode에서 FP16의 22.8 tok/s 대비 69.8 tok/s(3.06×)를 기록했습니다. online transform의 End-to-End overhead는 Qwen3-32B에서 2.3%, 가장 작은 Qwen3-0.6B에서 약 8%입니다. Kernel 단위에서는 N = 16384일 때 overhead가 3% 미만입니다.
- Ablation (Llama-3-8B, WikiText-2): RTN 8.28에서 출발해 component를 하나씩 추가했습니다.
- Hessian exponent search: −0.19
- micro-rotation: −0.44
- online scale: −0.57
- Flip-Refinement: −0.21
- 최종 6.87에 도달했습니다.
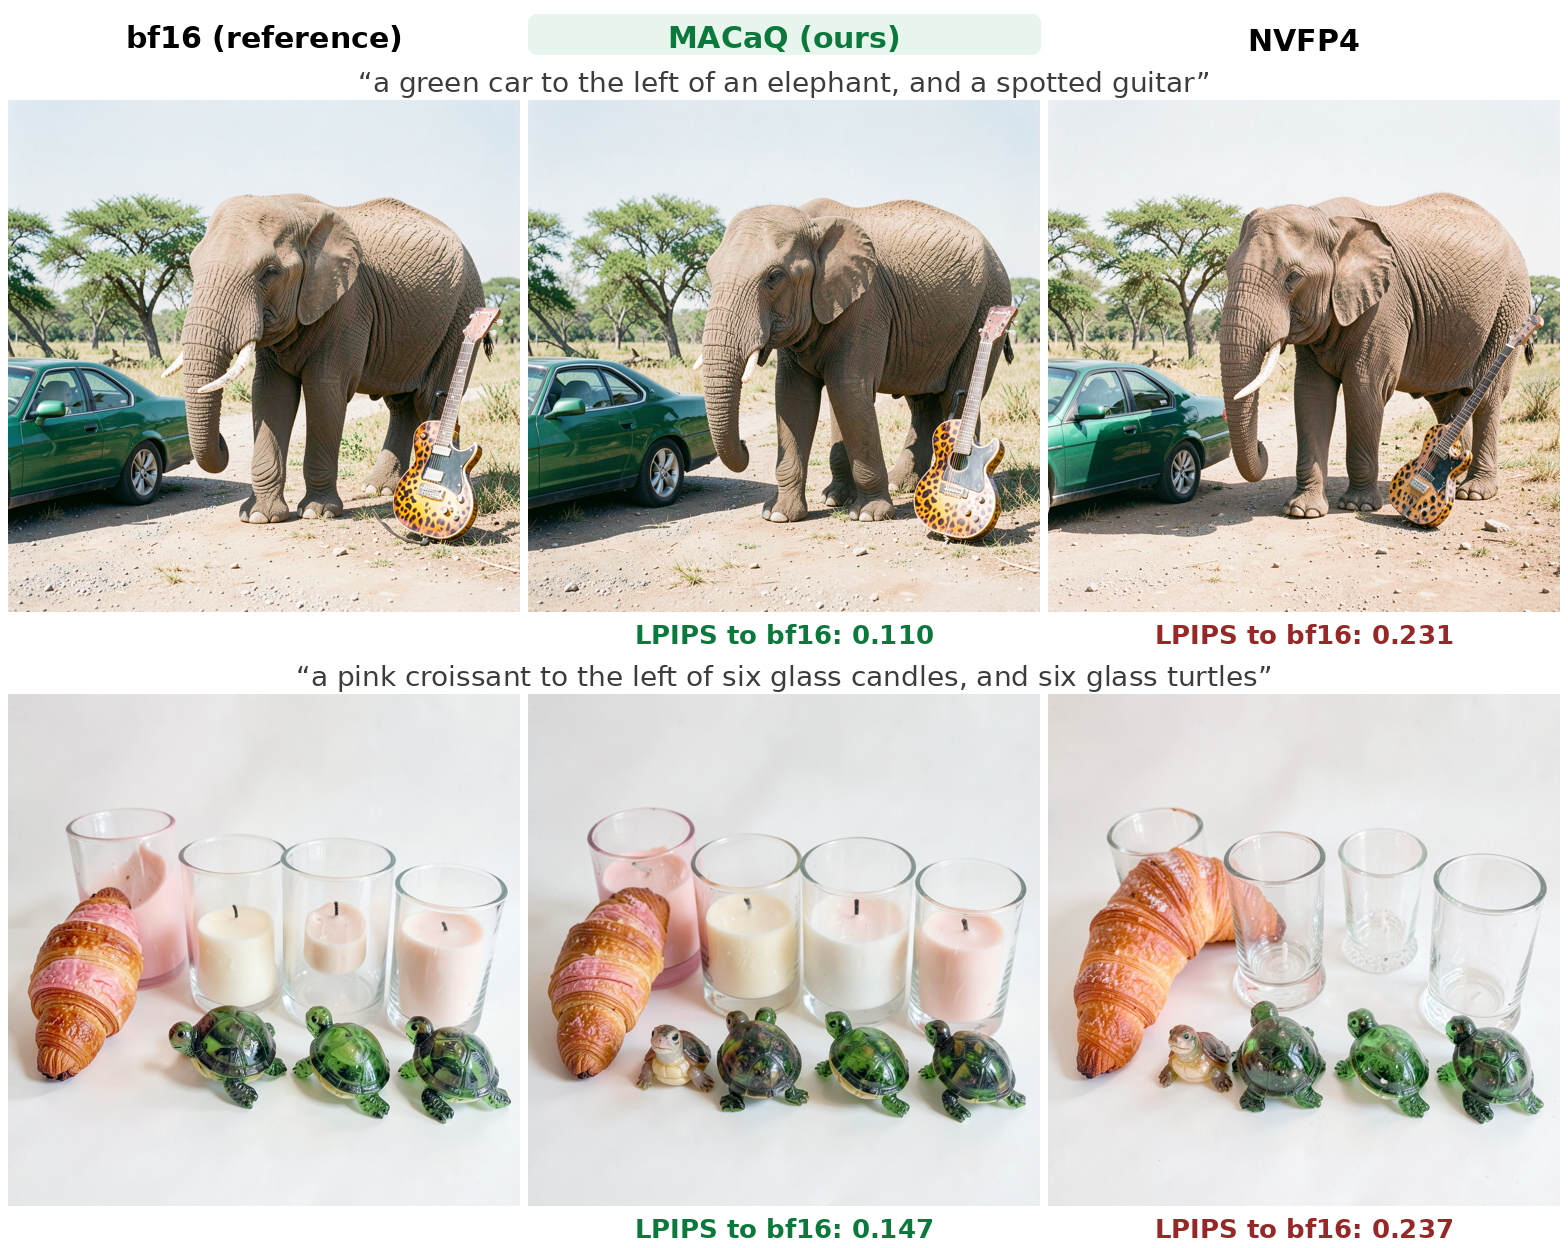
Figure 4 — FLUX2 생성 결과 비교
4. Conclusion & Impact (결론 및 시사점)
MACaQ는 가벼운 online basis transform으로 layer locality를 유지하면서도 state-of-the-art MXFP4 방법과 같거나 더 나은 quality를 훨씬 빠르게 달성합니다. 이를 가능하게 한 핵심 요소는 세 가지입니다.
- GPTQ를 대체하는 가벼운 Flip-Refinement
- Hessian-aware shared-scale(exponent) 최적화
- per-layer로 처리를 국소화하는 online scaling + block-Hadamard
산업적 관점에서는 원래 precision으로는 GPU에 올라가지 않는 대형 모델(122B)도 단일 GPU에서 quantize할 수 있다는 점이 중요합니다. 또한 LLM, MoE, diffusion model에 같은 코드를 적용할 수 있어 model-agnostic 배포 pipeline에 유용합니다. vLLM용 Triton kernel도 함께 제공합니다.
저자들이 밝힌 한계는 다음과 같습니다.
- layer-local 설계이므로 cross-layer error compensation이 불가능합니다.
- MoE 실험에서는 expert layer만 quantize했습니다.
- 작은 모델(0.6B)에서는 online transform overhead가 약 8%로 커집니다.
참고로 논문의 Figure 1–3(아키텍처 비교, quantization time–perplexity Pareto plot, decode overhead 그래프)은 HTML 페이지에 <img> 태그가 없어 아래 선별 대상에서 제외했습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] Lipschitz-Controlled Flow Matching for Robust Image Restoration
- 현재글 : [논문리뷰] MACaQ: Fast, Model Agnostic Calibrated Quantization for Low-Precision Weights and Activations
- 다음글 [논문리뷰] MMDM: Measuring Massive Multitask Decision Making
댓글