[논문리뷰] AI Reviews Are Biased Towards the Appendix
링크: 논문 PDF로 바로 열기
저자: Saptarshi Ghosh, Mohammad Saim, Tianyu Jiang (University of Cincinnati)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Appendix Bias: 최신 LLM이 리뷰를 쓸 때 weakness의 상당 부분을 main body가 아닌 appendix에서 가져오는 경향입니다. 이 논문이 처음으로 정량화한 현상입니다.
- Appendix-related Weakness: 근거 일부가 appendix에서 나온 weakness를 말합니다. 근거가 appendix에만 있는 경우와 main body와 appendix 양쪽에 걸친 경우를 모두 포함합니다. 이 중 근거가 appendix에만 있는 경우를 Appendix only로 따로 구분합니다.
- Section Attribution: 생성된 리뷰와 논문 PDF를 같은 LLM에 다시 넣고, 각 weakness가 어느 section에서 나왔는지 최대 2개까지 지정하게 하는 단계입니다. 특정 section과 무관한 weakness는 "not specified"로 처리합니다.
- Access Methods: 같은 모델을 쓰는 서로 다른 방식입니다. 이 논문은 4가지를 비교합니다.
- API (PDF 직접 입력)
- API (추출한 full text 입력)
- Codex (CLI coding agent)
- Web interface
- Weakness Taxonomy: appendix-related weakness를 8개 범주로 분류하는 체계입니다. 범주는 Core Idea, Methodology, Results, Analysis, Prompts, Discussion, Tables & Figures, Presentation입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문은 최신 LLM 리뷰어가 논문의 어느 부분을 비판하는지 묻고, 그 비판이 appendix에 지나치게 치우쳐 있다는 문제를 제기합니다. ICLR 2026에서는 리뷰의 약 1/5이 완전히 AI로 생성된 것으로 flag되었습니다. 리뷰어가 LLM이 뽑아 준 weakness 목록을 자기 리뷰에 그대로 옮기는 일도 흔합니다. 기존 연구는 LLM 리뷰와 human 리뷰의 alignment, benchmark, prompt injection을 통한 manipulation 등을 다뤘습니다. 하지만 LLM이 논문의 어느 위치에서 비판을 끌어오는지는 분석하지 않았습니다. 저자들은 실제 학회 리뷰에서 deep appendix의 부차적 실험이나 세부 사항이 major weakness로 올라오는 패턴을 관찰했습니다. 이런 weakness는 논문의 core idea와 거의 관련이 없어 저자에게 도움이 되지 않습니다. 그런데도 리뷰어가 논문 전체를 약하다고 판단하게 만들 수 있다는 점이 문제입니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 논문 수집 → 리뷰 생성 → weakness의 section attribution으로 이어지는 3단계 pipeline을 설계했습니다 [Figure 2].
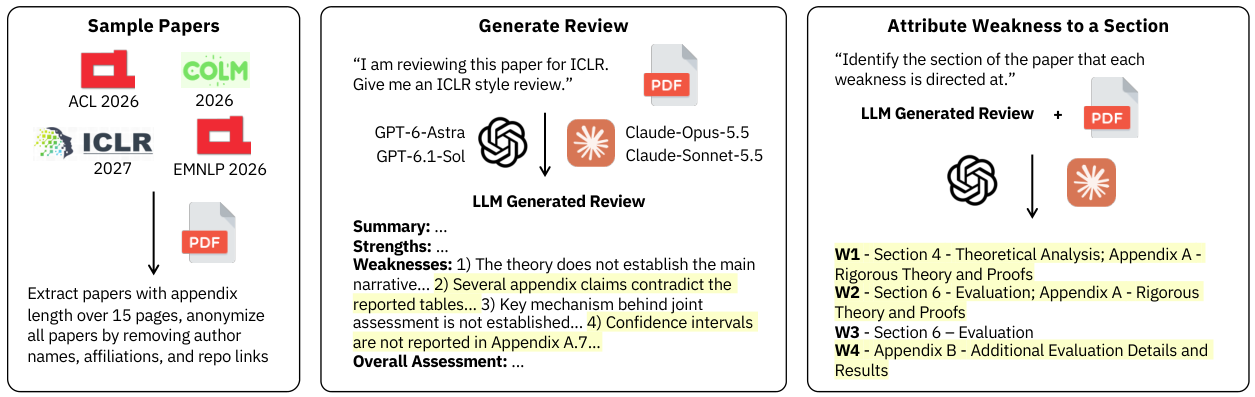
Figure 2 — 분석 파이프라인 개요
데이터 수집
- ACL 2026, EMNLP 2026, COLM 2026, ICLR 2027에서 appendix가 15페이지 이상인 논문을 학회별 200편씩, 총 800편 샘플링했습니다.
- double-blind 조건을 맞추기 위해 저자 정보와 링크를 제거했고, web search는 비활성화했습니다.
리뷰 생성과 attribution
- 평가 모델은 GPT-6-Astra, GPT-6.1-Sol, Claude-Opus-5.5, Claude-Sonnet-5.5 네 가지입니다.
- 실제 리뷰어의 사용 방식을 흉내 내기 위해 *"I am reviewing this paper for [conference]. Give me a [conference] style review."*라는 단순한 prompt만 사용했습니다.
- 리뷰 생성과 attribution을 의도적으로 두 단계로 나눴습니다. 생성 prompt에 추가 지시를 넣으면 prompt artifact가 리뷰에 영향을 줄 수 있기 때문입니다.
Human 리뷰 비교
- ICLR 2021–2027 리뷰를 연도별 200편씩 총 1,400편 분석했습니다.
- 그중 2021–2024는 LLM 영향이 적은 human baseline으로 사용했습니다.
- weakness별 page 위치를 추적했고, taxonomy로 비판 유형도 분류했습니다.
핵심 결과
- LLM의 appendix 의존도
- 모든 모델과 학회에서 weakness의 약 50% 이상이 appendix-related였습니다.
- Appendix only 비율은 GPT 17.33%, Claude 10.16%였습니다.
- 세대 간 차이: GPT-5는 appendix-related weakness가 30% 미만이었지만, GPT-6-Astra와 GPT-6.1-Sol은 약 60–70%였습니다. 이 bias는 최신 모델에서 새로 나타난 현상으로 보입니다.
- Access method 간 차이: ICLR 2027 논문 100편을 GPT-6-Astra로 리뷰했을 때 Codex, API(text), API(PDF), Web 모두 50% 이상을 기록했습니다. 따라서 이 bias는 접근 방식이 아니라 모델 자체의 특성으로 판단됩니다.
- Human vs LLM
- appendix-related weakness 비율은 human 8.40 ± 1.44%, LLM 62.00 ± 7.70%였습니다.
- Appendix only 비율은 human 4.36%, LLM 14.19%였습니다.
- LLM 리뷰는 200편 모두에 appendix 비판이 최소 1개 이상 있었습니다.
- 시계열 추세
- human 리뷰의 appendix-related weakness 비율은 2020–2024 review year 동안 6–10% 수준으로 안정적이었습니다.
- GPT-5 출시 뒤인 2025년에는 11.27%로 늘었습니다.
- GPT-6-Astra와 Claude-Opus-5.5 출시 직후인 2026년(ICLR 2027 리뷰)에는 27.60%로 급증했습니다.
- 단, 저자들은 이 증가가 시간적 상관관계일 뿐 인과관계를 증명하지는 않는다고 명시합니다.
- Page 분포
- human은 문제 정의와 core idea가 담긴 첫 5페이지에 비판이 집중됩니다.
- LLM은 결과와 분석이 담긴 6–7페이지, 그리고 appendix 전반에 비판이 분포합니다. 특히 30페이지 이후에서도 weakness를 계속 제기합니다.
- 비판 유형
- appendix 관련 비판에서 LLM의 비중은 Methodology 54.0%, Analysis 25.2%, Results 13.6%였습니다.
- Presentation 비판은 LLM이 2.1%에 그친 반면 human은 32.2%였습니다.
- LLM은 추가 seed, significance test, confidence interval 같은 통계 검증을 반복적으로 요구하는 경향을 보였습니다.
4. Conclusion & Impact (결론 및 시사점)
이 논문은 최신 LLM이 리뷰 비판의 대부분을 appendix에서 가져오며, 이 현상이 모델, 학회, access method와 무관하게 일관적이라는 결론을 내립니다. human 리뷰어는 "main body가 논문이고 appendix는 이를 뒷받침하는 자료"라는 암묵적 원칙에 따라 둘의 비중을 다르게 둡니다. 반면 LLM은 논문 전체를 하나의 단위로 보고 모든 줄을 같은 무게로 다룹니다. 저자들은 이 bias를 양면적으로 평가합니다. 논문의 모든 페이지를 검토한다는 점에서 기준을 높이는 효과가 있습니다. 하지만 핵심 contribution과 무관한 표면적 피드백이 리뷰를 채우면 강한 아이디어를 가진 논문도 미완성처럼 보이게 만들 수 있습니다.
시사점
- 리뷰어: LLM을 무엇이 중요한지 판단하는 주체가 아니라 세부 사항을 점검하는 도구로 써야 합니다.
- 저자: AI 피드백을 적절한 비중으로 해석해야 합니다.
- 모델 개발자: 논문에서 무엇이 중요한지 구분하는 리뷰 모델을 개발할 필요가 있습니다.
한계
- LLM 기반 attribution 자체에 오류가 있을 수 있습니다.
- human 리뷰와 LLM 리뷰가 서로 다른 연도와 논문에서 나와 직접 비교에 제약이 있습니다.
- 각 weakness가 타당하거나 유용한지는 측정하지 않았습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] A Missing Piece for Trustworthy AI Reviewers: From Benchmarking Rhetorical Robustness to SciCore Review
- [논문리뷰] How Can Rhetoric Reward-Hack AI Reviewers? Dissecting Rhetorical Sensitivity in AI-Based Peer Review
- [논문리뷰] Can AI Reviewers See Your Efforts to Improve Your Paper? A Large-Scale Study of Paper Revision Trajectories
- [논문리뷰] FactReview: Evidence-Grounded Reviews with Literature Positioning and Execution-Based Claim Verification
- [논문리뷰] When AI Reviews Train AI Reviewers: Scientific-Judgment Collapse and Mitigation
Review 의 다른글
- 이전글 [논문리뷰] WorldDraft: If Code Builds the World, Can Video Models Just Render It?
- 현재글 : [논문리뷰] AI Reviews Are Biased Towards the Appendix
- 다음글 [논문리뷰] Aligning AI Teams
댓글