[논문리뷰] HALO: Human-Aligned Data Collection for WhoLe-body MObile Manipulation
링크: 논문 PDF로 바로 열기
저자: Shuai Yang, Fangyi Xu, Yishu Shen, Kecheng Zheng, Yinghao Xu (HKUST, Robbyant)
1. Key Terms & Definitions (핵심 용어 및 정의)
- HALO (Human-Aligned data collection for WhoLe-body MObile manipulation): 이 논문이 제안하는 데이터 수집 시스템입니다. 운영자의 perception–action space를 로봇과 일치시키면서도 운영자가 자연스럽게 걸을 수 있도록 설계되었습니다.
- Perception Gap / Mobility Gap: Mobile ALOHA 같은 leader–follower 방식에서 생기는 두 가지 한계입니다. Perception Gap은 운영자의 손·시점이 로봇 end-effector와 떨어져 있어 생기는 인지상의 괴리이고, Mobility Gap은 powered mobile base가 운영자의 움직임 공간을 차지해 자연스러운 locomotion을 막는 문제입니다.
- Kinesthetic Teaching: 운영자가 로봇 팔을 직접 손으로 잡고 움직여 시연하는 방식입니다. 직접적인 visual feedback과 force feedback을 얻을 수 있고, retargeting 없이 ground-truth robot action을 바로 기록할 수 있습니다.
- Deployment-Aligned Demonstration Processing: 시연 환경과 실제 배포 환경 사이의 차이를 줄이는 후처리 pipeline입니다. 영상에서 시연자의 손을 지우는 visual processing과, passive platform의 움직임을 실제 base velocity로 바꾸는 base motion alignment로 구성됩니다.
- RTC (Real-Time Action Chunking): 현재 action chunk를 실행하는 동안 다음 chunk를 미리 예측하는 asynchronous inference 기법입니다. 이미 확정된 action prefix를 조건으로 사용해 chunk 사이의 연속성을 유지합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문이 풀려는 문제는, 기존 인터페이스로는 locomotion과 bimanual manipulation이 함께 들어간 whole-body demonstration을 효율적으로 수집하기 어렵다는 점입니다. 기존 방식들은 direct robot control, perception–action alignment, natural operator mobility 세 가지 중 일부만 충족합니다.
- VR teleoperation: 조작이 간접적이고 force feedback이 없습니다.
- Mobile ALOHA: 운영자의 손·시점이 end-effector와 떨어져 있어 perception gap이 생기고, powered base 때문에 운영자의 이동이 제약됩니다 [Figure 2].
- UMI/HoMMI 같은 retargeting 기반 방식: 사람의 움직임은 자유롭게 보존하지만, base motion을 정밀하게 제어하기 어렵고 visual gap과 control gap이 남습니다.
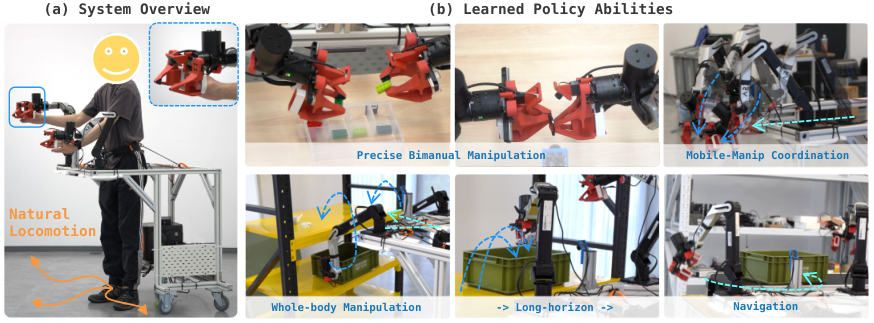
Figure 2 — HALO 시스템 개요
따라서 로봇 고유의 action constraint와 physical feedback을 유지하면서, 운영자의 인지·행동 공간을 로봇과 맞추고 자연스러운 이동성도 보장하는 새 인터페이스가 필요합니다. 다만 사람과 로봇이 밀착되면 새로운 문제가 생깁니다. 시연 영상에 운영자의 손이 찍히고, passive platform과 실제 base의 dynamics가 달라 시연 데이터와 배포 환경 사이에 distribution shift가 발생합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
HALO는 kinesthetic teaching 기반 manipulation interface, low-resistance mobility interface, deployment-aligned 후처리를 결합해 효율적이고 정밀한 whole-body policy learning을 가능하게 합니다 [Figure 2].
Manipulation Interface
- ALOHA end-effector의 handle-and-scissor 구조를 없애고, 손이 닿는 면적을 넓힌 compact한 형태로 다시 설계했습니다.
- 그 결과 end-effector 크기가 절반 이상 줄었고, 사용 가능한 pitch angle은 약 40° 늘었습니다.
Mobility Interface
- 시연 중에는 powered base를 떼어내고 passive wheel 기반 platform을 사용합니다. 이 platform은 배포용 AgileX Tracer AGV 2 differential-drive base와 같은 nonholonomic motion space를 갖도록 기구적으로 제약되어 있습니다.
- 이동에 필요한 수평 힘은 배포 시스템 47.3 N, Mobile ALOHA 13.0 N인 데 비해 이 platform은 2.3 N에 불과합니다.
Visual Processing
- 시연 영상에서 운영자의 손을 지우는 단계입니다 [Figure 7].
- CaRE-Ego가 keyframe에서 hand mask를 예측하고, 이를 prompt로 삼아 SAM2가 mask를 시간축으로 propagate합니다. 이후 DiffuEraser가 optical-flow 기반 propagation과 diffusion inpainting으로 가려진 영역을 복원합니다.
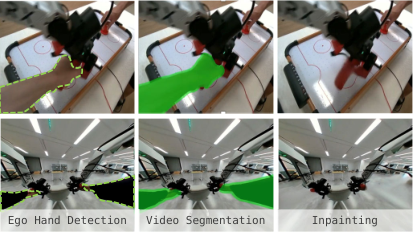
Figure 7 — 손 제거 시각 처리
Base Motion Alignment
- 두 encoder로 측정한 platform wheel velocity(u_L, u_R)를 affine mapping으로 배포 base의 linear velocity와 angular velocity(v, ω)로 변환합니다.
- 배포 base의 action–state delay를 추정해 시간축을 맞추고, 누적 오차를 피하기 위해 pose 대신 velocity를 action representation으로 사용합니다.
Policy Learning
- pretrained π0.5 VLA를 fine-tuning했습니다. 입력은 head camera 1개와 wrist camera 2개의 이미지이며, arm action과 base velocity를 단순히 concatenate해 action vector로 사용합니다.
- inference에는 asynchronous RTC를 적용했습니다.
핵심 결과
- Data Collection Efficiency [Figure 8]
- 성공한 시연의 평균 소요 시간이 최대 66% 줄었습니다.
- Mobile ALOHA 대비 Push Chair에서 2.9×, Disassemble Lego에서 2.8× 빨랐고, Disassemble Lego의 시연 success rate는 20%p 높았습니다.
- Dexterity
- sub-millimeter 정밀도가 필요한 Zip-Tie Fastening에서 HALO는 30.0% success rate(평균 41초)를 기록했습니다. ALOHA와 VR은 둘 다 0%였습니다.
- Coordinated Whole-body Control
- Disassemble Lego는 75.0%(30/40), 6-stage long-horizon box manipulation은 73.3%(11/15)를 달성했습니다.
- 같은 수집 시간 예산으로 학습한 VR과 Mobile ALOHA policy는 두 task 모두 실패했습니다.
- Ablation
- Push Chair에서 hand removal을 적용하면 success rate가 55% → 85%로 올랐습니다.
- synchronous inference의 success rate는 0~35%에 그친 반면, asynchronous inference(execution horizon 8)는 85%로 가장 높았습니다.
- pretrained VLA 기준으로는 joint-space action(75.0%)이 EEF action(47.5%)보다 우수했습니다.
- Generalization
- 초기 위치를 2–3 m 범위로 무작위화하고 처음 보는 환경에서 실험했을 때도 Push Chair policy가 일반화되었습니다. Mobile ALOHA 실험의 초기 위치 변동은 5–10 cm 수준이었습니다.
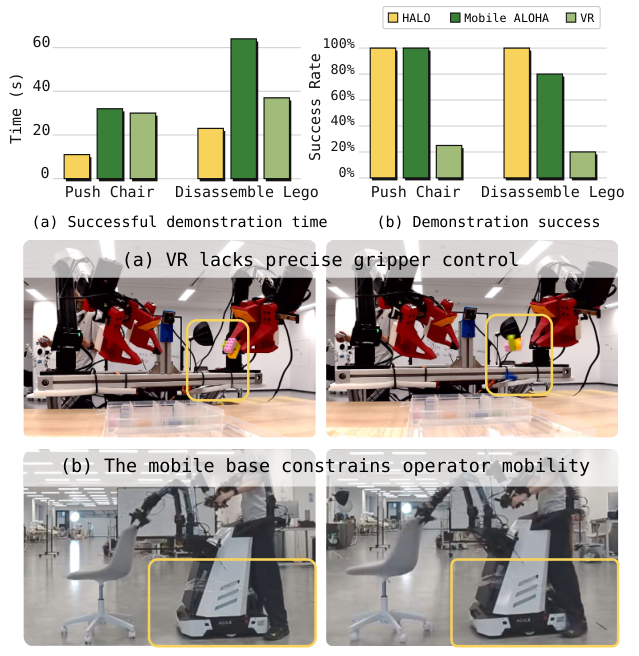
Figure 8 — 수집 효율 비교
4. Conclusion & Impact (결론 및 시사점)
HALO는 "사람이 로봇에 맞추는 대신 로봇 인터페이스가 사람의 능력에 맞춰야 한다"는 원칙을 따릅니다. 이를 통해 효율적이고 정밀한 whole-body mobile manipulation 데이터 수집과 robust한 policy learning이 가능함을 실험으로 보였습니다. 핵심은 kinesthetic teaching과 base-free passive platform으로 perception gap과 mobility gap을 함께 줄이고, 사람–로봇 밀착 때문에 생기는 visual shift와 control shift는 deployment-aligned 후처리로 완화한 것입니다.
학계 관점에서는 별도의 hierarchical controller 없이 arm action과 base action을 concatenate한 단순한 unified VLA policy만으로도 강한 whole-body coordination이 가능하다는 근거를 제시했습니다. 또한 asynchronous inference와 replanning horizon 선택이 성능에 큰 영향을 준다는 점도 보여주었습니다. 산업계 관점에서는 저비용 passive platform과 retargeting-free action으로 수집 효율을 최대 2.9× 높여, mobile manipulator 데이터를 대규모로 수집하는 현실적인 대안이 될 수 있습니다. 향후 과제로는 사람의 시각 행동을 더 가깝게 반영하기 위한 active perception 도입이 제시되었습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] OASIS: From Simulation Data Collection to Real-World Humanoid Loco-Manipulation
- [논문리뷰] HiFi-UMI: Learning Deployable Manipulation Policies from High-Fidelity UMI Data Alone
- [논문리뷰] VLASH: Real-Time VLAs via Future-State-Aware Asynchronous Inference
- [논문리뷰] EVA-Client: A Unified Data Collection, Inference, and Deployment Framework for Embodied Policies on Real Robots
- [논문리뷰] HuGe: Scaling Humanoid Generalist Vision-Language-Action Models with Egocentric Experience
Review 의 다른글
- 이전글 [논문리뷰] Gamer: A Generalist Vision-Language-Action Foundation Model for Long-Horizon Real-Time Game Agent
- 현재글 : [논문리뷰] HALO: Human-Aligned Data Collection for WhoLe-body MObile Manipulation
- 다음글 [논문리뷰] Interpreting Coding Agents Through Their Behavioral Trajectories
댓글