[논문리뷰] MIRIX-2.0: Multi-Agent Memory System
링크: 논문 PDF로 바로 열기
저자: Wei-Chieh Huang, Weizhi Zhang, Jiayan Nan, Peng Xia, Yu Wang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Typed Evidence Plane: Meta Memory Manager가 입력을 6개 memory type(Core, Episodic, Semantic, Procedural, Resource, Knowledge Vault)별 writer로 route해서 complete record를 저장하는 vector database 계층입니다. 이 계층이 system of record 역할을 합니다. 각 record는 immutable row ID, event time, mention time, provenance, embedding을 가집니다.
- Provenance Hypergraph: Episodic/Semantic record를 indexing하는 계층입니다. Anchor(entity/concept), n-ary fact frame, role-typed incidence edge로 구성됩니다. 모든 frame은 자신이 추출된 원본 row ID(citation)를 가지며, 날짜·가격·개수 같은 값은 literal로 frame에 붙어 있습니다. Graph는 index일 뿐이고 원본 데이터는 vector DB에 남습니다.
- Occurrence Identity: Semantic frame은 predicate와 role-anchor 집합으로 식별됩니다. Episodic frame은 여기에 occurrence key가 추가됩니다. 그래서 같은 dated event에 대한 반복 언급은 하나의 frame으로 합쳐지고, 표현이 비슷하더라도 서로 다른 undated event는 분리된 채로 유지됩니다.
- Graph-owned Evidence Retrieval: Deterministic planner가 query operator(single, temporal, intersection, list-union, count)에 따라 explicit budget을 정합니다. 예를 들어 single은 base 6 rows와 cited 4 rows, count는 8 rows와 12 rows입니다. Retrieval은 graph anchor에서 시작하는 두 evidence lane으로 bounded evidence set을 만듭니다.
- AutoDream: Write path 밖에서 동작하는 consolidation 모듈입니다. Semantic memory에서는 중복 anchor만 LLM 검증을 거쳐 merge하고 저장된 record는 수정하지 않습니다. Procedural memory에서는 task session을 lesson과 mistake로 distill한 뒤 curator가 skill을 생성하거나 수정합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문이 해결하려는 문제는 LLM agent의 long-term memory가 accurate, practical, efficient라는 세 요구사항을 동시에 충족하지 못한다는 점입니다. 기존 계열의 한계는 다음과 같습니다.
- Consolidation 기반 시스템(mem0 등): 저장 공간은 compact하지만, 추출 과정에서 버려진 detail은 영구히 손실됩니다.
- 모든 record를 보존하는 시스템: 정보 손실은 없지만, history가 커질수록 retrieval 비용과 noise가 함께 증가합니다.
- Graph memory(Graphiti 등): Binary triple이 n-ary fact를 조각내서 participant 사이의 연결이 사라집니다.
- Hypergraph memory(HyperMem)와 file-system memory(Claude Code auto memory): 저장 시점에 작성된 topic summary를 따라 top-down으로 pruning합니다. 그래서 summary에 반영되지 않은 detail은 recall이 떨어집니다.
- Parametric memory: Training이 필요하고 closed model에는 적용할 수 없어서 practicality가 낮습니다.
또한 user-centric memory(넓은 기록과 연결이 필요)와 agent-centric memory(정제된 skill이 필요)는 서로 반대되는 요구를 가집니다. 저자들은 이 둘을 하나의 store로 처리해야 한다고 주장합니다 [Figure 2] [Figure 3]. 이 요구는 기술적으로 Source fidelity, Bounded access, Temporal identity 세 가지로 정식화됩니다.
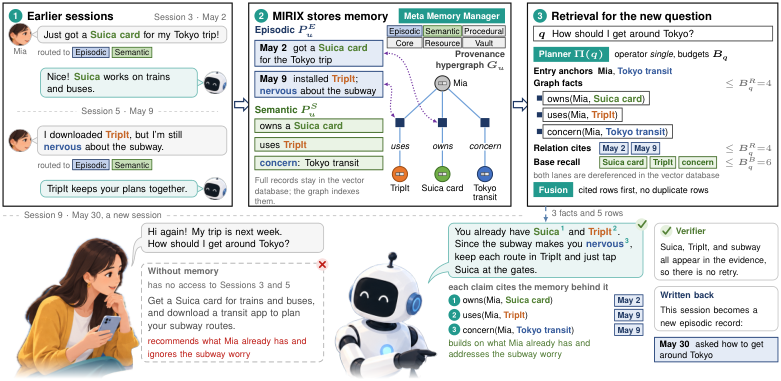
Figure 2 — User-centric 메모리 예시
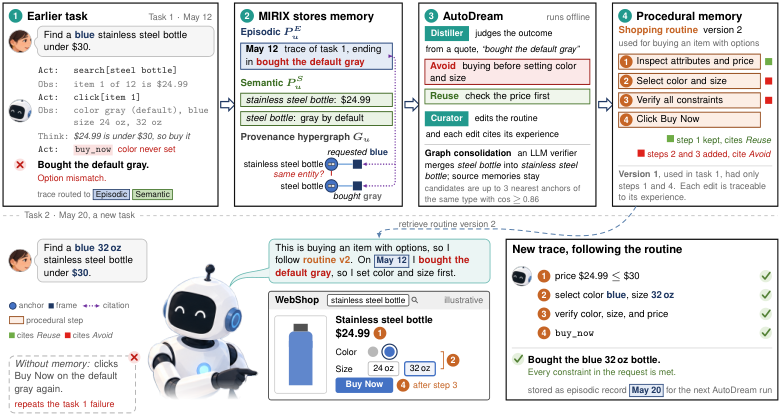
Figure 3 — Agent-centric 메모리 예시
3. Method & Key Results (제안 방법론 및 핵심 결과)
MIRIX-2.0은 storage와 indexing을 분리하는 layered 설계로 세 요구사항을 동시에 충족합니다.
방법론
- Write path: Record를 vector DB에 먼저 commit한 다음 hypergraph를 구축합니다. Graph write가 실패해도 저장된 memory는 rollback되지 않습니다(fail-soft).
- Hypergraph 구축:
- Extractor는 예를 들어 비행 정보를 agent, origin, destination, carrier, companion arm을 가진 단일 frame으로 표현합니다.
- Registry-guided canonicalization 단계에서는 ANN 후보에 대해 LLM이 보수적으로 same-entity를 판정합니다.
- Read path:
- Query embedding으로 15개 anchor를 recall합니다. 이후 base-recall lane과 relation-citation lane(cap 240 frames)을 거쳐 additive fact score로 frame을 ranking합니다.
- Citation-balanced fusion으로 graph fact와 원본 source row를 함께 반환합니다 [Figure 2].
- 이 구조 덕분에 query가 검사하는 evidence의 양은 history 길이와 무관하게 bounded됩니다.
- AutoDream:
- Semantic 쪽은 새로 쓰인 semantic frontier에 대해서만 동작하므로 비용이 전체 memory 크기가 아니라 신규 activity에 비례합니다. Identity-stable type(person, location 등) anchor 쌍만 merge합니다.
- Procedural 쪽은 실패한 구매 같은 session을 experience와 revised routine으로 바꿉니다 [Figure 3].
- Fine-tuning은 필요 없고, closed model과 open model 모두에서 동작합니다.
핵심 결과
- Conversational QA
- LoCoMo: M0(flat, 85.7%) → M1(+graph, 88.4%) → M2(+AutoDream, 91.4%)로 올라갑니다. HyperMem(91.0%, 저자 재현값)보다 0.4p 높습니다.
- Graph 추가 시 multi-hop이 +5.7p 향상되고, AutoDream 추가 시 temporal이 +3.4p 향상됩니다.
- LongMemEval-S: 72.6%로 strongest baseline보다 14.3p 높습니다. Graph 단독 기여는 +11.2p입니다.
- Document QA (M1, AutoDream 비활성)
- SHDocQA 83.0%, MHDocQA 71.0%로 HyperMem 대비 각각 +31.0p, +22.0p입니다.
- 반면 DetectiveQA에서는 64.8%로 MemoryBank(67.6%)보다 낮습니다.
- MemoryCD: Cross-domain review summarization에서 4개 metric 모두 최고입니다(예: ROUGE-L .1510 vs .1430).
- Procedural memory
- ALFWorld (GPT-6 Luna): 76.4%로 AWM 73.6%, no-memory 69.4%보다 높습니다.
- WebShop: 37.4%로 AWM 36.0%보다 높습니다.
- MetaClaw-Bench (GPT-5.2): 49.2%로 MetaClaw Skills 44.0%보다 높고, completion도 17.1%에서 27.7%로 올라갑니다.
- Efficiency
- M1은 5개 benchmark 모두에서 HyperMem보다 answer latency가 짧습니다(예: SHDocQA 5.45s vs 10.55s).
- 대신 document ingestion이 M0 대비 3.8–4.0배 느려집니다.
- WebShop에서는 memory method 중 training/test token이 최소입니다(1.815M / 4.975M).
4. Conclusion & Impact (결론 및 시사점)
저자들의 결론은 complete record를 system of record로 유지하고, graph는 bounded index로만 쓰며, consolidation이 "어떤 evidence가 존재하는가"가 아니라 "evidence가 어떻게 연결되는가"만 바꾸도록 하면 memory layer가 accurate, practical, efficient를 동시에 달성할 수 있다는 것입니다.
MIRIX-2.0은 비교 대상 시스템 중 5개 QA benchmark 가운데 4개에서 가장 높은 정확도를 기록했습니다. 저자들은 하나의 store로 user-centric과 agent-centric memory를 모두 처리하는 최초의 시스템이라고 주장합니다.
다만 저자들이 밝힌 한계는 다음과 같습니다.
- Ablation이 component를 그룹 단위로 추가하는 방식이라 n-ary frame, citation, occurrence identity 각각의 기여가 분리되지 않았습니다.
- User-memory 결과는 single run이며 일부 LLM judge로 채점되었습니다.
- AutoDream을 포함한 full system(M2)의 latency는 측정되지 않았습니다.
산업적으로는 traceable answer(citation), consolidation 중 데이터 손실 방지, fine-tuning 없는 배포 가능성을 보여줬다는 점에서 실제 agent memory 설계에 직접적인 참고가 됩니다. 함께 고려할 점도 있습니다. Graph를 구축하는 비용이 ingestion 단계로 옮겨가고, latency·token·accuracy는 각각 따로 평가해야 하는 trade-off라는 점입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] MEM-SQL: Memory-Empowered Text-to-SQL
- 현재글 : [논문리뷰] MIRIX-2.0: Multi-Agent Memory System
- 다음글 [논문리뷰] MMFlash: Faster Speculative Decoding for Vision-Language Models
댓글