[논문리뷰] SWE-CoWork: Benchmarking Coding Agents as Digital Employees in Organizations
링크: 논문 PDF로 바로 열기
저자: Xinping Lei, Minghao Liu, Ruijie Zhu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- SWE-CoWork: coding agent가 software organization 안에서 "digital employee"로 일하는 능력을 평가하는 benchmark입니다. 101개 repository에서 가져온 101개 development assignment로 구성되며, 11개 programming language와 12개 application domain을 포함합니다.
- Digital Employee: 각 task마다 배치되는 26명의 동료로, rule에 따라 동작하는 LLM 기반 모델입니다. benchmark 전체로는 2,626개 profile이 있습니다. 각 동료는 Responsibility, Local Knowledge, Collaboration Behavior라는 세 가지 속성을 가집니다. 충분한 code context가 주어질 때만 requirement를 공개하고, reproduction을 요청하거나, 다른 owner에게 referral하거나, 답변을 defer할 수 있습니다.
- F2P / P2P (Fail-to-Pass / Pass-to-Pass): 새 behavior가 구현됐는지 확인하는 test node(F2P)와 기존 behavior가 유지되는지 확인하는 test node(P2P)입니다. release 전체에서 F2P는 2,699개, P2P는 562개입니다. Pass rate는 한 run에서 모든 F2P와 P2P를 통과해야 성공으로 인정하는 complete task success입니다.
- Oracle-Spec: repository, test, scaffold, execution budget은 동일하게 두고 전체 requirement만 처음부터 제공하는 paired condition입니다. requirement acquisition 단계의 실패와 implementation 단계의 실패를 분리하는 데 쓰입니다.
- Handoff / Onboarding Note: agent가 진행 중인 assignment에 투입될 때 받는 짧은 인계 메모입니다. 나머지 acceptance criteria는 project board, versioned document, chat, MR/CI record, 그리고 동료들에게 분산되어 있습니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문은 기존 coding benchmark가 coding agent를 미리 범위가 정해진 spec을 수행하는 *"spec executor"*로만 평가하고, 조직 안에서 요구사항을 직접 확보하고 검증된 결과를 인계하는 능력은 측정하지 못한다는 문제를 다룹니다. 실제 software engineering에서는 requirement가 여러 stakeholder와 record에 흩어져 있습니다. 게다가 superseded design document, 오래된 revision의 CI 결과, 실행 중에 새로 드러나는 trace처럼 서로 충돌하는 evidence를 조정해야 합니다.
기존 연구의 한계는 다음과 같습니다.
- DeepSWE, SWE Atlas, FrontierSWE, CursorBench 같은 benchmark는 이미 정해진 development objective를 agent에게 줍니다.
- RealSWE, Ask or Assume, τ^τ-Bench 같은 underspecification 연구는 고정된 request의 정보량만 바꾸거나, 지정된 단일 user 또는 client에게 질문하는 구조입니다.
따라서 multi-owner 조직에서 owner를 찾고, deferred question을 끝까지 follow-up하고, 구현·검증·handoff까지 requirement 상태를 계속 추적하는 능력을 End-to-End로 평가할 환경이 필요하다고 저자들은 주장합니다. 저자들은 이 능력을 Continuous, Proactive, Efficient, Persistent의 네 가지로 정의합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
SWE-CoWork는 실제 open-source repository에 저자들이 직접 작성한 workplace를 결합하고, 모든 scored requirement를 accountable owner, discovery route, executable F2P/P2P test에 연결합니다. 이 연결 덕분에 requirement 하나를 최초 질문부터 delivery까지 추적할 수 있습니다.
환경 구성
- 각 조직은 target project 1개와 neighboring project 4개로 이루어집니다.
- task당 requirement 보유자는 중앙값 6명입니다.
- 중앙값 기준으로 task 하나가 60개 파일에 2,955줄의 production code를 추가하고, 32개 test node로 채점됩니다.
- benchmark 전체에 40,836개 chat message가 들어 있습니다.
Agent의 작업 방식
- agent는 전용 tool interface로 staff directory, board, versioned document, chat, MR/CI를 조회하고 동료에게 메시지를 보냅니다.
- 작업은 Orient → Investigate → Ask → Build & Verify → Revise → Deliver 순서이지만, 실제로는 이 단계들이 서로 섞여 진행됩니다.
- execution budget은 8시간입니다.
주요 결과
- Partial delivery와 complete success 사이의 큰 격차
- Claude-Opus-5.5와 GPT-6 Astra의 F2P는 각각 63.84%와 62.91%입니다.
- 그러나 complete pass rate는 6.93%와 7.92%에 그칩니다.
- 나머지 9개 model은 F2P가 최대 39.09%, pass rate가 최대 0.99%입니다.
- P2P는 81.85–95.20%로 상대적으로 높습니다. 기존 behavior를 유지하는 것보다 새 requirement를 구현하는 것이 병목이라는 뜻입니다.
- Requirement acquisition이 delivery를 좌우함
- 동료가 보유한 requirement의 획득률과 F2P의 상관은 Spearman ρ=0.94입니다. 반면 tool-call 수와의 상관은 ρ=0.08에 불과합니다 [Figure 5].
- DeepSeek V4 Pro는 동료 메시지가 run당 중앙값 0건이고, requirement 획득률은 1.8%, F2P는 13.04%입니다.
- 조사량보다 implementation 전환 시점과 소통 빈도가 중요함
- workplace query 수는 F2P와 거의 무관합니다(ρ=−0.10, −0.17).
- 첫 code edit이 이를수록(ρ=−0.62), 동료와 더 자주 소통할수록(ρ=0.71) F2P가 높습니다 [Figure 6].
- 저자들은 이것이 cross-model 상관일 뿐 인과관계는 아니라고 명시합니다.
- Oracle-Spec 비교
- Seed Evolving은 F2P가 39.09%에서 55.76%로 +16.67%p, GPT-6 Astra는 62.91%에서 78.84%로 +15.93%p 올랐습니다.
- 그러나 pass rate는 0.99%와 7.92%로 변화가 없었습니다.
- 즉 requirement를 모두 갖고 있어도 implementation과 verification 단계에서 실패가 남습니다.
- Claude-Opus-5.5 trajectory 분석
- Clarification: 질의한 card의 93%에서 첫 질문을 올바른 owner에게 보냈지만, 동료 보유 requirement는 64%만 획득했습니다. 놓친 requirement 중 연락하지 않은 owner의 몫은 3%뿐이고, 대부분은 이미 연락한 owner에게 해당 card를 묻지 않은 경우(17%)와 질문했지만 답을 얻지 못한 경우(16%)입니다.
- Follow-up: owner가 답변을 defer한 thread 450개 중 153개는 follow-up 없이 방치됐습니다. 이 thread들은 deferral 시점에 budget이 중앙값 7.1시간 남아 있었습니다.
- Implementation: requirement에 연결된 failed test의 56%는 requirement를 이미 확보했는데도 구현에 실패한 경우입니다.
- Handoff: 완료라고 보고한 requirement 826개 중 255개(31%)가 test에 실패했습니다. 미해결 requirement에 실행 가능한 다음 단계가 남아 있는데 멈춘 premature stop도 49건 관찰됐습니다.
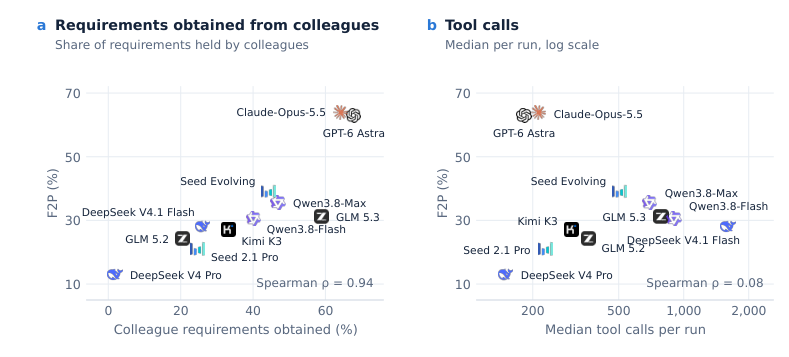
Figure 5 — 요구사항 획득률과 F2P
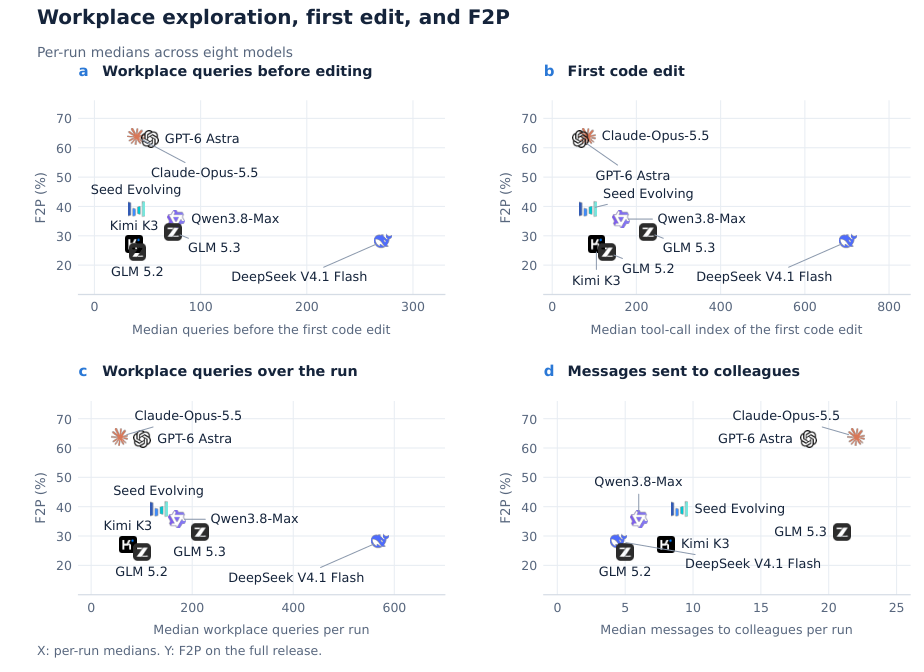
Figure 6 — 탐색·소통과 F2P
4. Conclusion & Impact (결론 및 시사점)
이 논문의 결론은 신뢰할 수 있는 autonomous software engineering의 핵심 과제가 sustained requirement tracking이라는 것입니다. 즉 clarification, implementation, verification, handoff 전 과정에 걸쳐 각 requirement의 상태를 계속 유지해야 합니다. 최상위 model들도 올바른 동료는 찾아내지만, 다음과 같은 지점에서 requirement를 잃습니다.
- deferred question을 방치함
- 확보한 requirement를 구현하지 못함
- 완료 여부를 실제 test 결과와 다르게 보고함
학계 측면에서는 single-spec이나 single-user clarification 위주였던 평가를 multi-owner 조직 환경으로 확장했습니다. 또 Oracle-Spec paired 비교와 requirement-level trajectory 분석이라는 진단 방법론을 제시했습니다.
산업계 측면에서는 agent를 "spec executor"에서 실제 업무를 위임받는 digital employee로 발전시키려면 code generation 능력만으로는 부족하다는 점을 보여줍니다. requirement별로 owner, 미해결 질문, 구현 상태, 검증 evidence, handoff claim을 명시적으로 추적하는 설계가 필요하다는 것입니다. 다만 저자들은 이런 tracking이 실제로 End-to-End delivery를 개선하는지는 open question으로 남겨 둡니다. 저자들은 향후 SWE-CoWork를 여러 agent로 구성된 팀을 평가하는 데까지 확장할 수 있다고 봅니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] SWE-Touch: Benchmarking Coding Agents When Users Touch the Code
- [논문리뷰] WideSWE: Can Coding Agents Coordinate Changes Across Repositories?
- [논문리뷰] CrossSWE: Benchmarking Cross-Repository Joint Development for Coding Agents
- [논문리뷰] SWE-Explore: Benchmarking How Coding Agents Explore Repositories
- [논문리뷰] FINCOSMOS: An Open-World Evaluation Paradigm for Agents in Finance
Review 의 다른글
- 이전글 [논문리뷰] SPILLWAY: Separating Target Admission from Sanitization to Defend Tool-Using Agents against Prompt Injection
- 현재글 : [논문리뷰] SWE-CoWork: Benchmarking Coding Agents as Digital Employees in Organizations
- 다음글 [논문리뷰] Sage S2.1 Flash Technical Report
댓글