[논문리뷰] Termination Lag: Coding Agents Solve Early but Stop Late
링크: 논문 PDF로 바로 열기
저자: Musa Cim, Burak Topcu, Mahmut Taylan Kandemir (The Pennsylvania State University)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Time to First Correct Patch (TTFCP): Agent trajectory에서 repository patch가 공식 benchmark test를 처음으로 통과하는 step(F)이다. 단위는 agent step이다.
- Termination Lag (TL): 첫 correct patch가 나온 뒤 agent가 스스로 종료할 때까지 더 실행한 step 수로, TL = S − F로 정의된다(S는 종료 step).
- Normalized Termination Lag (NTL): 길이가 다른 trajectory를 비교하기 위한 지표다. NTL = (S − F) / S로 계산하며, 전체 실행 중 첫 correct patch 이후에 해당하는 비율을 뜻한다.
- First Patch / Attempts until correct: First patch는 첫 source-code edit 직후에 기록된 patch다. Attempts는 첫 correct patch를 포함해 그때까지 생성된 distinct patch의 수다.
- Per-step Patch Recording: Logging proxy가 매 step마다 base commit 대비 diff를 temporary Git index로 저장한다. 저장된 patch는 실행이 끝난 뒤 격리된 container에서 offline으로 평가한다. Agent는 이 평가 결과를 받지 않으므로 측정이 agent의 행동에 영향을 주지 않는다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문은 coding agent가 정답 patch를 언제 처음 만들었는지, 그리고 그 뒤로 얼마나 불필요하게 계속 작동하는지가 기존 final-patch 평가로는 드러나지 않는다는 문제를 다룬다. SWE-bench 같은 benchmark는 최종 제출 patch의 correctness만 채점한다. 그래서 step 10에서 정답을 내고 바로 제출하는 agent와, 같은 정답 뒤에 40 step을 더 쓰는 agent가 같은 점수를 받는다. 또 실행 중간에 correct patch를 만들었다가 이후 edit로 망가뜨린 경우에는 실패한 제출 결과 뒤에 "이미 풀었던 task"가 가려진다. 결국 final-patch 평가는 올바른 fix를 만드는 능력과 fix가 끝났음을 알아보는 능력을 구분하지 못한다. 추가 step마다 커지는 context 위에서 model call이 반복되므로 token, Latency, compute 비용이 늘고, 이미 작동하는 코드를 깨뜨릴 위험도 생긴다. 기존 연구는 overthinking, 비용 분석, 성공·실패 예측 기반 early termination을 다뤘지만, repository 수준에서 첫 correct patch부터 종료까지의 step 수를 체계적으로 정량화하지는 않았다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 agent가 실행하는 매 step의 repository patch를 기록하고, 이를 사후에 공식 benchmark test로 평가하는 empirical characterization framework를 제안한다. 주 framework는 OpenHands이고, 일반화 검증을 위해 mini-SWE-agent도 사용한다. 평가 대상은 다음 5개 model이다.
- Open-source(vLLM, Aurora에서 serving): Qwen3-Coder-30B-A3B, Laguna-XS.2, Seed-OSS-36B
- Closed-source(API): Claude Haiku 5.5, GPT-6 Luna
Benchmark는 SWE-bench Verified(500 tasks, Python), SWE-bench Multilingual(300 tasks, 9개 언어), SWE-bench Pro의 3개다. Core setting은 Qwen3-Coder와 Laguna-XS.2를 Verified와 Multilingual에서 돌린 조합이다. 첫 correct patch 이후의 step은 recorded tool과 argument에 대한 rule로 분류했다. 분류 범주는 Verify, Explore, Edit, Wrap-up, Think/other다. 연구 질문은 RQ1(첫 edit), RQ2(TL), RQ3(post-fix activity), RQ4(correctness 영향) 네 가지다.
주요 정량 결과:
- Correct patch는 이른 시점에 나온다 (RQ1): Correct patch에 도달한 run 중 첫 source-code edit가 이미 정답인 비율은 다음과 같다. 전체 범위는 38–82%이고, correct patch까지 평균 1.3–3.6개의 distinct patch가 필요했다.
- Qwen3-Coder: Verified 82%, Multilingual 66%
- Laguna-XS.2: Verified 70%, Multilingual 48%
- GPT-6 Luna(Verified): 80%
- Seed-OSS(Pro): 38%
- Termination Lag는 상당히 크다 (RQ2): Qwen3-Coder on Verified에서 첫 correct patch 도달 곡선이 정답 상태로 종료한 run의 곡선보다 일찍 상승한다. 해당 setting의 median TL은 16 step, median NTL은 35%였다 [Figure 1]. Setting별 median 값은 다음과 같다.
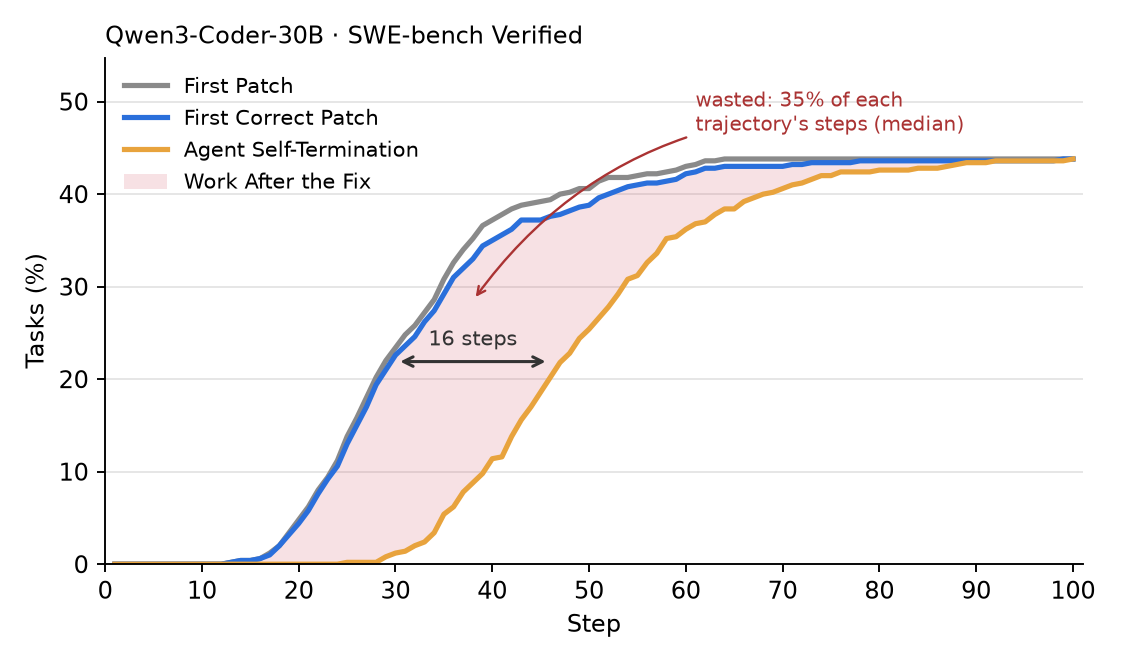
Figure 1 — 첫 정답 vs 종료 시점
| Model | Benchmark | Median TL | Median NTL |
|---|---|---|---|
| Qwen3-Coder | Multilingual | 18 step | 37% |
| Laguna-XS.2 | Verified | 57 step | 60% |
| Laguna-XS.2 | Multilingual | 56 step | 54% |
| Claude Haiku 5.5 | Verified | 10 step (첫 correct patch는 9 step) | 54% |
| GPT-6 Luna | Verified | 6 step | 36% |
| Qwen3-Coder (mini-SWE-agent) | Verified | 12 step | 37% |
Laguna-XS.2의 lag가 특히 크다 [Figure 5]. 첫 correct patch 시점에 멈추는 oracle을 가정하면, 원래 풀렸던 task를 하나도 잃지 않으면서 solved run step의 median 35–60%를 줄일 수 있다. 첫 correct patch 이후 종료까지 input context도 +28%~+78% 증가했다.
- 추가 step의 대부분은 검증과 탐색이다 (RQ3): Post-fix step 중 Verification이 48–63%, Exploration이 15–29%를 차지한다. Source-code 재수정은 2–6%로 드물고, Seed-OSS on Pro만 예외적으로 19%였다 [Figure 9].
- 계속 작업하면 regression이 생길 수 있다 (RQ4): Correct patch에 도달한 run 중 61–96%는 정답을 끝까지 유지했다. 반면 1–8%는 이후 edit가 정답을 깨뜨려 incorrect patch로 끝났다. 망가졌다가 다시 고쳐진 경우도 Laguna-XS.2 Multilingual에서 31%에 달했다.
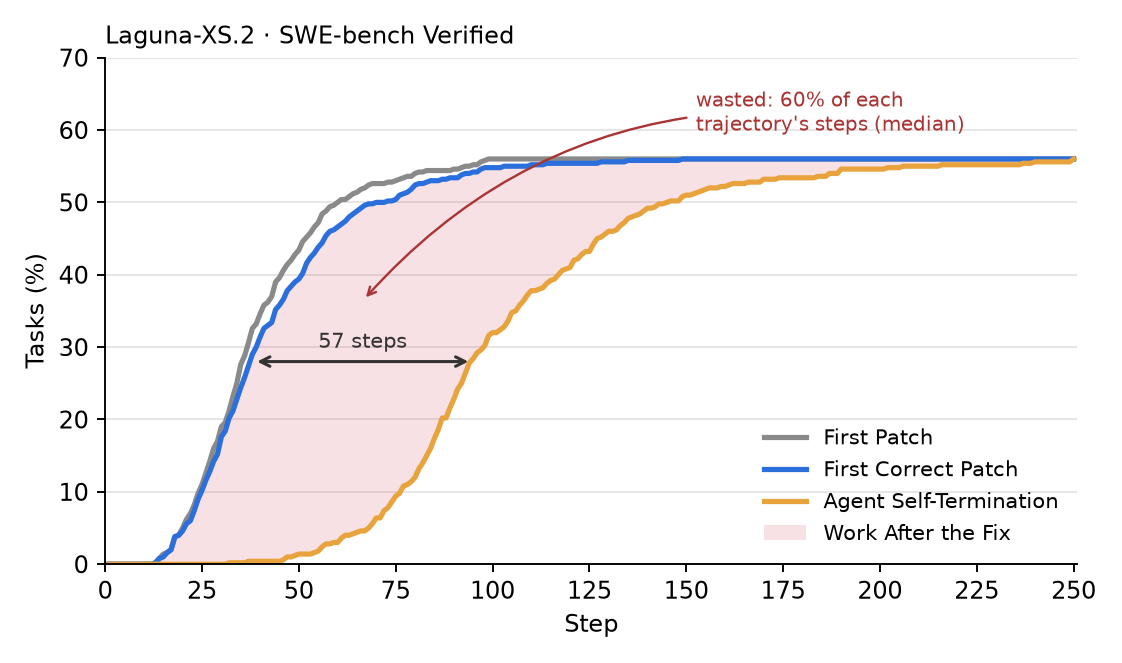
Figure 5 — Laguna-XS.2의 큰 지연
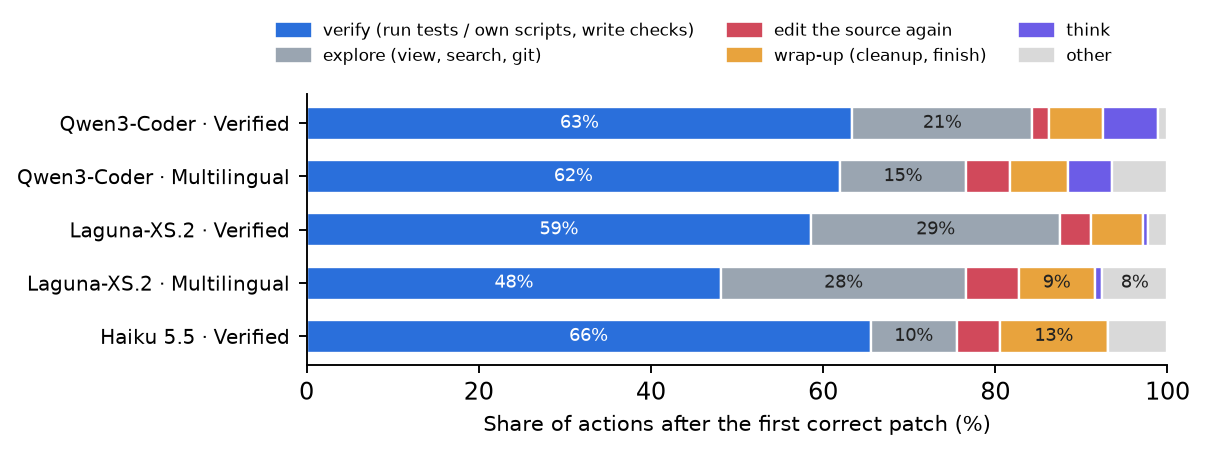
Figure 9 — 정답 이후 행동 비율
4. Conclusion & Impact (결론 및 시사점)
이 논문은 3개 benchmark, 5개 model, 2개 agent framework 전반에서 "task를 푸는 시점"과 "멈추는 시점" 사이에 일관된 gap이 있다는 결론을 내린다. Core setting에서 solved run step의 median 35–60%가 첫 correct patch 이후에 쓰이며, 대부분은 verification과 exploration이다. 이후 edit가 fix를 깨뜨리는 경우도 있다. 저자들은 이를 근거로 stopping behavior를 agent 성능의 별도 축으로 보고, correctness에 언제 도달했는지와 끝까지 유지했는지를 함께 평가해야 한다고 주장한다.
시사점:
- 산업계: TL은 이상적인 stopping rule이 아낄 수 있는 비용의 상한을 보여 준다. 이는 agent 운영 비용(token, Latency) 절감 연구에 직접적인 reference point가 된다.
- 학계: Final solve rate만 보는 benchmark 관행을 보완할 수 있도록, trajectory 수준의 시간적 지표(TTFCP, TL, NTL)를 도입할 근거를 제공한다.
한계:
- Task당 1회만 실행했다.
- 비용을 직접 측정하지 않고 step 수로 근사했다.
- Step 분류가 rule 기반이다.
- Seed-OSS on Pro는 풀린 task가 적어 표본이 작다.
- 실제 run 중에 쓸 수 있는 실용적인 stopping rule은 제시하지 않았고, 향후 과제로 남겨 두었다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Interpreting Coding Agents Through Their Behavioral Trajectories
- [논문리뷰] SlopCodeBench: Benchmarking How Coding Agents Degrade Over Long-Horizon Iterative Tasks
- [논문리뷰] SWE-Trail: History-Guided Trajectory Collection for Coding Agent Training
- [논문리뷰] Read Less, Solve More: Token-Efficient Sparse Reading of External Content for AI Agents
Review 의 다른글
- 이전글 [논문리뷰] ScaleVLA: Scaling Vision-Language-Action Models to 552 Billion Parameters
- 현재글 : [논문리뷰] Termination Lag: Coding Agents Solve Early but Stop Late
- 다음글 [논문리뷰] UMM-JEPA: Generative Pretraining via Masked Next-Scale Representation Prediction for Unified Multimodal Models
댓글