[논문리뷰] Regularized Score Centering
링크: 논문 PDF로 바로 열기
저자: Hao Bai, Chenlu Ye, Xuanchang Zhang, Aviral Kumar, Tong Zhang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Score Centering (SC): Learner score(∇log π_θ)에서 behavior policy μ 아래의 conditional mean을 빼는 기법입니다. Action과 무관한 reward baseline이 gradient에 남기는 baseline-induced drift를 full IS 없이 expectation 수준에서 제거합니다. 이 기법은 Marek & Ryabinin(2026)이 제안했습니다.
- Truncated Importance Sampling (TIS): Token importance ratio ρ = π_θ/μ를 [c_low, c_high] 구간으로 clip하는 방식입니다. 본 논문은 CISPO 형태를 사용합니다. Clipping bias를 감수하는 대신 극단적인 gradient를 억제합니다. SC without IS는 c_low = c_high = 1인 특수한 경우에 해당합니다.
- Regularized Score Centering (RSC): 본 논문의 제안 기법이며, 구성은 RSC = SC + KL (+TIS)입니다. 각 history에서 learner와 behavior policy의 next-token distribution 사이에 reverse KL(π_θ‖μ) penalty를 더합니다. RSC (w/o IS)와 RSC (TIS) 두 가지 variant가 있습니다.
- Sampler Refresh Interval (R) / Policy Staleness: Behavior policy μ를 고정한 채 learner가 수행하는 update 횟수입니다. R이 클수록 learner와 behavior policy 사이의 policy mismatch가 커집니다.
- Monte Carlo Centering: Conditional score mean을 μ에서 독립적으로 뽑은 auxiliary token으로 unbiased하게 추정하는 방법입니다. 기존 SC 구현의 Top-128 근사를 대체합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
SC는 baseline 문제를 해결하지만, learner가 behavior policy에서 멀어지면 여전히 실패합니다. 본 논문은 이 문제를 KL regularization으로 해결하려 합니다.
-
Off-policy 상황의 발생: Async RL은 Throughput을 높이지만, stale policy가 만든 데이터와 training-inference numerical mismatch(TIM) 때문에 학습이 off-policy가 됩니다.
-
IS 계열의 한계: Full sequence-level IS는 token ratio를 곱하는 구조라서 variance가 극단적으로 커집니다. TIS는 clipping bias가 생기고, action을 구분하지 못하는 reward 성분이 update에 섞이는 문제도 남습니다.
-
SC의 한계: SC는 baseline contribution을 제거하지만 token advantage A_t^μ는 여전히 behavior policy의 continuation에 의존합니다. 실제로 학습해야 하는 learner advantage A_t^{π_θ}와 어긋날 수 있다는 뜻입니다.
-
실패가 두드러지는 조건: 이 괴리는 두 경우에 커집니다.
- Agentic task: Action이 이후 state와 선택지를 바꾸는 환경(예: Crafter)
- 높은 staleness: Sampler refresh interval이 긴 경우
실제로 R이 커질수록 SC의 성능이 저하됩니다 [Figure 6].
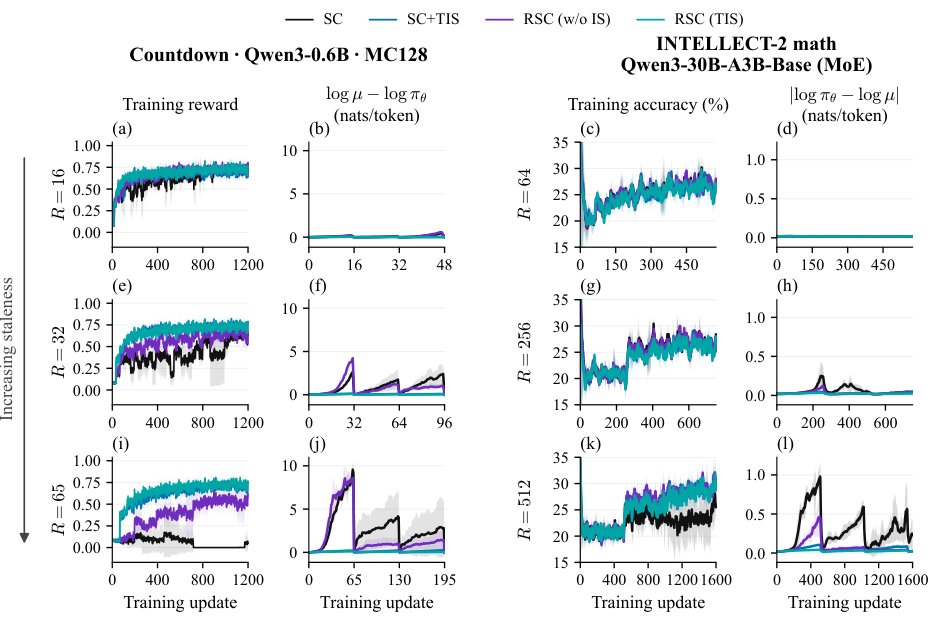
Figure 6 — Staleness별 SC 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
RSC는 SC의 baseline correction을 유지하면서 reverse KL로 behavior policy에서 멀어지는 정도를 제한합니다. 그 결과 6개 agentic task 모두에서 최고 성능을 달성했습니다 [Figure 1].
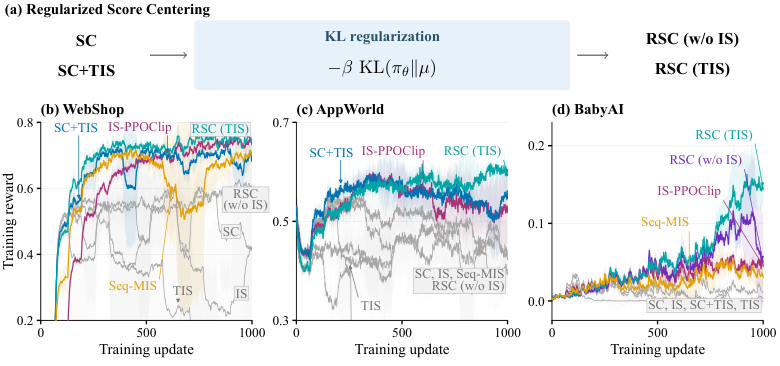
Figure 1 — RSC 개념과 학습곡선
방법론
- 목적함수: SC 또는 SC+TIS의 surrogate에서 β·KL(π_θ(·|h)‖μ(·|h))를 뺍니다. μ는 differentiation 동안 고정합니다. Sampler를 refresh할 때마다 KL reference도 함께 갱신되며, 추가 environment interaction은 필요하지 않습니다.
- Gradient 관점: ρ>1인 token에는 βρlogρ[1−π_θ] 항이 붙어 과도한 확률 증가를 억제합니다. Behavior probability가 낮은 token에서 99th percentile logit gradient norm이 추가로 감소합니다.
- Center 추정: Top-k 근사 대신 Monte Carlo centering을 사용합니다. 이 방식은 Countdown과 math 실험 모두에서 Top-128보다 높은 최종 성능을 보였습니다.
이론적 분석
- KL은 surrogate에 strong concavity를 부여합니다. 따라서 objective gap이 작으면 fitted policy가 improving target π⋆ ∝ μ·exp(A^μ/β)와 가깝다는 것이 보장됩니다.
- KL이 있으면 prefix와 response ratio의 bound가 response horizon H와 무관해집니다. 결과적으로 O(log(N/ε)) outer round만으로 best-of-N 수준의 reward에 도달할 수 있습니다.
- KL이 없으면 token radius가 1/(8H)로 줄어야 하고, 필요한 round 수도 O(H·log(N/ε))로 늘어납니다.
주요 실험 결과 (Qwen3-0.6B ~ Qwen3.5-35B-A3B-Base, dense 및 MoE 모델)
- Staleness 실험: 가장 긴 refresh interval의 Countdown에서 RSC (TIS)는 SC 대비 heldout reward를 절대값으로 약 65% 높였습니다. 이 우위는 Monte Carlo center를 사용한 경우에도 유지됩니다 [Figure 6].
- Math vs. Crafter: Dense 모델 math task에서는 KL 추가에 따른 정확도 변화가 1% 미만이었습니다. 반면 Crafter에서는 RSC (TIS)가 SC+TIS를 크게 앞섰습니다.
- Agentic 6개 task (Qwen3-4B-Base): RSC (TIS)가 모든 task에서 최고 성능을 기록했습니다.
- Crafter: 14.21로, IS-PPOClip(9.34) 대비 +52%
- Craftax: 4.71로, IS-PPOClip(4.04) 대비 +16%
- BabyAI: 18.06%로, IS-PPOClip의 9.9×
- WebShop: SC+TIS 대비 +43%
- AppWorld: SC 및 SC+TIS 대비 +14.3%
- Crafter와 Craftax에서는 같은 수의 sampled response로 더 높은 training reward를 얻어 sample efficiency도 개선되었습니다 [Figure 7].
- Fully async SWE (SWE-bench Verified, Average@8):
- LR 2×10⁻⁶ 설정에서 RSC (w/o IS)는 47.89(SC 21.13 대비 +127%), RSC (TIS)는 54.47(SC+TIS 36.04 대비 +51%)을 기록했습니다.
- LR 10⁻⁶ 설정에서는 RSC (w/o IS)의 61.14가 최고였지만, RSC (TIS)는 SC+TIS보다 낮았습니다. 저자들은 policy mismatch가 클수록 KL의 이득이 커진다고 해석합니다.
- 이 SWE 결과는 seed 1개짜리 단일 run에서 얻은 관찰적 비교라는 점에 유의해야 합니다.
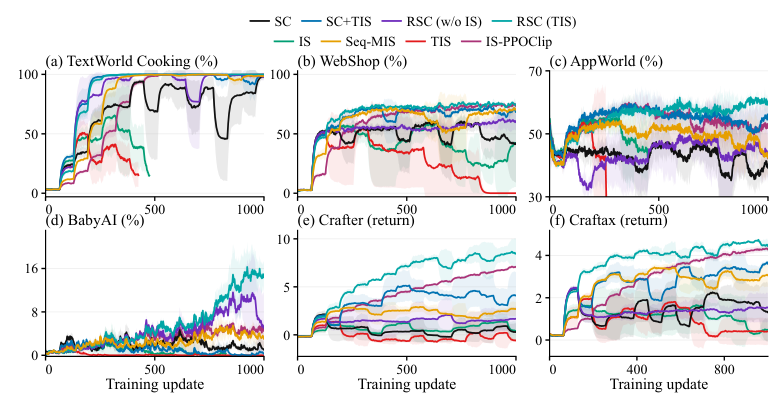
Figure 7 — 6개 agentic 학습곡선
4. Conclusion & Impact (결론 및 시사점)
RSC는 SC의 baseline correction과 reverse KL 기반 policy movement 제어를 결합해, stale data와 agentic 환경에서 off-policy RL을 안정화합니다. 이론적으로는 정확한 surrogate fitting이 실제 reward 향상으로 이어짐을 보였고, 이 보장은 horizon과 무관합니다. 실험적으로는 6개 agentic benchmark와 fully asynchronous SWE 환경에서 우위를 확인했습니다.
산업적으로는 production 수준의 async RL pipeline에서 큰 learning rate와 높은 off-policyness를 견디는 간단한 drop-in regularizer로 활용될 수 있습니다. 추가 rollout 비용이 없다는 점도 장점입니다. Staleness가 더 커질 때 RSC가 어떻게 동작하는지에 대한 empirical 분석은 future work로 남아 있습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] On KL-Regularized Policy Optimization
- [논문리뷰] Stale but Stable: Staleness-Adaptive Trust Regions for Stabilizing Asynchronous Reinforcement Learning
- [논문리뷰] Rethinking Training-Inference Mismatch in LLM Reinforcement Learning: Where It Arises and How to Correct It
- [논문리뷰] On the Origin and Evolution of Training-Inference Mismatch in LLM Reinforcement Learning
- [논문리뷰] ReSPO: Reshaped Sequence Policy Optimization for Gradient Starvation in Off-Policy Learning
Review 의 다른글
- 이전글 [논문리뷰] PanDWM: Panoramic 4D Driving World Models
- 현재글 : [논문리뷰] Regularized Score Centering
- 다음글 [논문리뷰] ResWAM: Learning What Changes, Not What Stays, for World-Action Models
댓글