[논문리뷰] The Attention Triangle in Audio-Video Models
링크: 논문 PDF로 바로 열기
저자: Sagi Polaczek, Noa Kraicer, Gal Metzer, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Attention Triangle: Text, Audio, Video 세 가지 모달리티 간의 Cross-Attention 관계를 나타내는 개념적 프레임워크로, 각 모달리티가 서로 영향을 주고받으며 생성에 제약을 가하는 시스템을 지칭합니다.
- Semantic Leakage (or Attribute Leakage): Diffusion Model에서 Attention 메커니즘이 의도된 대상 범위를 넘어 정보를 부적절하게 확산시켜, 한 엔티티에 대한 의미론적 속성이 다른 엔티티로 전이되거나 얽히는 현상입니다.
- Cross-modal Attention: 서로 다른 두 모달리티(예: Text와 Video, Audio와 Video)의 토큰 시퀀스 간에 정보를 연결하고 선택적으로 집중하는 메커니즘입니다.
- Source Attribution: 생성된 사운드의 출처가 특정 시각적 엔티티에 올바르게 할당되는지 여부를 나타내는 개념으로, 오디오-비디오 모델에서 중요한 Leakage 실패 유형 중 하나입니다.
- Inference-time Steering: 모델 재학습 없이 추론 과정에서 Attention 메커니즘에 직접 개입하여 생성 결과를 조절하는 기술을 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Audio-Video Diffusion Models에서 Cross-modal Attention 메커니즘이 유발하는 Semantic Leakage 문제를 해결하고자 합니다. 특히, Text, Audio, Video 간의 상호작용을 Attention Triangle로 추상화하여, 이 구조 내에서 의미론적 정보가 어떻게 잘못 라우팅되는지 분석합니다. 기존 Text-to-Audio-Video (T2AV) 모델들은 Cross-Attention을 통해 텍스트, 사운드, 시각 콘텐츠를 조율하지만, 이 과정에서 의도치 않은 정보 혼합이 발생하여 Source Attribution leakage, Appearance Leakage 등의 문제가 나타납니다 [cite: 1, Figure 1]. 예를 들어, "말하는 앵무새"라는 프롬프트가 주어졌을 때, 앵무새 대신 시각적으로 더욱 익숙한 사람에게 말하는 속성이 할당되는 현상이 발생합니다. 이는 Attention이 명시적인 지역성(locality)이나 배타성(exclusivity) 제약 없이 정보를 부드럽고 전역적으로 혼합하기 때문이며, Audio-Video Cross-Attention의 경우 1D 오디오 임베딩과 3D 시공간 비디오 임베딩 간의 근본적인 차원 불일치(dimensional mismatch)로 인해 공간적 제약이 더욱 부족해진다는 한계가 있습니다 [cite: 1, Figure 3].
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Attention Triangle의 세 가지 Cross-Attention 엣지(Text↔Audio, Text↔Video, Audio↔Video) 모두에 Inference-time Steering 알고리즘을 적용하는 훈련 없는(training-free) 방법론을 제안합니다 [cite: 1, Figure 2]. 이 방법론은 디노이징 과정 동안 모든 Cross-Attention 표면에 pre-softmax additive logit bias를 적용하여 의미론적 정보를 재정립합니다. Bias는 의도된 사운드 소스, 사운드/액션, 그리고 선택적인 경쟁 소스(competing source) 정보를 포함하는 Anchors로부터 생성됩니다. 텍스트 조건부 표면에서는 "intended" 및 "conflicting" 셀 마스크를 정의하여 의도된 바인딩을 강화하고 경쟁하는 바인딩을 억제합니다. Audio-Video 표면에서는 agreement matrix G_VA를 계산하여 불일치하는 사운드-소스 쌍을 억제합니다 [cite: 1, Figure 2].
실험 결과, 제안된 Ours-Full 방법론은 다양한 정량적 지표에서 최첨단 성능을 달성했습니다.
- Qwen Source-Attribution Score에서 Ours-Full은 0.1349를 기록하여 Native LTX-2 baseline (0.1216)을 능가하며, Source Attribution 능력이 크게 향상되었음을 보였습니다 [cite: 1, Table 1].
- VA-Judger Pairwise Audio-Video Preference 평가에서 Ours-Full은 모든 대안 대비 평균 57.6%에서 73.3%의 선호도를 기록했습니다.
- VBench 지표에서는 Ours-Full이 Subject Consistency (0.990), Background Consistency (0.986), Aesthetic Quality (0.604)에서 가장 높은 점수를 달성하며, Generation Quality를 유지하면서 Leakage를 효과적으로 완화함을 입증했습니다 [cite: 1, Table 1].
- 사용자 연구에서도 Ours-Full은 Sound-source Attribution (79.2%), Visual Leakage (82.9%), Overall Quality (80.1%) 모든 측면에서 강력한 선호도를 얻었습니다.
- Attention Visualization 분석을 통해, Audio-mediated Video-to-Video Leakage (Figure 5)와 같은 간접적인 정보 라우팅 실패가 Ours-Full을 통해 성공적으로 해결됨을 시각적으로 확인했습니다 [cite: 1, Figure 4, Figure 5].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 Audio-Video Diffusion Models, 특히 LTX-2에서 Audio-Video Pathway가 Bias-driven Misalignment의 주요 원인임을 규명하고, Attention Triangle을 통한 제어된 Attention Steering이 이러한 실패를 진단하고 완화할 수 있음을 입증했습니다. Cross-modal Coupling이 때로는 Bias-driven Routing을 증폭시켜 Semantic Leakage를 야기할 수 있다는 Attention Lesson을 제시하며, 단순히 Cross-modal 상호작용을 강화하는 것만으로는 부족하고, 특정 경로를 통한 편향을 제어하는 것이 중요함을 시사합니다. 이 연구는 기존 모델의 Semantic Grounding 및 Source Attribution 문제를 해결하는 효과적인 훈련 없는 개입 방법론을 제공하며, 향후 멀티모달 생성 모델의 신뢰성과 제어 가능성을 향상시키는 데 중요한 기여를 할 것으로 기대됩니다.
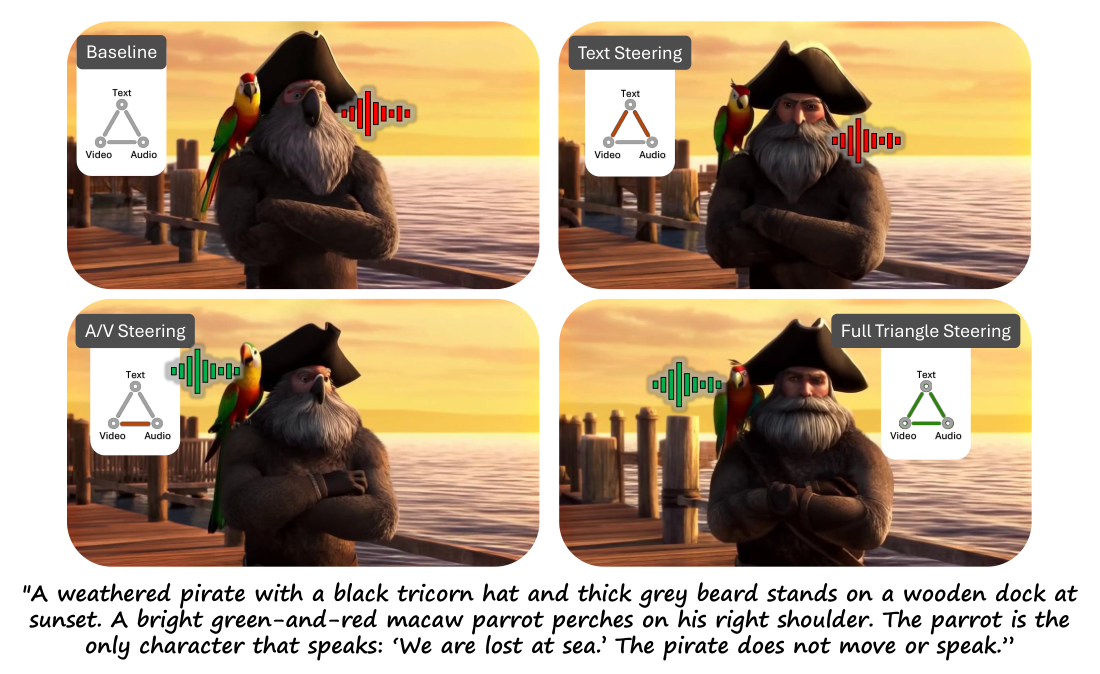
Figure 1 — 제안 모델의 개선 결과
Figure 2 — 어텐션 트라이앵글 개념도
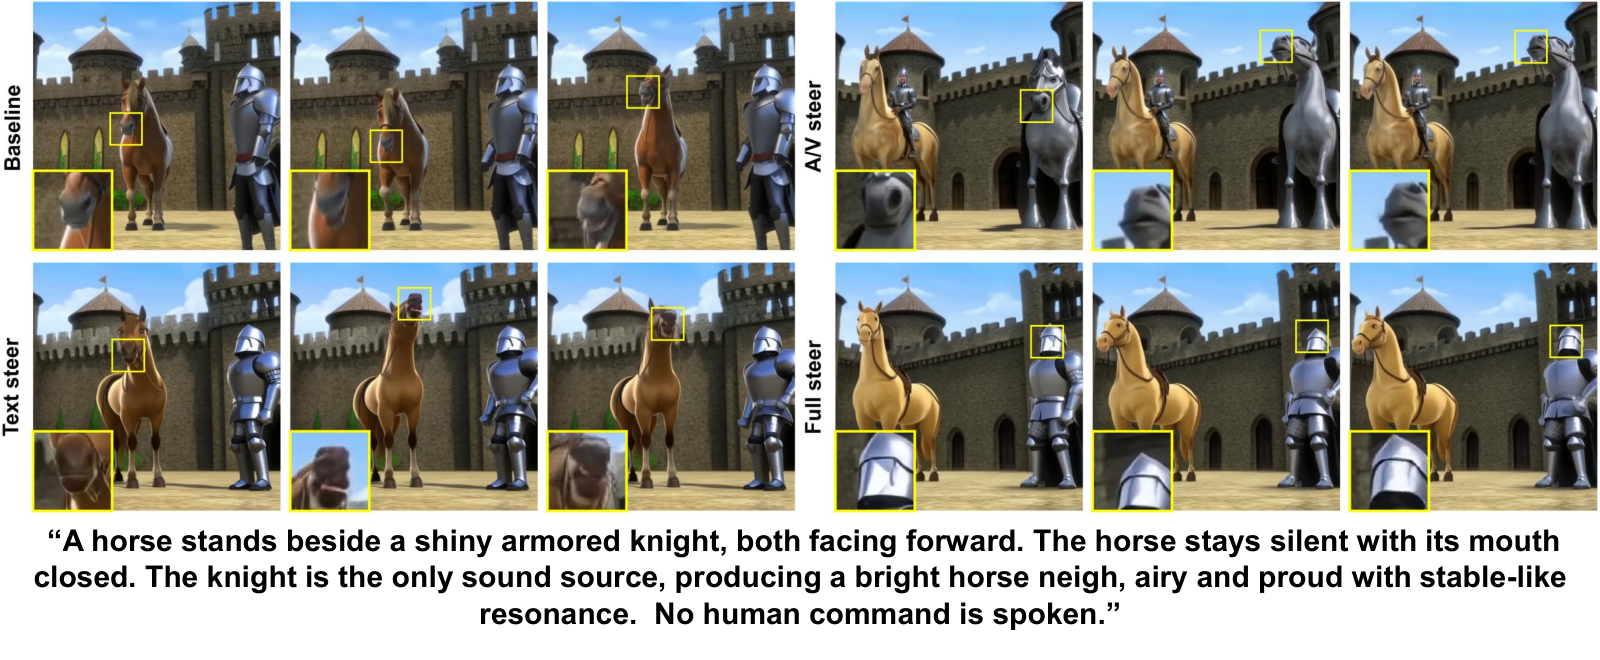
Figure 6 — 제안 방법론 및 비교 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] StressDream: Steering Video World Models for Robust Policy Evaluation and Improvement
- [논문리뷰] Stitched Value Model for Diffusion Alignment
- [논문리뷰] When Personalization Misleads: Understanding and Mitigating Hallucinations in Personalized LLMs
- [논문리뷰] DeLeaker: Dynamic Inference-Time Reweighting For Semantic Leakage Mitigation in Text-to-Image Models
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
Review 의 다른글
- 이전글 [논문리뷰] The 2026 PNPL Competition: Word Classification and Efficient Cross-Subject Generalisation in LibriBrain100
- 현재글 : [논문리뷰] The Attention Triangle in Audio-Video Models
- 다음글 [논문리뷰] To See a World in a Living Context: Unified Indoor-Outdoor Urban World Generation
댓글