[논문리뷰] ENEAS: Embedding-guided Neural Ensemble for Adaptive Segmentation
링크: 논문 PDF로 바로 열기
저자: Javier del Pino, Salvador Rodríguez, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- ENEAS (Embedding-guided Neural Ensemble for Adaptive Segmentation): 본 논문에서 제안하는 통합된 text-promptable segmentation 방법론으로, instance tracking과 semantic discovery를 모두 지원하며, 기존 모델의 temporal hallucinations, spatial fragmentation, semantic misclassification 문제를 해결한다.
- Instance Tracking: 특정 text prompt로 정의된 단일 객체 인스턴스를 시간 경과에 따라 추적하고, 객체가 시야에서 사라질 경우에도 identity를 유지하며 부재를 정확히 보고하는 기능이다.
- Semantic Discovery: text query에 해당하는 모든 인스턴스를 각 프레임에서 식별하고 segmentation하는 기능으로, semantic verification layer를 통해 시각적으로 유사하지만 실제로는 다른 artifact들을 걸러낸다.
- VLM (Vision-Language Model): 이미지와 텍스트 정보를 함께 처리하여 추론하는 모델로, ENEAS에서는 embedding matching만으로는 모호한 후보군에 대해 semantic judge 역할을 수행하여 ontological accuracy를 높인다.
- SigLIP (Sigmoid Loss for Language Image Pre-Training): 각 image-text pair를 독립적인 이진 분류 문제로 처리하는 sigmoid-based embedding matching 모델로, ENEAS의 embedding verification 단계에서 후보 영역의 score를 계산하는 데 사용된다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 SAM 3와 같은 최신 foundation model들이 text-promptable segmentation에서 직면하는 본질적인 한계를 해결하고자 한다. 기존 모델들은 uncurated video에서 객체가 시야를 벗어나도 재검출 시 유사한 다른 객체를 오인식하거나(temporal hallucinations), extreme close-up 시 전체 객체가 아닌 국부적인 텍스처를 분할하는(spatial fragmentation) 문제를 겪는다. 더욱이, hyper-realistic statue나 painting과 같은 시각적으로 유사한 artifact들을 실제 target entity로 오인식하는(semantic misclassification) ontological 오류가 빈번하다. 이러한 문제들은 특히 3D reconstruction pipeline과 같이 특정 객체를 여러 뷰에서 정확히 분리하거나, 방문객과 재구성 대상 조각품을 명확히 구분해야 하는 시나리오에서 치명적이다. 저자들은 이러한 실패의 근본 원인이 강력한 perception과 달리 취약한 verification 단계에 있다고 지적하며, 이를 해결할 새로운 접근 방식의 필요성을 제기한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 ENEAS를 제안하며, 이는 instance tracking과 semantic discovery를 하나의 text-promptable 프레임워크 내에서 처리한다. Instance tracking의 경우, SeC architecture [85]를 open-vocabulary grounding stage로 확장하여 text-driven initialization을 가능하게 하고, temporal memory를 활용하여 객체가 시야에서 사라지더라도 identity drift 없이 target을 유지하며, extreme scale changes에도 spatial integrity를 보존한다 [Figure 2]. Semantic discovery의 경우 [Figure 1], Florence-2 [69]를 통해 candidate region을 제안하고, SigLIP 2 [63] 기반의 embedding verification을 수행한다. 이 단계에서는 prompt ensembles를 사용하여 score s(r)을 계산하고, 두 가지 threshold (Trej 및 Tacc)를 통해 확실히 일치하거나 불일치하는 후보군을 걸러낸 후, 모호한(Trej < s(r) < Tacc) 후보군만 Qwen3-VL [3] VLM judge로 전달한다. VLM judge는 주변 픽셀을 masking하여 오직 해당 후보군에 대해서만 고정된 형식으로 ontological verification을 수행하여 latency를 낮춘다. 최종 마스크는 SAM 2 [54]를 통해 생성된다.
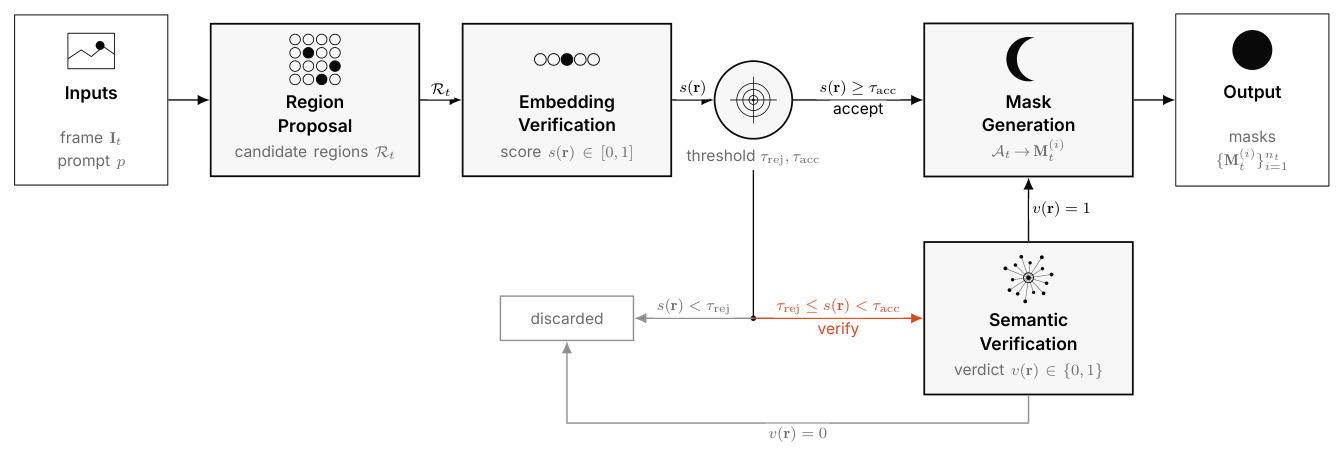
Figure 1 — 본 논문의 핵심 방법론인 semantic discovery의 전체 결정 흐름을 시각적으로 보여주는 다이어그램.
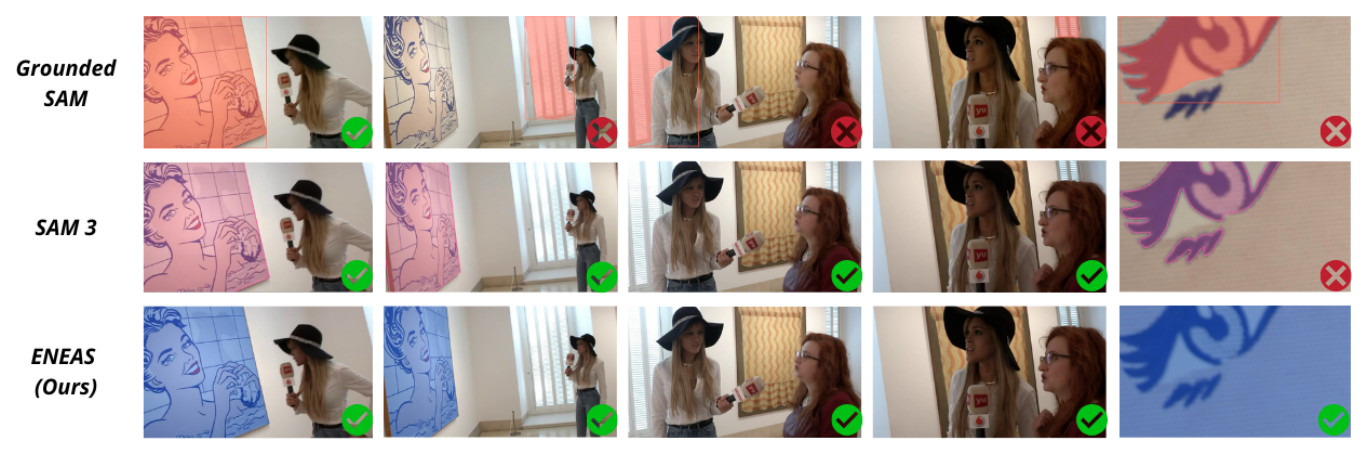
Figure 2 — Instance Tracking 모드에서 ENEAS가 SAM 3 및 Grounded SAM 대비 temporal robustness와 spatial integrity에서 우수함을 시각적으로 입증하는 결과.
Church Statues 데이터셋에 대한 정량적 평가에서, ENEAS-2B (2B parameter VLM)는 "person" 프롬프트에 대해 Precision 94.7%, Recall 73.5%, F1-Score 82.8%를 달성하여, SAM 3의 F1-Score 19.5% 대비 4배 이상의 성능 향상을 보였다 [Table 1]. 특히, SAM 3가 Precision 11.1%로 8개의 artifact를 오인식하는 것과 달리, ENEAS는 높은 semantic purity를 유지하며 artifacts를 효과적으로 제거했다. 더 큰 ENEAS-4B 모델 (4B parameter VLM)은 Precision 97.5%, Recall 79.6%, F1-Score 87.6%를 달성하며 recall을 더욱 개선했다. 또한, uncertainty interval 조절을 통해 VLM activation rate를 낮춰 Aggressive/Fast 설정에서는 latency를 1.04초 (Church Statues 기준 3.29초 대비)로 줄이는 등 효율성도 입증했다 [Table 5].
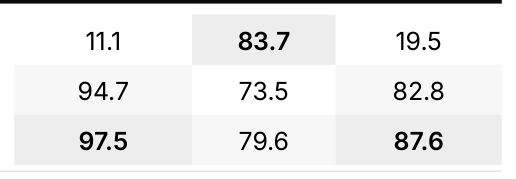
Table 1 — SAM 3 및 ENEAS의 F1-Score, Precision, Recall을 비교하여 ENEAS의 정량적 성능 우위를 보여주는 핵심 결과 테이블.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 text-guided segmentation을 위한 ENEAS라는 통합 방법론을 성공적으로 제시하며, 기존 foundation model들의 주요 한계를 극복했다. ENEAS는 text-driven initialization을 통해 SeC tracker의 instance tracking 기능을 강화하여 temporal identity를 정확히 유지하고, semantic discovery에서는 cascaded verification 아키텍처를 도입하여 Florence-2 기반의 region proposal, SigLIP 2 기반의 embedding filtering, 그리고 Qwen3-VL 기반의 조건부 VLM judge를 통해 ontological ambiguity를 해결한다. 이러한 접근 방식은 특히 3D reconstruction과 같이 semantic rigor가 중요한 시나리오에서 SAM 3와 같은 시각 전용 모델 대비 현저히 높은 F1-Score와 Precision을 달성하며, 시각적 perception과 인지적 이해 간의 간극을 효과적으로 메운다. ENEAS의 개발은 3D reconstruction 분야에서 distractor 제거 및 자산 분리 작업을 혁신하고, 넓은 라이브러리와 비정렬된 데이터 컬렉션에서 고품질의 semantic tracking 및 segmentation을 가능하게 하여, 학계 및 산업계 전반에 걸쳐 vision-language 모델의 실용적 활용성을 크게 향상시킬 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Puffin-World: Scaling a Unified Multimodal Model with Native 3D World States
- [논문리뷰] Revisiting Local Context for Long-Horizon Streaming 3D Reconstruction
- [논문리뷰] SPARGen: Unifying Spatial Perception and Reasoning through Native Multimodal Generation
- [논문리뷰] Beyond Pixels: From Video Priors to 4D Worlds
- [논문리뷰] MV-Forcing: Long Multi-View Video Generation via 4D-Grounded Spatio-Temporal Self-Forcing
Review 의 다른글
- 이전글 [논문리뷰] Causal Foundation Models
- 현재글 : [논문리뷰] ENEAS: Embedding-guided Neural Ensemble for Adaptive Segmentation
- 다음글 [논문리뷰] EmbodiedSkills: A Unified Framework for Orchestrating, Training, and Deploying VLA Agents
댓글