[논문리뷰] EmbodiedSkills: A Unified Framework for Orchestrating, Training, and Deploying VLA Agents
링크: 논문 PDF로 바로 열기
저자: Wei Wang, Wenqiao Zhang, Yutong Lin, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 다루는 핵심 용어 및 개념은 VLA 모델의 long-horizon task 수행 능력을 향상시키는 데 기여한다.
- VLA Models (Vision-Language-Action Models): 시각적 관찰(visual observations)과 자연어 명령(language instructions)을 로봇 동작(robot actions)으로 직접 매핑하는 모델을 의미한다.
- Embodied Skills: 로봇이 수행할 수 있는 구조화된 동작 단위로, typed inputs and outputs, explicit prerequisites, executable operation, post-execution state update, failure handling 등의 속성을 가진다.
- AgentLoop: EmbodiedSkills 프레임워크의 중심에 있는 closed-loop 시스템으로, observation, planning, preflight checks, bounded execution, progress verification, recovery를 조율한다.
- Executable Skill Contract: 각 Embodied Skill의 formal definition을 제공하며, 스킬의 입력/출력 스키마, 전제 조건, 실행 방식, 사후 상태 업데이트, 실패 시 처리 로직을 명시하는 인터페이스이다.
- Guarded Runtime Transition: 정책(policy)이 제안한 스킬 결정(skill decision)의 유효성을 실행 전에 확인하는 메커니즘으로, phase compatibility, required inputs, artifact freshness, action validity, legal state transitions 등을 검증한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 Vision-Language-Action (VLA) 모델이 long-horizon tasks를 수행할 때 발생하는 복잡한 조율 문제와 기존 방법론의 한계를 해결하고자 한다. 기존 VLA policies는 visual observations과 language instructions을 robot actions로 직접 매핑하지만, 단순히 다음 동작을 예측하는 것을 넘어 perception, planning, execution, progress verification, recovery와 같은 다양한 Agentic layer 기능들을 조율해야 한다. End-to-end VLA policies는 visuomotor control에 대한 통합 학습 인터페이스를 제공하지만, 중간 태스크 결정(intermediate task decisions)이 암묵적(implicit)으로 처리되어 태스크 실패 시 객체 grounding, subgoal selection, low-level action execution, progress verification, recovery 등 구체적인 실패 원인을 진단하기 어렵다는 한계가 있다. 반면, LLM-based robotic agents는 명시적인 tool calls와 reasoning steps을 생성할 수 있지만, 제안된 결정(explicit decision)이 현재 물리적 상태(physical state)에서 항상 유효하거나 실행 가능하다고 보장할 수 없으며, stale observations, 누락된 인자, 의도된 결과 미달성 등의 문제가 발생할 수 있다. 이러한 문제들은 특히 partial observability, 지연된 피드백, contact-rich failures 환경에서 더욱 심각해진다. 따라서 EmbodiedSkills는 모델의 의사 결정과 물리적 실행 사이의 간극을 메우고, 제안된 동작이 실행 전에 검사되고 그 결과가 사후에 검증되어 다음 의사 결정과 학습에 활용되도록 하는 통합 프레임워크를 제시한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
EmbodiedSkills는 low-level VLA policy를 closed-loop embodied agent로 전환하기 위해 observation, planning, validation, execution, verification, recovery를 executable embodied skills 중심으로 조율하는 통합 프레임워크를 제안한다 [cite: 1, Figure 1]. 핵심 방법론은 Policy–runtime separation으로, high-level policy는 structured skill decisions을 제안하고, 별도의 runtime이 prerequisites, artifact freshness, action validity, legal state transitions을 강제하는 구조이다. 이 프레임워크는 AgentLoop를 기반으로 하며, Observe, Plan, Preflight, Execute, Verify, Recover의 6가지 phase로 구성된다 [cite: Table 1]. 각 skill은 Executable Skill Contract를 통해 typed inputs and outputs, prerequisites, executable operation, post-execution state update, failure handling을 명시하여, 정책 제안이 물리적 상태 변화로 오인되는 것을 방지한다. Guarded Runtime Transition 메커니즘은 정책의 결정이 실행되기 전에 유효성을 검증하며, 특히 Execute phase에서는 low-level VLA policy가 active subgoal을 bounded action chunk로 변환하고, runtime은 이 chunk의 유효성을 검사한다 [cite: 1, Figure 2]. 이러한 모듈화된 인터페이스는 계획, 검증, 동작 생성 및 환경 상호작용 구성 요소를 독립적으로 훈련하고 교체할 수 있게 한다.
주요 실험 결과는 EmbodiedSkills의 효과적인 Agentic layer 조율 능력과 강력한 실행 성능을 보여준다.
- RoboTwin 2.0 벤치마크: EmbodiedSkills는 task-adapted low-level VLA policies를 사용하여 50개 RoboTwin 2.0 task에서 평균 86.20%의 성공률을 달성했으며, 이는 LingBot-VA의 π0.5 reference 82.74% 대비 3.46%p 개선된 결과이다 [cite: Table 2]. 특히 Hanging Mug에서 +20%p, Blocks Ranking Size에서 +15%p, Open Microwave에서 +15%p의 큰 성능 향상을 보였다 [cite: Table 2, Figure 3a].
- LIBERO 벤치마크: LIBERO-Spatial, LIBERO-Object, LIBERO-Goal, LIBERO-Long의 4가지 스위트에서 평균 성공률 97.40%를 기록하여, 공식 OpenPI reference인 96.85%보다 0.55%p 높은 성능을 보여주었다 [cite: Table 3, Figure 3b]. 특히 LIBERO-Long에서 1.2%p의 가장 큰 개선을 보이며, 긴 task sequence에 대한 강점을 입증했다 [cite: Table 3].
- RMBench Memory-Dependent Tasks: 4가지 memory-dependent RMBench task에서 평균 12.5%의 성공률을 달성하여, 이전 상위 모델들(OpenPI: 5.5%, X-VLA: 7.3%) 대비 상당한 향상을 보였다 [cite: Table 4].
- AgentLoop Ablations: AgentLoop의 핵심 메커니즘인 semantic subtask conditioning, intermediate verification, adaptive continuation의 중요성을 입증하였다 [cite: Table 5, Figure 3c]. Verification이 없는 경우 38.0%p, subtask conditioning이 없는 경우 51.8%p의 성능 하락을 보여, Full 구성의 중요성을 강조한다 [cite: Table 5, Figure 3c].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 VLA action models을 closed-loop embodied agents로 전환하기 위한 skill-oriented framework인 EmbodiedSkills를 제안한다. 이 프레임워크의 핵심은 정책(policy)이 structured skill decisions을 제안하는 것과, prerequisites, artifact freshness, action validity, legal state transitions을 강제하는 runtime을 분리하는 설계이다. 그 결과, AgentLoop는 관찰(observe), 계획(plan), 준비 상태 확인(check readiness), bounded action chunks 실행(execute bounded action chunks), 진행 상황 검증(verify progress), 그리고 실패로부터의 복구(recover from failures) 과정을 반복적으로 수행하며, planner, verifier, low-level VLA policy, environment adapter를 독립적으로 교체 및 적응 가능하게 한다.
EmbodiedSkills는 로봇 제어 분야에 중대한 시사점을 제공한다. 첫째, deployment-consistent traces를 통해 semantic planning, phase-aware skill selection, post-action verification을 지도 학습(supervised adaptation)할 수 있는 직접적인 훈련 경로를 제공한다. 둘째, low-level VLA policy를 안정적인 실행 인터페이스 뒤에서 subtask demonstrations으로 적응시킬 수 있으므로, high-level 구성 요소는 low-level VLA policy를 고정한 채로 개선될 수 있다. 마지막으로, EmbodiedSkills는 Agent behavior 진단 및 개별 구성 요소 훈련을 위한 명시적인 trajectory 및 state interface를 제공하여, 복잡한 long-horizon manipulation tasks에서 VLA agents의 신뢰성과 진단 가능성을 크게 향상시킨다.
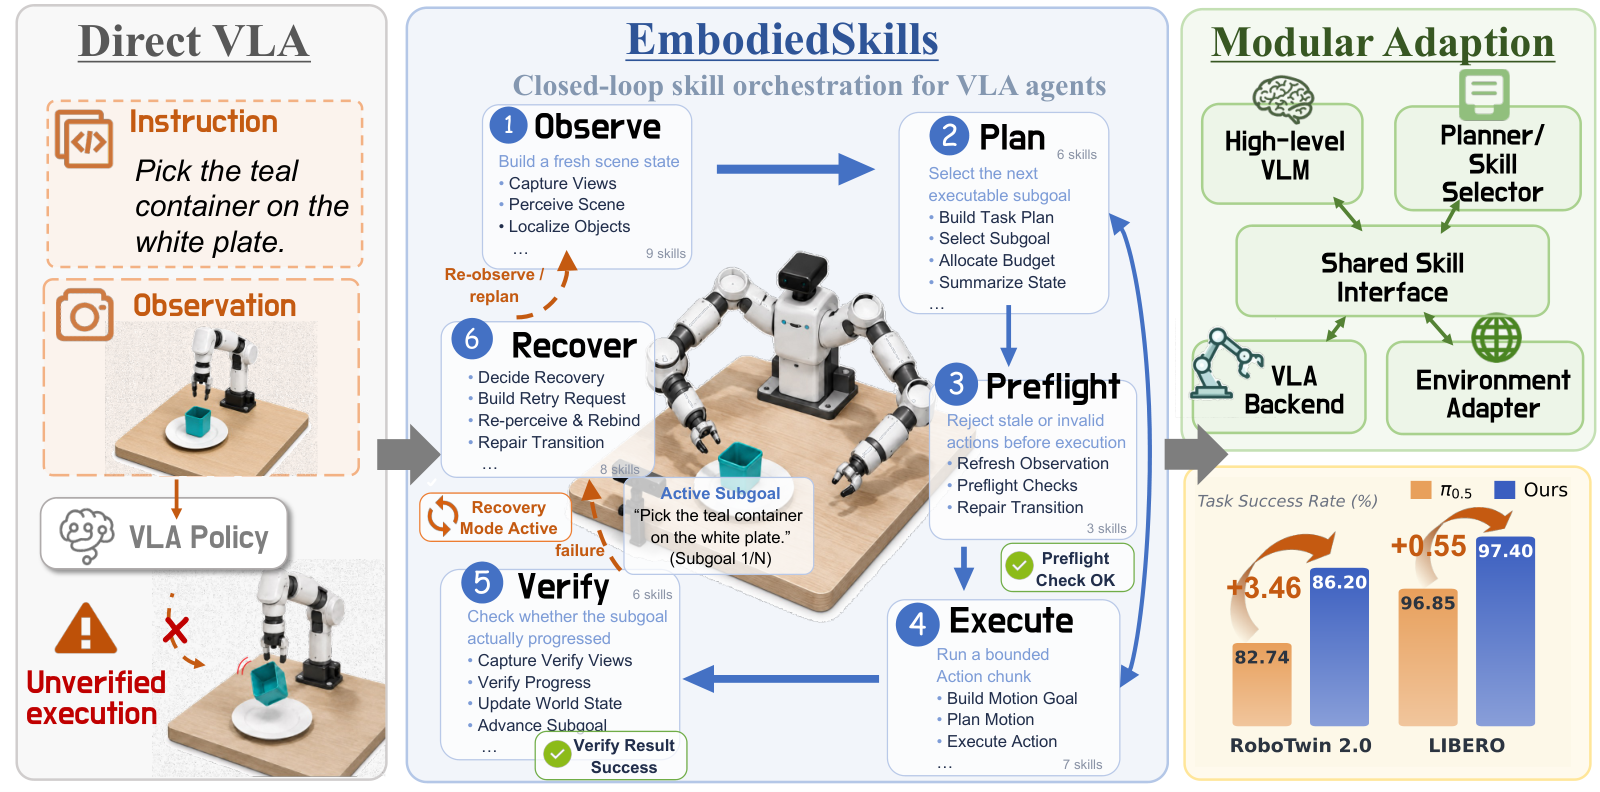
Figure 1 — EmbodiedSkills 개요
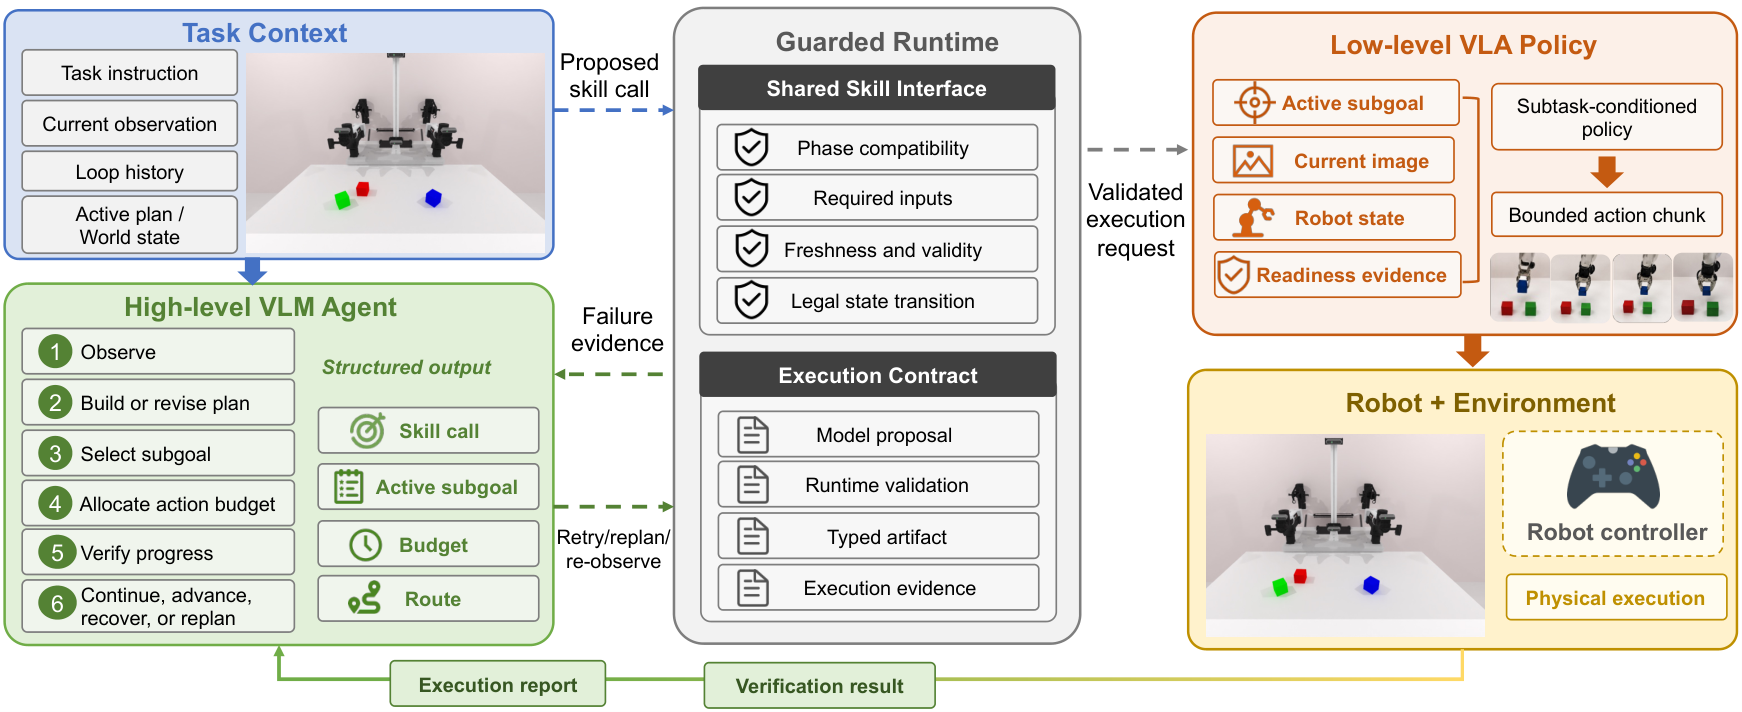
Figure 2 — 제안 모델 아키텍처
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Discrete Diffusion VLA: Bringing Discrete Diffusion to Action Decoding in Vision-Language-Action Policies
- [논문리뷰] RISE: Self-Improving Robot Policy with Compositional World Model
- [논문리뷰] SpatialBlock: Enhancing Spatial Intelligence in LVLMs via Synthetic Block-Stacking Problem
- [논문리뷰] An Open Recipe for IMO Gold: Training Nemotron for Olympiad Mathematics
- [논문리뷰] Difficulty-Adaptive Tree-Structured Policy Optimization for Expanding Reasoning Coverage in RLVR
Review 의 다른글
- 이전글 [논문리뷰] ENEAS: Embedding-guided Neural Ensemble for Adaptive Segmentation
- 현재글 : [논문리뷰] EmbodiedSkills: A Unified Framework for Orchestrating, Training, and Deploying VLA Agents
- 다음글 [논문리뷰] FlowBalance: Verifier-Grounded Self-Improvement from On-Policy Reasoning Experience
댓글