[논문리뷰] An Open Recipe for IMO Gold: Training Nemotron for Olympiad Mathematics
링크: 논문 PDF로 바로 열기
저자: Ivan Moshkov, Stephen Ge, George Armstrong, Wei Du, Sadegh Mahdavi, Igor Gitman
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Nemotron-3-Ultra-GA: NVIDIA에서 공개한 general-availability 상태의 베이스 모델.
- SFT (Supervised Fine-Tuning): 합성 데이터(synthetic data) 파이프라인을 통해 구축된 코퍼스로 모델의 proof 생성 및 검증 능력을 학습시키는 단계.
- RL (Reinforcement Learning): 비동기적(asynchronous) 프레임워크와 PipeLineRL 유사 알고리즘을 사용하여 proof 생성 성능을 최적화하는 단계.
- Nemotron-IMO-Bench: 200개의 새로운 올림피아드 수준 문제로 구성된 벤치마크 데이터셋.
- Test-time-compute pipeline: 형식 증명(formal prover)이나 외부 도구 없이 자연어 모델만을 활용하여 반복적인 생성, 검증, 정제(refine)를 수행하는 시스템.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 모델의 post-training 및 test-time inference 설계가 고난도 올림피아드 수학 증명 생성에 미치는 영향을 체계적으로 분석하고 최적의 파이프라인을 제시하는 것을 목표로 합니다. 기존의 AI 수학 문제 해결 시스템들은 상당 부분 형식 검증(formal verification)이나 외부 도구에 의존해 왔으나, 저자들은 오직 자연어 모델만을 활용하는 end-to-end 방식의 효율성을 입증하고자 합니다. 특히 모델의 checkpoint 선택, 검증(verification) 과정, 다중 모델 결합(ensemble)이 시스템의 성능에 미치는 정량적 효과를 파악함으로써, 복잡한 증명 문제에서 gold-medal 수준의 성과를 달성하기 위한 reproducible한 recipe를 제공하고자 합니다.
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 시스템은 Nemotron-3-Ultra-GA를 기반으로 SFT 및 RL을 거쳐 학습된 두 개의 특화(specialist) 모델을 포함한 3개의 모델을 결합하여, 제안(generate)-검증(verify)-정제(refine)의 반복적 탐색 과정을 수행합니다. 시스템은 8라운드의 고컴퓨트 탐색을 통해 최적의 후보를 도출하며, final selection 단계에서 reference-free IMO-style judge를 적용하여 가장 높은 점수의 솔루션을 선택합니다. 정량적 실험 결과, 제안된 앙상블 시스템은 IMO 2026에서 42점 만점 중 30점을 획득하여 gold-medal 임계치를 달성했습니다. 특히 [Table 1]에서 확인할 수 있듯이, 총 2.31B 개의 토큰 생성과 4,800 GB200 GPU-hours의 계산 자원을 사용하여 안정적으로 난도가 높은 문제들을 해결했습니다. [Table 3]을 통해 확인할 수 있는 verifier의 False Accept 비율(1.1%~3.4%)은 제안된 앙상블 기법이 이전의 단일 모델 대비 훨씬 높은 정확성과 선택적 검증 능력을 갖추고 있음을 시사합니다.
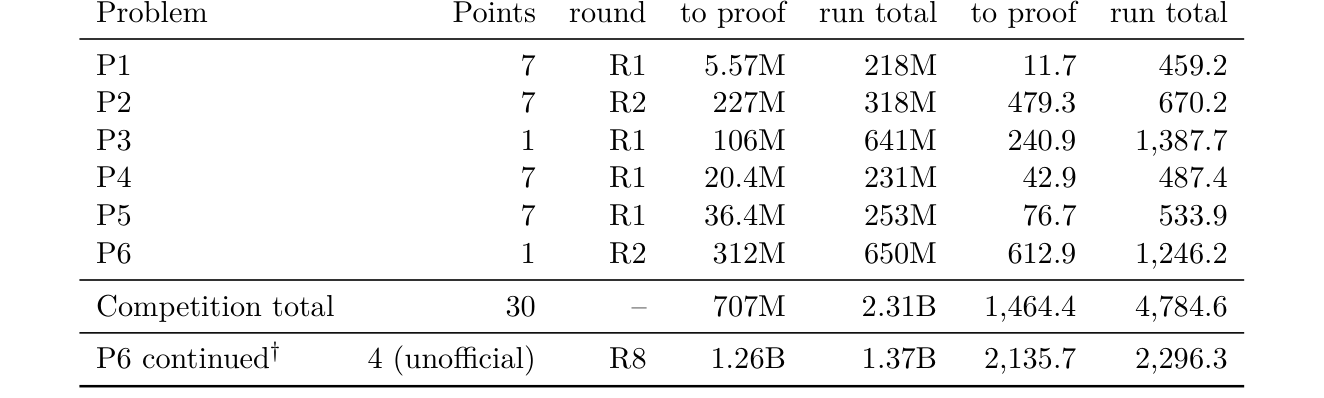
Table 1 — 대회 공식 결과 및 컴퓨팅 자원 소비에 대한 핵심 데이터 테이블
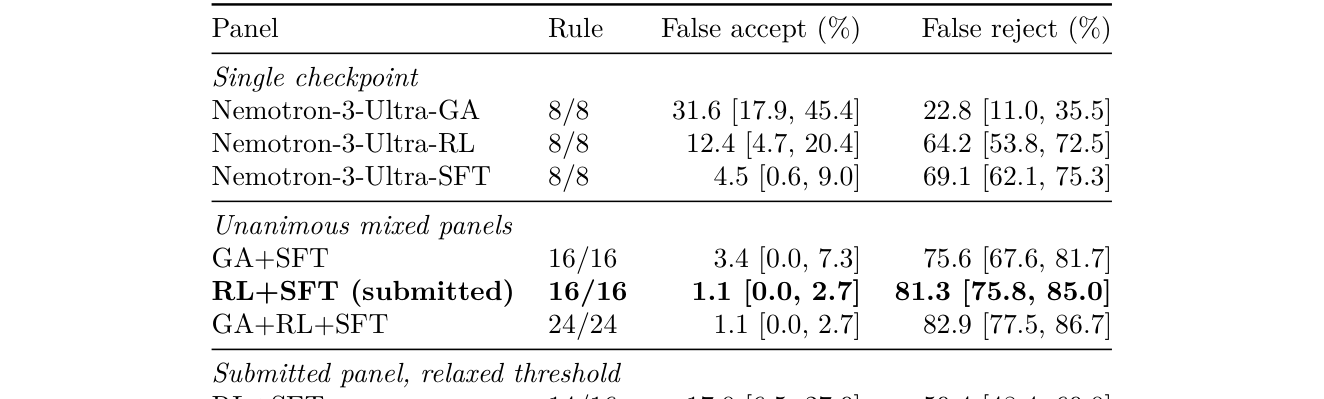
Table 3 — 모델 앙상블 및 검증기 구성에 따른 성능 비교 테이블
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 단순한 모델 스케일링을 넘어, 상호 보완적인 특화 checkpoint와 검증 중심의 반복 정제 루프가 고난도 수학적 추론에 필수적임을 성공적으로 증명했습니다. 저자들은 학습 데이터, 코드, 벤치마크 등을 포함한 전 과정을 오픈 소스로 공개함으로써 학계와 산업계가 LLM 기반의 에이전틱 수학 추론 연구를 재현하고 확장할 수 있는 중요한 기준점을 제시했습니다. 이러한 접근 방식은 향후 범용 인공지능이 복잡한 논리적, 추론적 과제를 해결하는 데 있어 중요한 로드맵 역할을 할 것으로 기대됩니다.
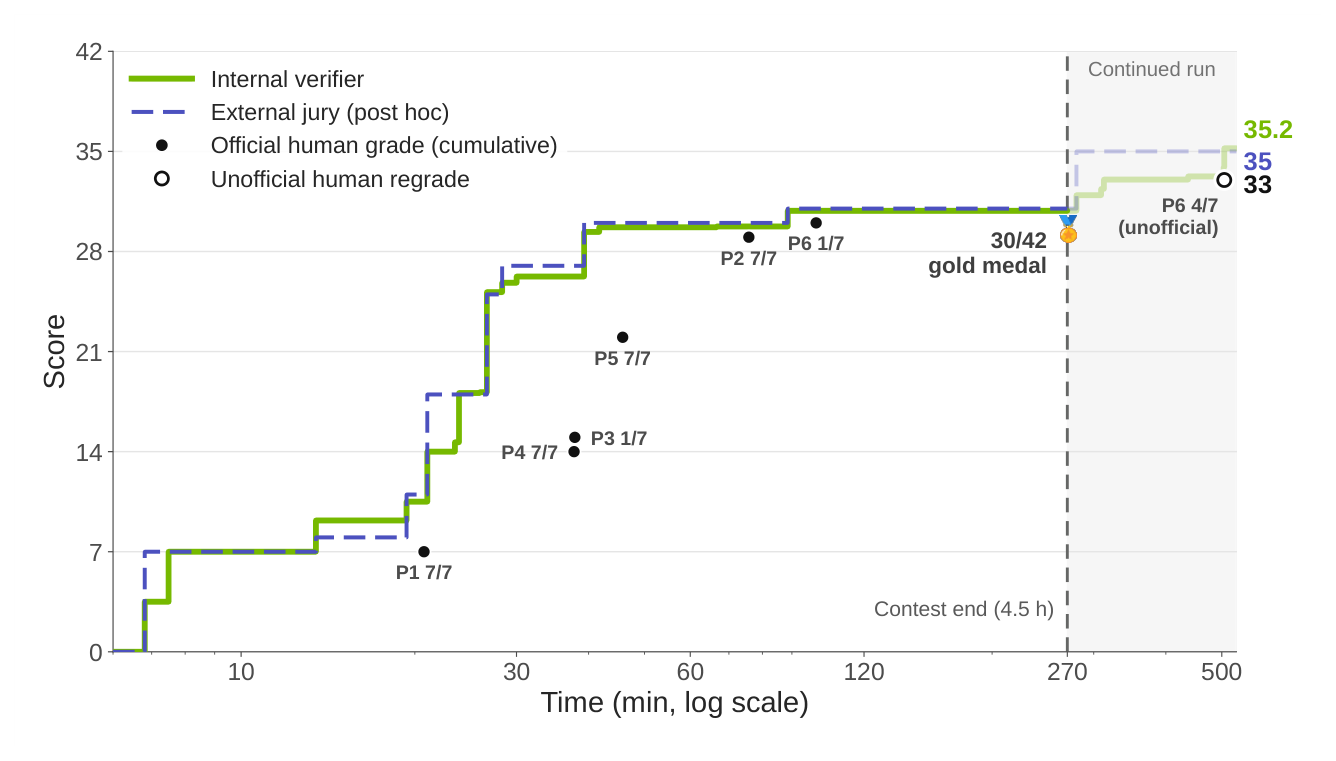
Figure 2 — 시간 경과에 따른 시스템의 점수 상승 곡선과 성능을 보여주는 핵심 그래프
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Achieving Olympia-Level Geometry Large Language Model Agent via Complexity Boosting Reinforcement Learning
- [논문리뷰] SpatialBlock: Enhancing Spatial Intelligence in LVLMs via Synthetic Block-Stacking Problem
- [논문리뷰] Difficulty-Adaptive Tree-Structured Policy Optimization for Expanding Reasoning Coverage in RLVR
- [논문리뷰] AgenticGen: Reward-Guided Agentic Video Generation for Advertising
- [논문리뷰] DriveZero: End-to-End Driving Beyond Human Demonstrations
Review 의 다른글
- 이전글 [논문리뷰] ActReview: Rebuttal-Guided Training Data and Rubric Rewards for Actionable Peer Review Generation
- 현재글 : [논문리뷰] An Open Recipe for IMO Gold: Training Nemotron for Olympiad Mathematics
- 다음글 [논문리뷰] Beyond Solver Verdicts: Generative Reward Models for Autoformalization
댓글