[논문리뷰] Beyond Solver Verdicts: Generative Reward Models for Autoformalization
링크: 논문 PDF로 바로 열기
저자: Vikash Singh, Debargha Ganguly, Aman Goel, Ali Torkamani, Xiaoxue Han, Joseph Lilien, Ferhat Erata, Vipin Chaudhary
1. Key Terms & Definitions (핵심 용어 및 정의)
- VPU (Verdict-Preserving-Unfaithfulness): 생성된 formal encoding이 구문적으로 유효하며 solver의 verdict는 참조 모델과 동일하지만, 실제로는 논리적으로 동등하지 않은 오류 상태를 의미합니다.
- GenV (Generative Verification): Offline Z3-equivalence oracle을 통해 도출된 라벨을 바탕으로, 별도의 분류기 없이 Language Model의 기본 vocabulary space를 활용하여 reference-equivalence를 판단하는 기법입니다.
- SMT-LIBv2: 논문에서 formal encoding의 표준으로 사용하는 언어 규격이며, Z3 solver를 통해 검증을 수행합니다.
- Decision-projected Gradient Lens: 모델의 중간 hidden activation이 최종 결정 마진(margin)에 미치는 영향을 추적하여 오류 위치를 진단하는 분석 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 신경기호주의(Neurosymbolic) 시스템에서 solver가 코드의 실행 가능성만을 보장할 뿐, 자연어 문제와 공식 언어 간의 정확한 의미적 대응을 보장하지 못한다는 근본적인 취약점을 다룹니다. 기존의 구조적 검증 방식은 encoding이 solver의 verdict를 통과하기만 하면 무결한 것으로 간주하는데, 저자들은 이러한 접근이 VPU 현상을 효과적으로 감지하지 못함을 증명합니다 [Figure 1]. 특히, 이론적으로 Verdict-only heuristic은 이런 deceptive한 trace를 탐지하는 데 무작위 수준의 성능(AUROC 0.5)밖에 낼 수 없다는 한계를 가집니다. 따라서 저자들은 사후(offline) 검증을 넘어, 추론 시점(inference-time)에서 참조 없이도 논리적 동등성을 판별할 수 있는 새로운 검증 체계의 필요성을 제기합니다.
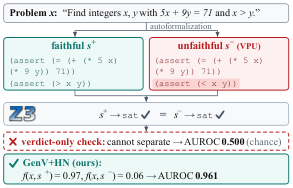
Figure 1 — VPU 발생 원리 및 사례
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들이 제안하는 GenV는 Language Model의 다음 토큰 예측 확률을 재정규화(renormalization)하여 논리적 동등성 점수를 도출하는 아키텍처 agnostic한 검증 방법론입니다 [Figure 2]. 모델 학습 과정에서는 Z3 solver의 정밀한 equivalence oracle 라벨을 사용하여 supervised fine-tuning을 수행하며, 특히 Hard Negative Mining을 통해 VPU 상황을 정교하게 학습시킵니다. 주요 실험 결과, GenV+HN은 결합된 벤치마크에서 0.961 AUROC를 달성하여 기존 reward model 기반 방식(Process RM 0.756, Outcome RM 0.762)을 압도적인 격차로 상회하였습니다. 또한, 다양한 도메인으로의 Zero-shot transfer 평가에서도 일관된 우위를 유지하며, 실제 에이전트 환경에서 테스트 시 연산 할당 효율화를 통해 약 11.3점의 Downstream 정확도 향상을 입증하였습니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 VPU라는 구체적인 논리 오류 모드를 정의하고, 이를 해결하기 위한 GenV 프레임워크를 성공적으로 제안하였습니다. 이 연구는 단순히 solver의 출력값에 의존하던 기존의 autoformalization 패러다임을 넘어, 모델 내부의 확률적 공간을 활용하여 더욱 엄밀한 논리적 무결성을 검증할 수 있는 가능성을 열었습니다. 향후 연구에서는 Formal logic 스타일의 변화나 인간의 주관적 의도(intent) 사이의 의미적 간극을 해소하는 것이 중요한 과제로 남을 것이며, 본 제안은 신뢰할 수 있는 신경기호주의 시스템 구축을 위한 필수적인 안전장치(Safeguard)로 활용될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] WorldReward: Reward Modeling for Camera-Conditioned World Models
- [논문리뷰] FIRM-Video: Check Before You Score for Reliable Text-to-Video Reward Modeling
- [논문리뷰] MathForm: Scaling Mathematical Autoformalization with Knowledge Retrieval and Verification-Guided Refinement
- [논문리뷰] Codifying the Judge: Scalable Evaluation via Program Distillation
- [논문리뷰] TheoremGraph: Bridging Formal and Informal Mathematics
Review 의 다른글
- 이전글 [논문리뷰] An Open Recipe for IMO Gold: Training Nemotron for Olympiad Mathematics
- 현재글 : [논문리뷰] Beyond Solver Verdicts: Generative Reward Models for Autoformalization
- 다음글 [논문리뷰] CARDEA: Auditable Reasoning Grounded in Spatial Evidence for End-to-End Coronary Angiography Interpretation
댓글