[논문리뷰] Omni Interaction Agent Technical Report
링크: 논문 PDF로 바로 열기
저자: Orantqing, Shengpeng Ji, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Omni Interaction Agent: 비디오, 음성, 텍스트를 포함한 여러 모달리티로부터 스트리밍 입력을 지속적으로 수신하여 자연스러운 Full-Duplex Interaction 및 Workflow-oriented Agent 시나리오를 가능하게 하는 End-to-End 모델입니다.
- Full-Duplex Interaction: 사용자가 언제든지 모델을 Interrupt할 수 있고, 모델이 Proactive하게 중간 피드백을 제공하거나 Follow-up 질문을 할 수 있도록 하는 Continuous, Low-latency, Bidirectional Interaction 방식입니다.
- Cerebellum-Brain Collaborative Framework: Realtime Interaction과 Omni Conversational Capabilities를 담당하는 Cerebellum과 Complex Reasoning 및 Higher-level Agentic Tasks를 처리하는 Brain으로 구성된 분리된 아키텍처 프레임워크입니다.
- Streaming Thinker-Talker Architecture: Cerebellum이 Multimodal Input과 Model Output을 Chunk Level에서 Unified Token Stream으로 평탄화하여 Low-latency, Continuous Interaction을 위한 단일 표현을 제공하는 아키텍처 디자인입니다.
- Agentic Capabilities: LLM이 텍스트 응답을 넘어 외부 환경을 Active하게 Perception하고, Reasoning하며, Act upon할 수 있게 하는 능력으로, Tool Use, Environmental Interaction, Multi-step Planning 및 Execution을 포함합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 Turn-based Human-AI Interaction 패러다임이 Human-Human Communication의 Fluid하고 Collaborative한 특성을 반영하지 못하는 핵심 문제를 해결하고자 합니다. 현재 LLM-based Agent들은 Text 기반의 Discrete한 상호작용 주기에 머물러 있어, Continuous Multimodal Perception, Low-latency Bidirectional Interaction, 그리고 Robust Agentic Capabilities가 통합된 자연스러운 Human-AI Collaboration을 실현하기 어렵습니다. 구체적으로, 기존 연구들은 VAD (Voice Activity Detection) 및 ASR (Automatic Speech Recognition)과 같은 구성 요소를 단순히 결합하는 방식으로는 진정한 Interactivity를 달성하기 어렵다는 한계를 가집니다. 또한, Realtime Conversational Interaction과 Complex Agentic Workflows가 요구하는 상이한 Computational 및 Reasoning 요구 사항을 단일 Monolithic Model로 동시에 만족시키려는 시도는 Responsiveness와 Intelligence 사이의 Trade-off를 야기합니다. 이러한 문제점들을 해결하기 위해, Gander는 Realtime Multimodal Interaction과 Agentic Intelligence를 통합하는 새로운 접근 방식을 제안합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Realtime Multimodal Interaction과 Agentic Intelligence를 통합하기 위해 Gander라는 Omni Interaction Agent를 제안합니다. Gander는 Cerebellum-Brain Collaborative Framework와 Streaming Thinker-Talker Architecture라는 두 가지 핵심 아키텍처 디자인을 채택합니다 [Figure 2, 4]. Cerebellum은 Realtime Multimodal Interaction, Continuous Perception, 그리고 Responsive Conversational Control을 담당하며, Brain은 Complex Planning 및 Agentic Task Execution을 수행하는 Higher Capacity Reasoning Module로 구성됩니다. 이 두 구성 요소는 Tool Calling 및 Agent Orchestration Runtime을 통해 지속적으로 상호작용합니다. Brain은 Training-free 및 Plug-and-play 구성 요소로 설계되어, 핵심 Interaction Model을 재훈련할 필요 없이 더 강력한 Reasoning Model을 통합할 수 있습니다. Cerebellum의 Streaming Thinker-Talker Architecture는 Visual Perception 및 Acoustic Perception을 통해 스트리밍 입력을 처리하고, Streaming Chunk Flattening 메커니즘을 통해 모든 모달리티를 단일 Causal Token Stream으로 직렬화하여 모델이 각 Chunk에서 listen, speak, 또는 interrupt할지 동적으로 결정할 수 있도록 합니다 [Figure 4].
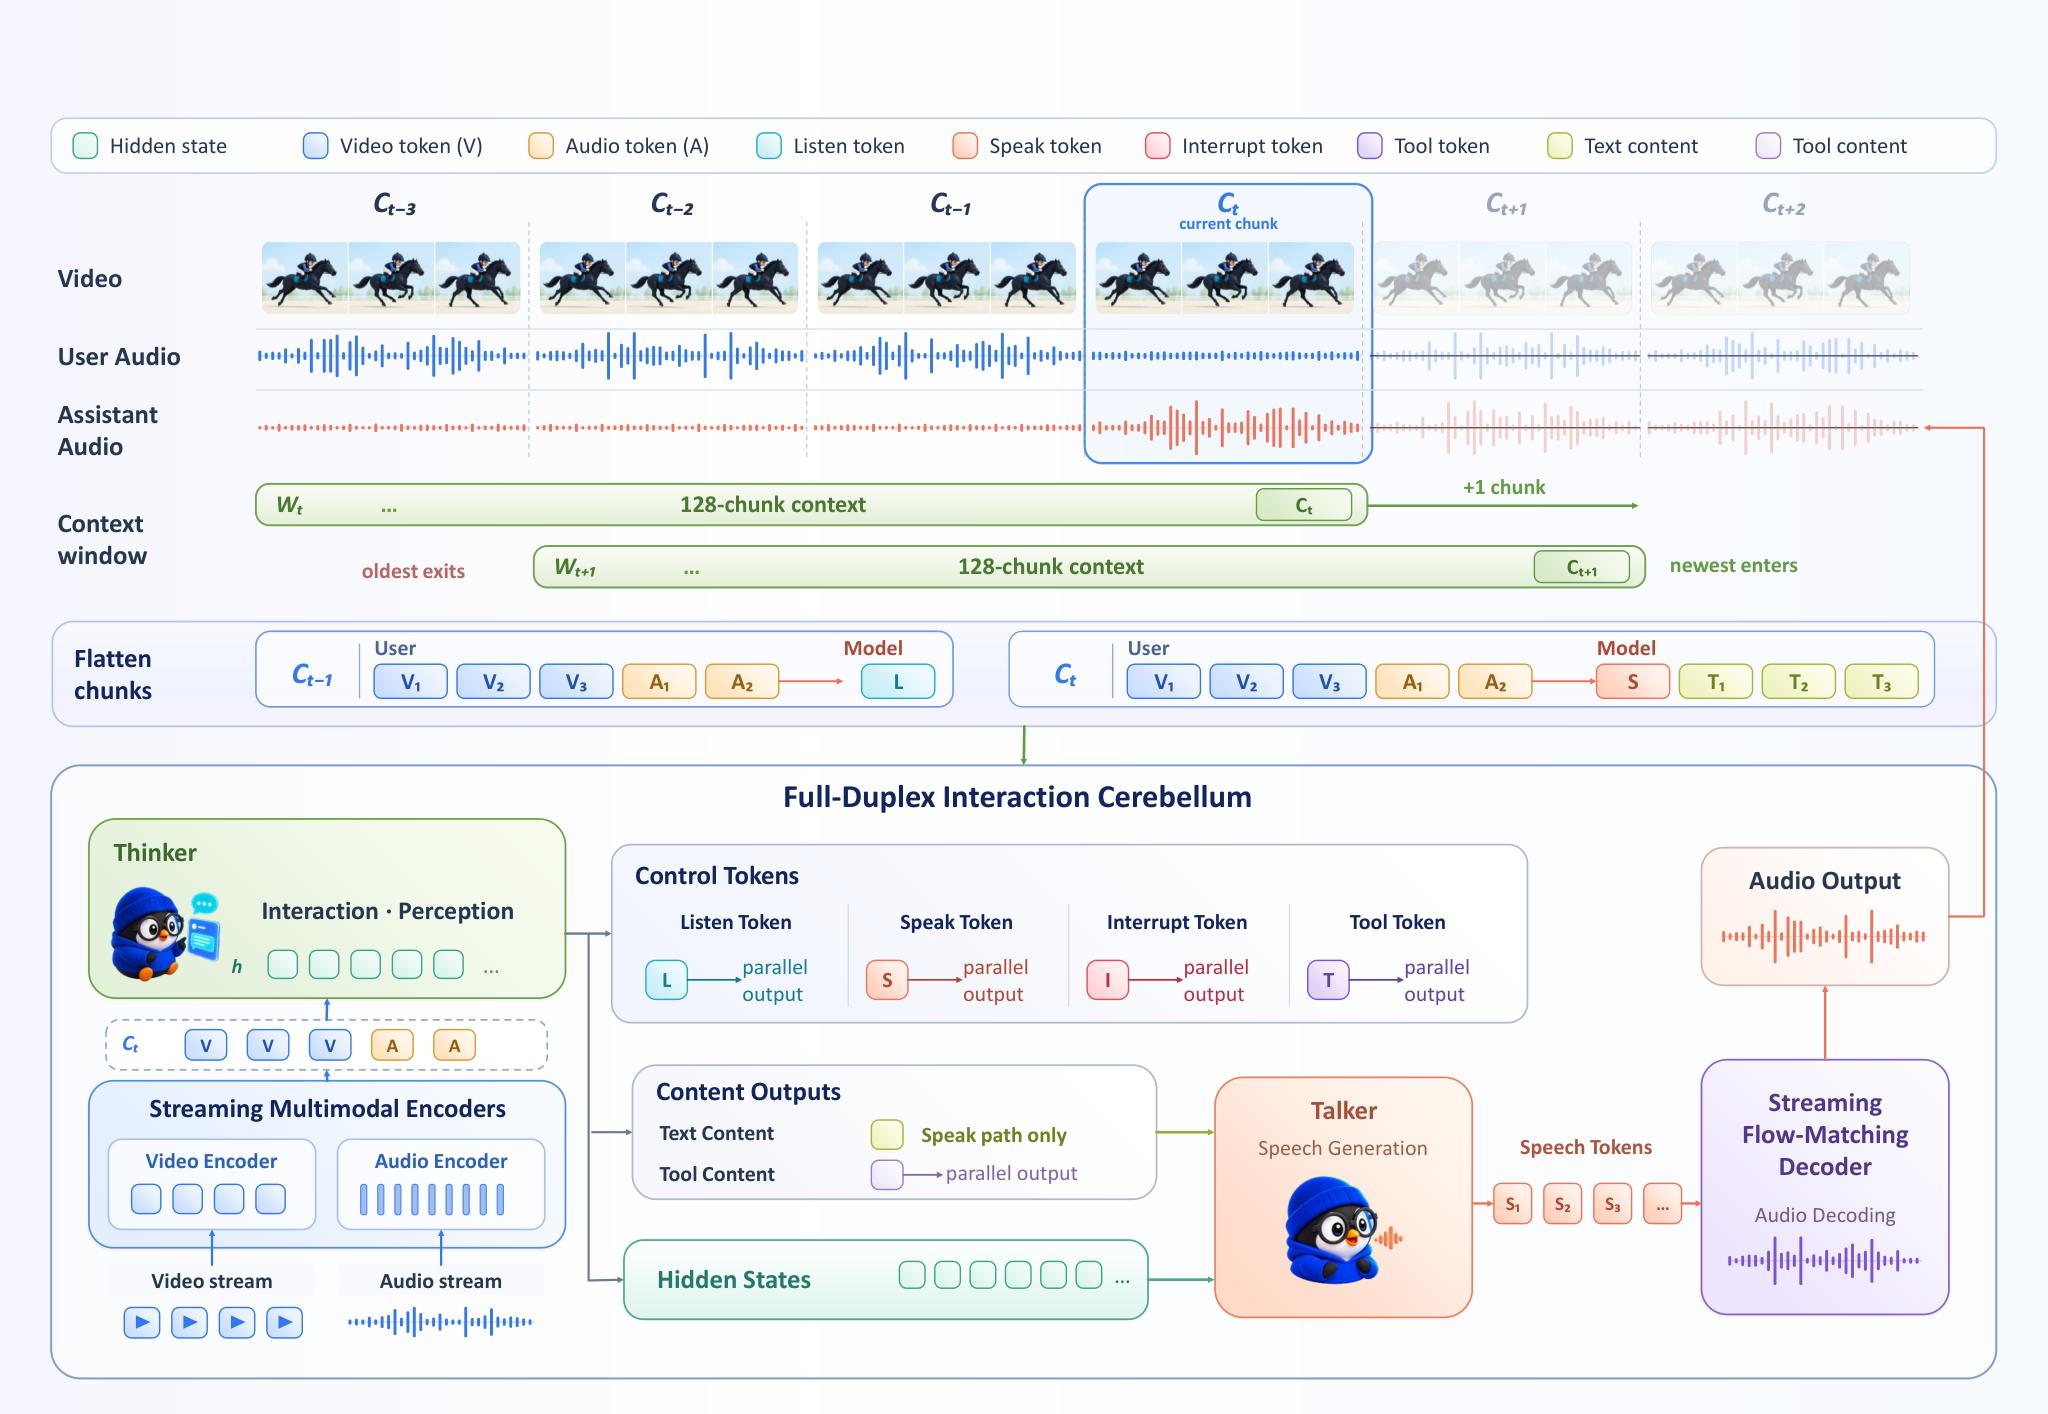
Figure 4 — Front Cerebellum의 상세 아키텍처
Gander의 성능은 Full-Duplex Interaction, Spoken Conversation, Omni Understanding의 세 가지 측면에서 종합적으로 평가되었습니다.
- Full-Duplex Interaction: Full-Duplex-Bench v3에서 Gander는 100%의 Take-turn율과 8.0%의 낮은 Interrupt율을 달성하며, 기존 상용 및 오픈 소스 시스템을 능가하는 최고의 Turn-taking Behavior를 보여주었습니다 [Table 3]. Back-brain-only 조건에서는 ToolSel이 0.934, RespQual이 0.740를 기록하여, Front Cerebellum과 Speech Channel이 제거되었을 때 도구 선택에서 모든 다른 시스템보다 우수한 성능을 보였습니다 [Table 3].
- Spoken Conversation: SpokenQA 벤치마크에서 Gander (9B)는 Llama Questions에서 75.60%, Web Questions에서 59.30%의 정확도를 기록하며 Full-Duplex 그룹 내에서 선두를 차지했으며, Turn-based 시스템 중에서도 전반적으로 두 번째로 높은 성능을 보였습니다 [Table 4]. 이는 스트리밍 방식이 Language Backbone에 보존된 지식 성능에 손실을 가져오지 않음을 시사합니다.
- Omni Understanding: Daily-Omni 벤치마크에서 Gander는 78.53%의 정확도를 달성했습니다 [Table 5]. Modality Ablation 실험 결과, Gander는 두 스트림을 실제로 융합하여 작동하며, Daily-Omni에서 Audio 및 Visual 입력을 함께 사용했을 때 +19.13의 Fusion gain을 보여주어, 단일 모달리티만 사용하는 경우보다 훨씬 뛰어난 성능을 입증했습니다 [Table 6].
4. Conclusion & Impact (결론 및 시사점)
Gander는 Cerebellum-Brain Framework와 Streaming Chunk-based Paradigm에 기반한 End-to-End 및 Scalable 아키텍처를 통해 Omni Understanding, Realtime Interaction, 그리고 Long Horizon Agentic Execution을 성공적으로 통합했습니다. 이 연구는 기존의 Turn-based Interaction의 한계를 극복하고, Human-AI Collaboration의 자연스러움과 효율성을 크게 향상시키는 중요한 발판을 마련했습니다. 특히, Gander의 뛰어난 Full-Duplex Interaction 능력과 Multimodal Fusion을 통한 복합적인 환경 이해는 AI Agent가 실제 세계에서 인간과 더욱 유동적이고 능동적으로 상호작용할 수 있는 가능성을 제시합니다. 향후 연구는 Data 및 Model Scaling, Stable Post-training, Brain-Cerebellum 아키텍처 탐색, Memory 및 Long Context Management, 그리고 통합된 평가 프레임워크 개발에 집중하여 Gander 패러다임의 견고성과 일반화 능력을 더욱 발전시킬 수 있을 것입니다.
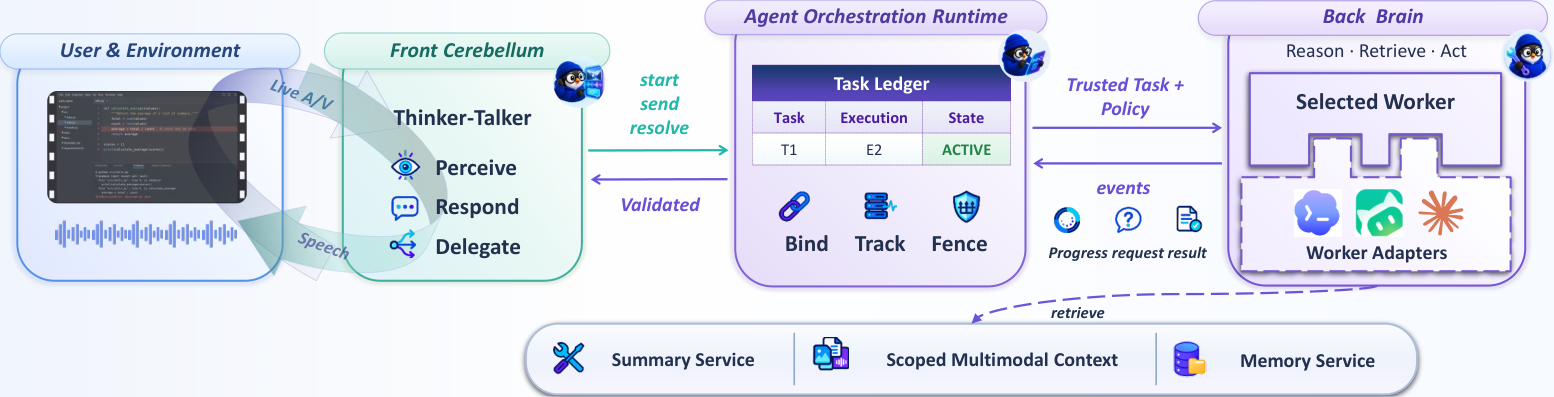
Figure 2 — Gander의 전체 아키텍처
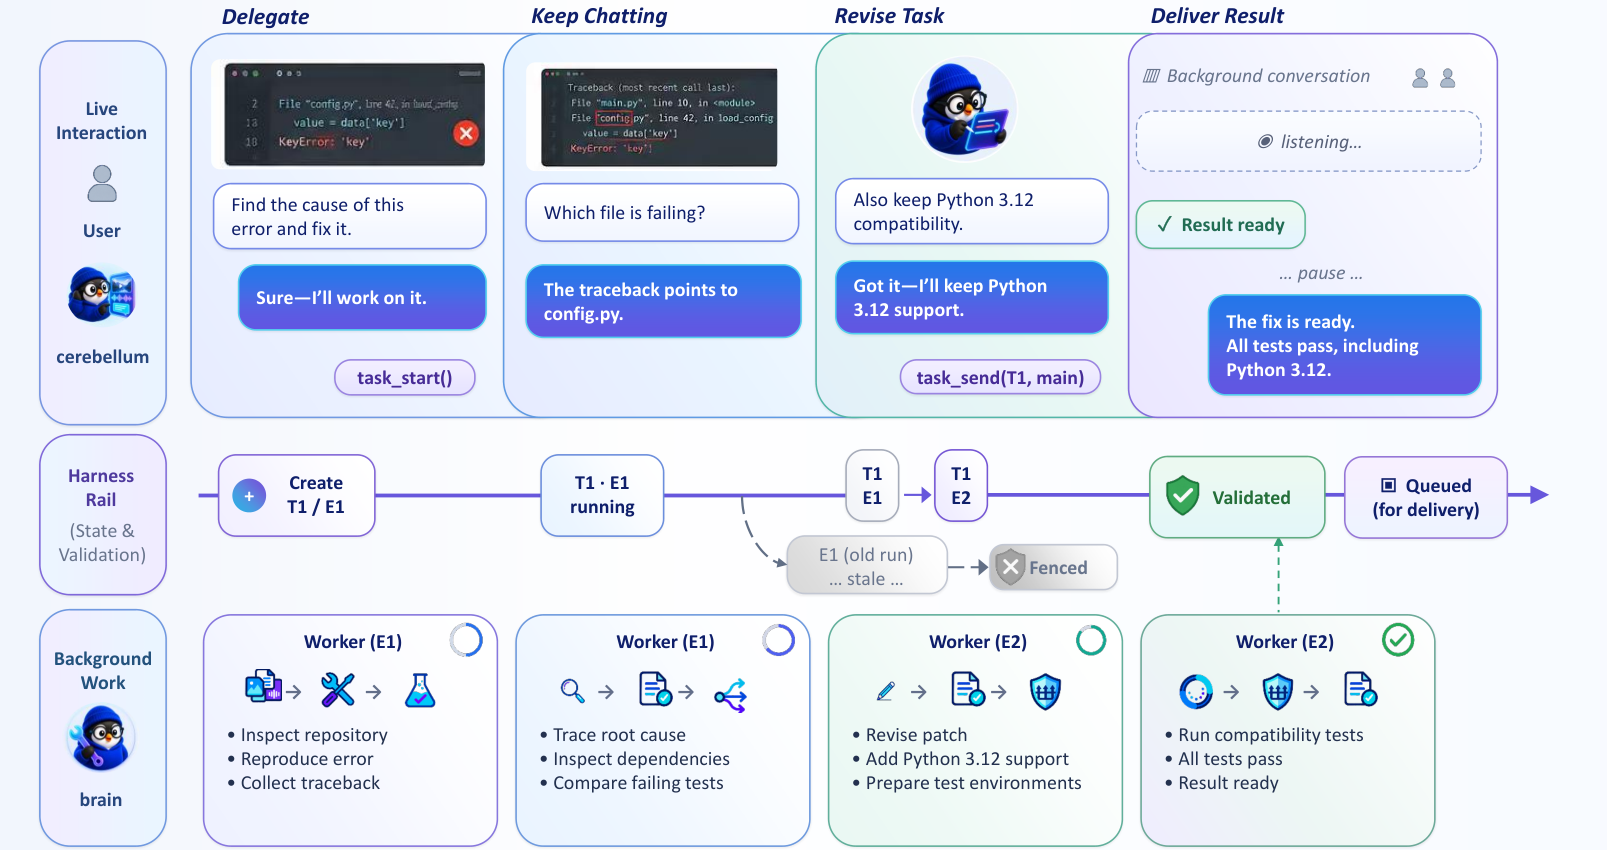
Figure 3 — Cerebellum-Brain 상호작용 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] StreamArena: Toward Continuous, Interactive, and Long-Horizon Agentic Streaming Video Understanding
- [논문리뷰] AgentCompass: A Unified Evaluation Infrastructure for Agent Capabilities
- [논문리뷰] StepAudio 2.5 Technical Report
- [논문리뷰] Claw-Eval: Toward Trustworthy Evaluation of Autonomous Agents
- [논문리뷰] Nemotron-Cascade 2: Post-Training LLMs with Cascade RL and Multi-Domain On-Policy Distillation
Review 의 다른글
- 이전글 [논문리뷰] NeoHorse-1: Towards Recursive Self-Improvement via Agentic Post-Training with Routing Harness
- 현재글 : [논문리뷰] Omni Interaction Agent Technical Report
- 다음글 [논문리뷰] Online Draft Co-Training for Speculative Decoding in Large-Scale, Long-Context RL Post-Training
댓글