[논문리뷰] SQS: Bayesian DNN Compression through Sparse Quantized Sub-distributions
링크: 논문 PDF로 바로 열기
저자: Ziyi Wang, Nan Jiang, Guang Lin, Qifan Song
1. Key Terms & Definitions (핵심 용어 및 정의)
- SQS: Sparse Quantized Sub-distributions의 약자로, Bayesian variational learning을 통해 weight pruning과 low-bit quantization을 동시에 수행하는 통합 프레임워크입니다.
- Spike-and-Slab Prior: weight의 희소성(sparsity)을 유도하기 위해 0에서의 point mass(spike)와 GMM 분포(slab)를 결합한 사전 분포입니다.
- GMM(Gaussian Mixture Models): quantized weight 분포를 모델링하여 정밀한 저비트(low-bit) 표현을 가능하게 하는 확률 분포 기법입니다.
- Bayesian Averaging: 모델의 추론 단계에서 가중치를 단일값으로 고정하지 않고, 학습된 posterior로부터 샘플링하여 예측값을 평균냄으로써 양자화 노이즈에 대한 강건성(robustness)을 높이는 기법입니다.
- Outlier-aware Windowing: Long-tailed weight 분포를 가진 LLM의 주요 가중치를 효과적으로 보존하기 위해 IQR 규칙 기반으로 윈도우를 설정하는 전략입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 대규모 신경망의 추론 비용을 줄이기 위한 기존 pruning과 quantization 기법들이 서로 독립적으로 수행될 때 발생하는 성능 저하 문제를 해결하고자 합니다. 기존 방식들은 압축률을 높이기 위해 압축 기법을 분리 적용하여 잠재적인 중복성을 간과하고 있으며, 이로 인해 자원 제약 환경에서 모델의 정확도 손실이 불가피했습니다. 특히, 최근 대규모 언어 모델(LLM)의 weight distribution이 일반적인 가우시안 분포를 따르지 않고 극단적인 outlier를 포함하는 long-tailed 형태를 보임에 따라, 기존의 균등한 양자화 기법은 중요한 가중치를 훼손하여 성능을 크게 저하시키는 한계가 있습니다. 이를 극복하기 위해 저자들은 가중치 희소성과 양자화를 동시에 최적화하는 통합적인 Bayesian 학습 접근법을 제안합니다. [Figure 1]에 나타난 바와 같이, 본 제안 방법론은 spike component를 통한 pruning과 slab(GMM) component를 통한 quantization을 하나의 변분 최적화 프레임워크 안에서 결합하여 압축률과 성능 유지 간의 최적점을 찾아냅니다.
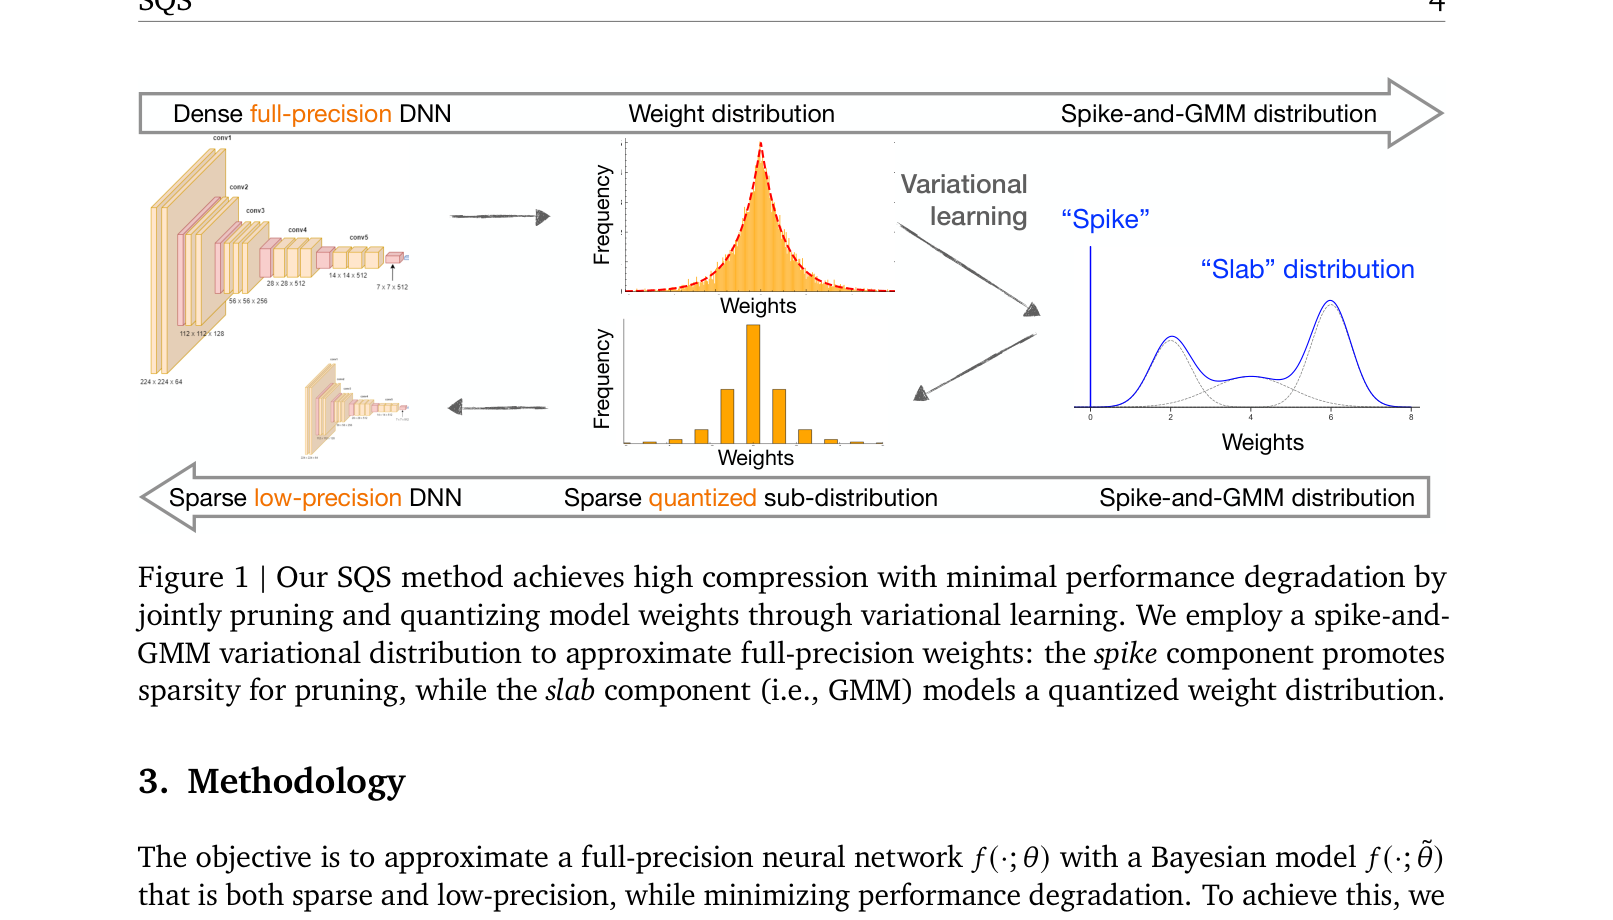
Figure 1 — SQS의 핵심 아이디어인 spike-and-slab prior 기반 변분 학습 프레임워크의 구조를 명확히 보여줌
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 spike-and-slab prior를 GMM과 결합하여 학습 가능한 sparse quantized sub-distribution을 정의함으로써, pruning과 quantization을 통합적인 변분 학습 목표로 공식화합니다. 저자들은 이 목적 함수가 계산적으로 난해하다는 점을 해결하기 위해 tractable한 근사 objective를 유도하였으며, 이론적으로는 이 방법이 실제 타겟 함수로 수렴함을 보장합니다. 또한, 극단적인 weight outliers를 보호하기 위해 IQR 규칙을 활용한 outlier-aware windowing 기법을 적용하였습니다. 실험 결과, ResNet, BERT-base, Llama3.2, Qwen2.5 모델 모두에서 기존 방식 대비 압축률을 비약적으로 높이면서도 성능 손실은 최소화하였습니다. ResNet-56 모델의 경우, 32배 압축률에서 단 0.84%의 Top-1 accuracy drop만을 기록하여 다른 baselines 대비 우월한 효율성을 입증했습니다. [Table 1]과 [Table 2]에서 보듯, SQS는 동일한 bit 설정 하에서 가장 높은 압축률을 달성하는 동시에 F1 score 및 accuracy drop을 최소화하여 압축 효율성 측면에서 일관된 성능 우위를 보입니다.
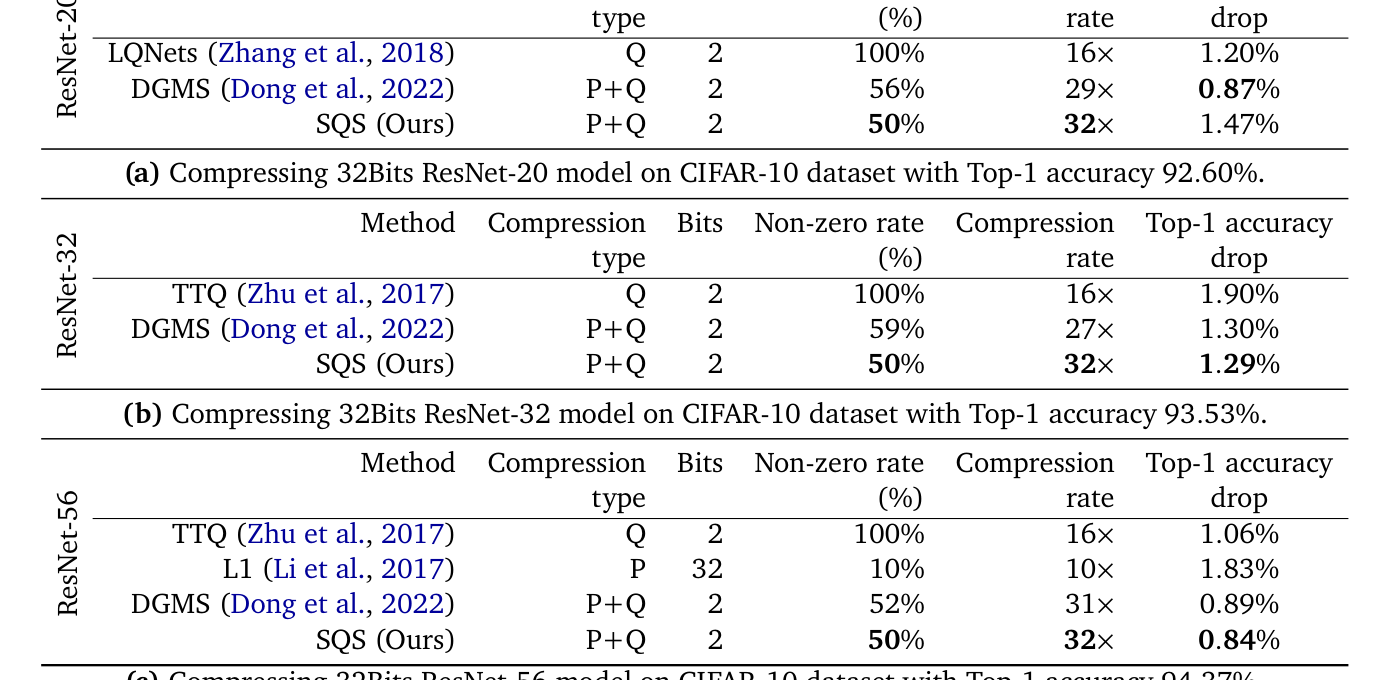
Table 1 — 다양한 ResNet 모델에서 SQS가 기존 방식 대비 압축률과 정확도 면에서 우수함을 증명하는 핵심 실험 결과
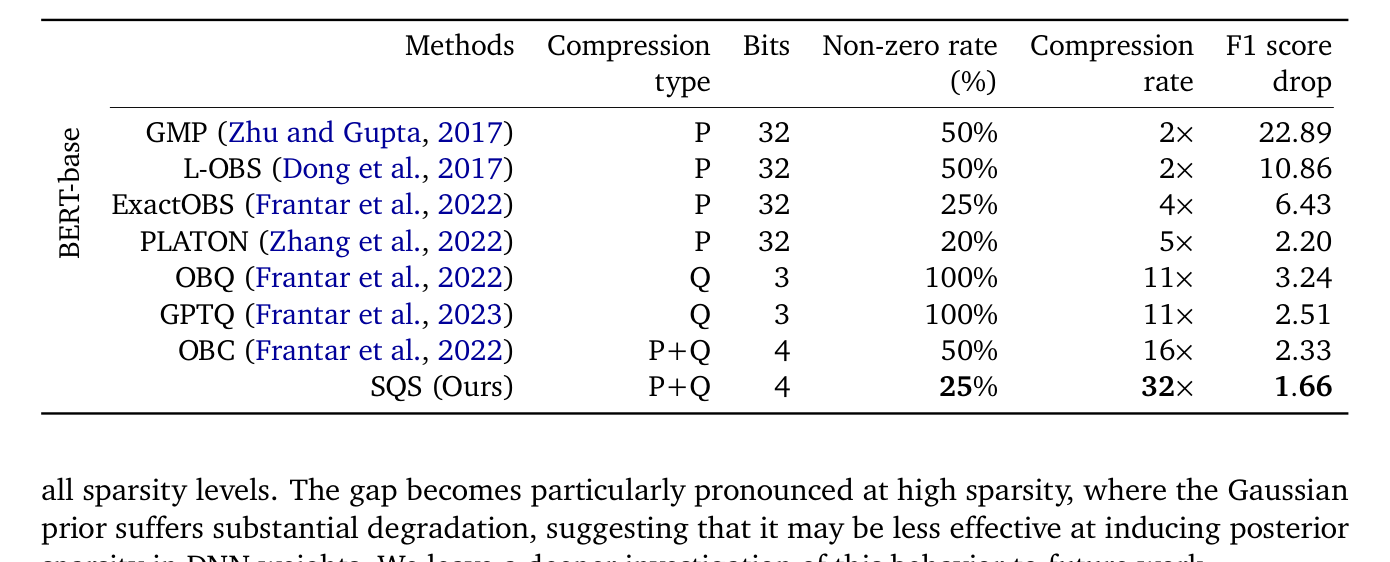
Table 2 — 대형 모델(BERT-base)에 대한 압축 효율성을 증명하는 정량적 비교 결과
4. Conclusion & Impact (결론 및 시사점)
본 논문은 pruning과 quantization을 단일 최적화 프로세스로 통합한 Bayesian 프레임워크 SQS를 제안하여, 고압축 환경에서의 모델 배포 성능을 혁신적으로 개선하였습니다. 이 연구는 이론적 수렴성을 보장함과 동시에, 가중치의 통계적 특성을 반영한 적응형 윈도우 전략을 도입하여 모델 성능 유지와 압축 효율성이라는 두 마리 토끼를 잡는 성과를 거두었습니다. 특히 LLM 모델들의 가중치 분포 특성을 잘 포착함으로써 실무적인 효율성 측면에서 강력한 근거를 제시했습니다. 본 연구 결과는 자원 제약이 심한 Edge 기기나 모바일 환경에서 고성능 모델의 경량화 배포를 위한 핵심 기반 기술로 활용될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Flash-GMM: A Memory-Efficient Kernel for Scalable Soft Clustering
- [논문리뷰] BitNet Distillation
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] QWHA: Quantization-Aware Walsh-Hadamard Adaptation for Parameter-Efficient Fine-Tuning on Large Language Models
- [논문리뷰] X-AuT: Progressive Audio-Encoder Compression for Speech LLMs with Cross-Scale Distillation
Review 의 다른글
- 이전글 [논문리뷰] RoboSPA: Can VLA Models Go Beyond Simple Scenes and Short-Horizon Tasks?
- 현재글 : [논문리뷰] SQS: Bayesian DNN Compression through Sparse Quantized Sub-distributions
- 다음글 [논문리뷰] SceneMosaic: Efficient and Diverse Simulation-Ready Scene Generation via Hybrid Agentic Layout Evolution
댓글