[논문리뷰] Revisiting Complete Reasoning Traces for Post-Training
링크: 논문 PDF로 바로 열기
저자: Jaehui Hwang, Sangdoo Yun, Byeongho Heo, Dongyoon Han
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Reasoning Trajectories: 문제 해결 과정에서 LLM이 생성하는 중간 단계의 사고 과정 및 단계별 추론 시퀀스.
- E-SFT (Endpoint-based SFT): 전체 reasoning trajectory 중 중간의 중복적인 단계를 제거하고, 시작(Prefix)과 끝(Suffix) 부분만을 유지하여 학습하는 효율적인 fine-tuning 기법.
- Lost in the Middle: LLM이 긴 문맥 내에서 중간 부분의 정보를 적절히 참조하지 못하고 시작과 끝 부분에 집중하는 현상.
- SFT (Supervised Fine-Tuning): 사전에 수집된 reasoning trace를 사용하여 모델의 추론 능력을 향상시키는 post-training 단계의 학습 방식.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 LLM의 post-training 과정에서 필수적인 것으로 간주되던 긴 reasoning trajectory가 실제로는 많은 중복 정보를 포함하고 있어 효율성이 떨어진다는 문제점을 해결하고자 합니다. 기존 연구들은 추론 능력을 높이기 위해 방대한 분량의 전체 reasoning trace를 사용해 왔으나, 이는 연산 비용을 증가시킬 뿐만 아니라 모델이 중요한 정보보다 사소한 detour나 반복에 매몰되게 만드는 경향이 있습니다. 특히 LLM이 이미 정답을 도출하기 전에 내부적으로 필요한 추론 과정을 예측할 수 있다는 점에 주목하여, 긴 전체 trajectory를 모두 학습하는 것이 최선인지에 대한 근본적인 의문을 제기합니다.
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 reasoning trajectory 내의 중간 단계들이 모델의 최종 정답 도출에 최소한의 기여만을 한다는 점을 attention 분석과 segment ablation 분석을 통해 입증하고, 이를 토대로 시작과 끝 부분의 정보만을 학습하는 E-SFT를 제안합니다. 실험 결과, E-SFT는 전체 trajectory를 학습하는 baseline 대비 학습 데이터의 redundancy를 제거하면서도 성능 저하 없이 오히려 추론 성능을 향상시키는 결과를 보였습니다. [Table 1]에서 확인할 수 있듯이, Qwen2.5-32B 모델의 경우 E-SFT 기법을 적용했을 때 AIME24, GPQA-D, MATH 평균 성능이 75.19로, 전체 trace를 사용한 73.51보다 우수한 성과를 거두었습니다. 또한, [Figure 2]는 학습 과정에서 모델의 attention이 trajectory의 시작과 끝에 집중됨을 시각적으로 보여주며, 중간 단계의 정보는 모델이 스스로 내재적 지식을 통해 복원할 수 있음을 강력히 시사합니다. 이러한 방식은 SFT 외에도 GRPO와 같은 강화학습 기반의 post-training 및 OPD(On-Policy Distillation) 기법에서도 일관된 성능 개선을 입증하였습니다.
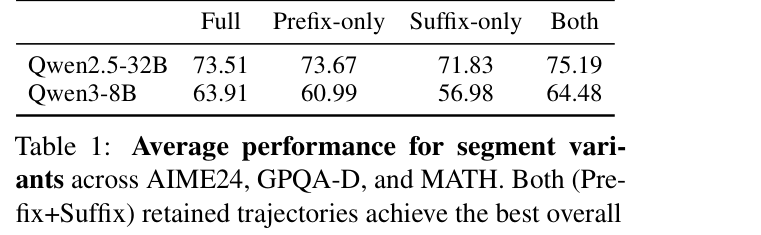
Table 1 — 제안하는 E-SFT 방식이 기존 전체 trace 학습(Full) 대비 우수한 성능을 보임을 증명하는 핵심 실험 결과
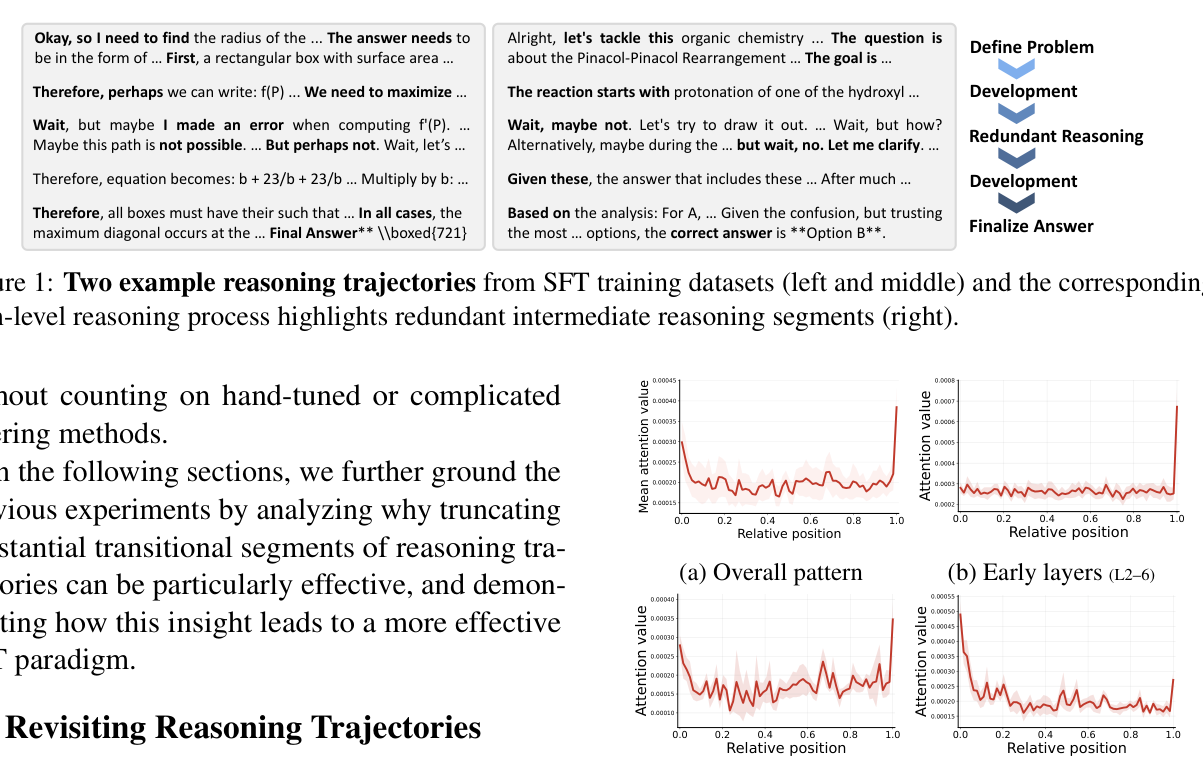
Figure 2 — 모델이 추론 과정 중 trajectory의 양 끝에 집중하고 중간 단계를 경시함을 보여주는 분석 데이터
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 모든 reasoning trace가 항상 필요한 것은 아니며, 효율적이고 구조적인 post-training을 위해서는 중간 단계의 중복성을 제거하는 것이 필수적임을 밝혀냈습니다. 제안된 E-SFT는 복잡한 필터링 과정 없이도 모델의 추론 성능을 향상시킬 뿐만 아니라 학습 효율성을 극대화할 수 있는 실용적인 가이드라인을 제공합니다. 이 연구는 향후 LLM의 효율적인 학습 데이터 설계와 post-training 프로세스 최적화에 있어 새로운 관점을 제시하며, 대규모 reasoning model의 배포 및 유지보수 비용을 절감하는 데 크게 기여할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Unlocking Data Value in Finance: A Study on Distillation and Difficulty-Aware Training
- [논문리뷰] Revisiting the Necessity of Lengthy Chain-of-Thought in Vision-centric Reasoning Generalization
- [논문리뷰] Thinking Sparks!: Emergent Attention Heads in Reasoning Models During Post Training
- [논문리뷰] Towards a Unified View of Large Language Model Post-Training
- [논문리뷰] Miles v0.1: Production-Level Post-Training
Review 의 다른글
- 이전글 [논문리뷰] Reference-Based Bias Detection in LLMs via Relative Representations of Hidden States
- 현재글 : [논문리뷰] Revisiting Complete Reasoning Traces for Post-Training
- 다음글 [논문리뷰] SAEScientist-Bench: Can AI Agents Conduct Autonomous SAE Interpretability Research?
댓글