[논문리뷰] Reference-Based Bias Detection in LLMs via Relative Representations of Hidden States
링크: 논문 PDF로 바로 열기
저자: Marek Jeliński, Jan Dubiński, Maciej Chrabąszcz, Sebastian Cygert
1. Key Terms & Definitions (핵심 용어 및 정의)
- Representational Bias Shift ($\Delta B$): 모델의 fine-tuning 전후 hidden-state 내에서 타겟 그룹이 긍정적/부정적 속성과 맺는 연관성 변화를 정량화한 지표입니다.
- Relative Representations (RR): 고정된 anchor 문장들과의 유사도(cosine similarity)를 활용하여, 서로 다른 모델들의 hidden-state를 비교 가능한 공유 공간으로 투영하는 기법입니다.
- SEAT (Sentence Encoder Association Test): 절대적인 sentence embedding을 사용하여 표현 공간 내의 편향을 측정하는 기존의 대표적인 방법론입니다.
- Anchor Sentences: 서로 다른 두 모델(reference model과 audited model)을 동일한 비교 공간으로 정렬하기 위해 사용되는 고정된 기준 문장 세트입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 fine-tuning 과정에서 발생하는 LLM의 내재적 편향 변화를 효과적으로 감지하기 위한 reference-based auditing 프레임워크를 제안합니다. 기존의 출력 기반(output-based) 편향 평가 방식은 비용이 많이 드는 벤치마크나 judge 모델에 의존하며, 텍스트 생성 단계에서 명시적으로 드러나지 않는 내부 표현의 변화를 놓칠 수 있다는 한계가 있습니다 [Figure 1]. 또한, fine-tuning이 모델의 latent geometry를 변형시키기 때문에, 절대적인 hidden state 자체를 모델 간에 직접 비교하는 것은 기술적으로 불가능합니다. 저자들은 이러한 문제를 해결하기 위해, 모델의 내부 표현을 고정된 anchor 문장 기반의 상대적 표현으로 변환함으로써 fine-tuning 전후의 편향 변화를 추적하고자 합니다.
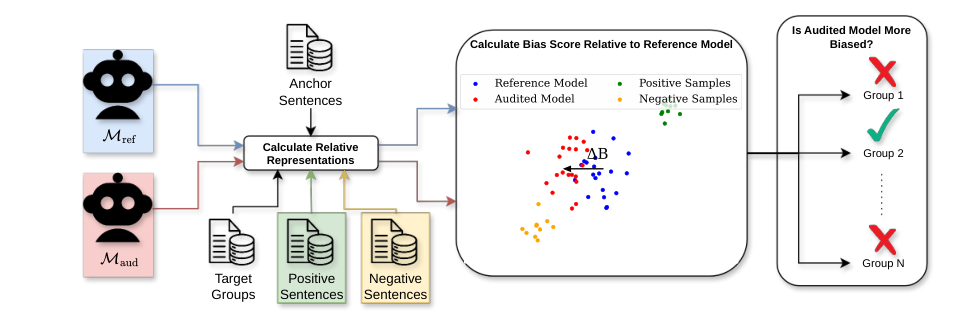
Figure 1 — 편향 평가 파이프라인 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 각 문장을 anchor 세트와의 유사도로 인코딩하는 relative representation 기법을 도입하여 audited model과 reference model을 공유 공간에 투영합니다 [Figure 1]. 이 공간에서 target 그룹과 긍정적/부정적 attribute 문장 간의 Euclidean distance를 계산하여 $\Delta B$를 산출합니다. 실험 결과, $\Delta B$는 3개의 모델 패밀리와 3개의 벤치마크 환경(WildGuardMix, DecodingTrust, ToxiGen)에서 출력 기반 편향 변화와 유의미한 상관관계를 보였습니다. 구체적으로, full fine-tuning 환경에서 Pearson correlation은 최대 $|r|=0.84$ ($p < 0.001$)를 기록하였습니다 [Table 1]. 또한, 제안된 방법은 increased-bias 체크포인트를 감지하는 데 있어 0.65에서 0.99의 ROC AUC 성능을 보였으며, 모든 비교 대상인 SEAT 기반 베이스라인보다 우수한 식별력을 입증하였습니다 [Figure 3]. 이 방법론은 일반적인 출력 기반 벤치마크 대비 약 33–50배 적은 연산 자원을 소모합니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 hidden state의 상대적 표현을 활용하여 fine-tuning이 유도하는 모델의 편향 변화를 비용 효율적으로 감지할 수 있음을 입증했습니다. $\Delta B$ 지표는 출력 기반 벤치마크를 대체하기보다는 상호 보완적인 도구로서, 모델 배포 전 단계에서 잠재적인 위험을 신속하게 점검하는 데 기여할 수 있습니다. 본 연구는 향후 LLM 정렬(alignment) 과정에서 발생하는 의도치 않은 편향의 부작용을 투명하게 모니터링할 수 있는 실용적인 프레임워크를 제시했다는 점에서 학계와 산업계에 중요한 시사점을 가집니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] OPRD: On-Policy Representation Distillation
- [논문리뷰] Learn Hard Problems During RL with Reference Guided Fine-tuning
- [논문리뷰] MMFineReason: Closing the Multimodal Reasoning Gap via Open Data-Centric Methods
- [논문리뷰] Sliding Window Attention Adaptation
- [논문리뷰] Do LLMs Feel? Teaching Emotion Recognition with Prompts, Retrieval, and Curriculum Learning
Review 의 다른글
- 이전글 [논문리뷰] RESCUE-BENCH: Towards Relation-Aware Multi-Party Emotional Support Conversation Systems
- 현재글 : [논문리뷰] Reference-Based Bias Detection in LLMs via Relative Representations of Hidden States
- 다음글 [논문리뷰] Revisiting Complete Reasoning Traces for Post-Training
댓글