[논문리뷰] DRG-MAPPO: Hierarchical Dynamic Role-Graph Multi-Agent Reinforcement Learning for Cooperative Air Combat
링크: 논문 PDF로 바로 열기
저자: Junlin Liu, Chengwei Li, Yang Gao, Hui Chang, Xinchen Zhang, Zhijun Zhao, Hao Zhao
1. Key Terms & Definitions (핵심 용어 및 정의)
- DRG-MAPPO (Dynamic Role-Graph Multi-Agent Proximal Policy Optimization): 본 논문에서 제안하는 계층적 MARL 프레임워크로, 그래프 기반 관계 모델링과 동적 역할 할당을 결합하여 공중전의 협력적 제어 문제를 해결함.
- CTDE (Centralized Training and Decentralized Execution): 학습 과정에서는 전체 상태 정보를 활용하여 정교한 가치를 추정하고, 실제 배포 시에는 로컬 관측치만을 사용하여 분산된 의사결정을 수행하는 학습 패러다임.
- Graph Attention Network (GAT): 전장 내 객체들 간의 복잡하고 시변하는(time-varying) 위상적 관계를 구조적으로 포착하기 위해 적용된 어텐션 메커니즘.
- Temporal Commitment Mechanism: 역할 할당의 빈번한 변동(oscillation)을 방지하고 행동의 일관성을 유지하기 위해 고정된 결정 간격 내에서만 역할을 재설정하는 기법.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 현대 공중전의 복잡한 멀티 에이전트 협력 문제 해결을 위한 MARL 프레임워크의 한계점을 개선하고자 한다. 기존의 평면적(flat) 아키텍처는 전장 내 엔티티 간의 구조적 관계를 파악하는 능력이 부족하며, 전술적 역할(tactical roles)에 대한 명시적 모델링이 결여되어 있어 협력적 작업 할당이 모호하다는 문제가 있다. 결과적으로 기존 연구들은 미사일, 레이더, 아군 간의 상호작용이 급변하는 환경에서 최적의 전술적 기회를 포착하는 데 어려움을 겪는다 [Figure 2].
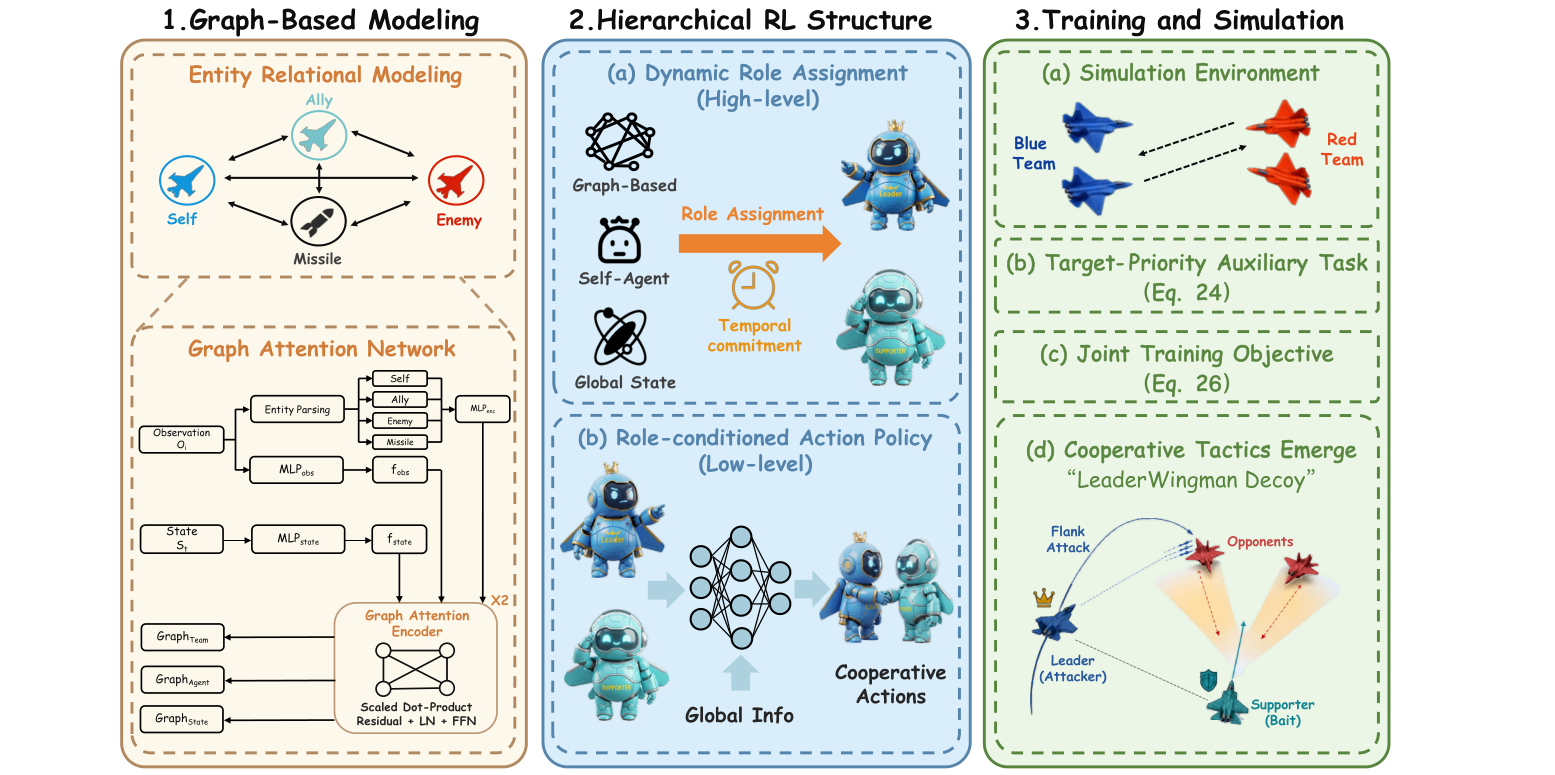
Figure 2 — DRG-MAPPO 전체 프레임워크
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 그래프 기반의 관계 모델링과 계층적 정책 구조를 결합한 DRG-MAPPO 프레임워크를 제안한다. 먼저, 전장 환경을 그래프 구조로 재구성하고 어텐션 메커니즘을 통해 아군, 적군, 미사일 간의 시변적 의존성을 파악한다. 상위 정책(High-level policy)은 이 정보를 바탕으로 에이전트에게 리더 혹은 서포터와 같은 전술적 역할을 동적으로 할당하며, 하위 정책(Low-level policy)은 해당 역할에 따라 구체적인 기동 행동을 선택한다 [Figure 2]. 또한, Target-priority auxiliary task를 도입하여 별도의 보상 설계 없이도 '집중 사격(focus-fire)'과 같은 협력적 전술이 발현되도록 유도한다.
실험 결과, DRG-MAPPO는 기존 baseline 대비 뛰어난 성능을 보이며 87%의 승률을 기록하였다 [Figure 3]. 이는 복잡한 다대다 교전 환경에서 구조적 인지(relational modeling)와 계층적 의사결정이 통합된 접근 방식이 학습 안정성과 전술적 협력을 크게 향상시킴을 입증한다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 계층적 역할 그래프 기반의 MARL 프레임워크를 통해 멀티 UAV 공중전의 전술적 협력 문제를 효과적으로 해결하였다. 제안된 모델은 높은 수준의 승률을 달성했을 뿐만 아니라, '미끼 및 측면 공격(bait-and-flank)' 및 '집중 사격'과 같이 해석 가능한 고급 전술 행동을 성공적으로 유도하였다 [Figure 5]. 본 연구는 복잡한 동적 환경에서 다수의 자율 시스템이 협력할 수 있는 확장 가능한 MARL 프레임워크를 제시했다는 점에서 높은 학술적 가치를 지닌다.
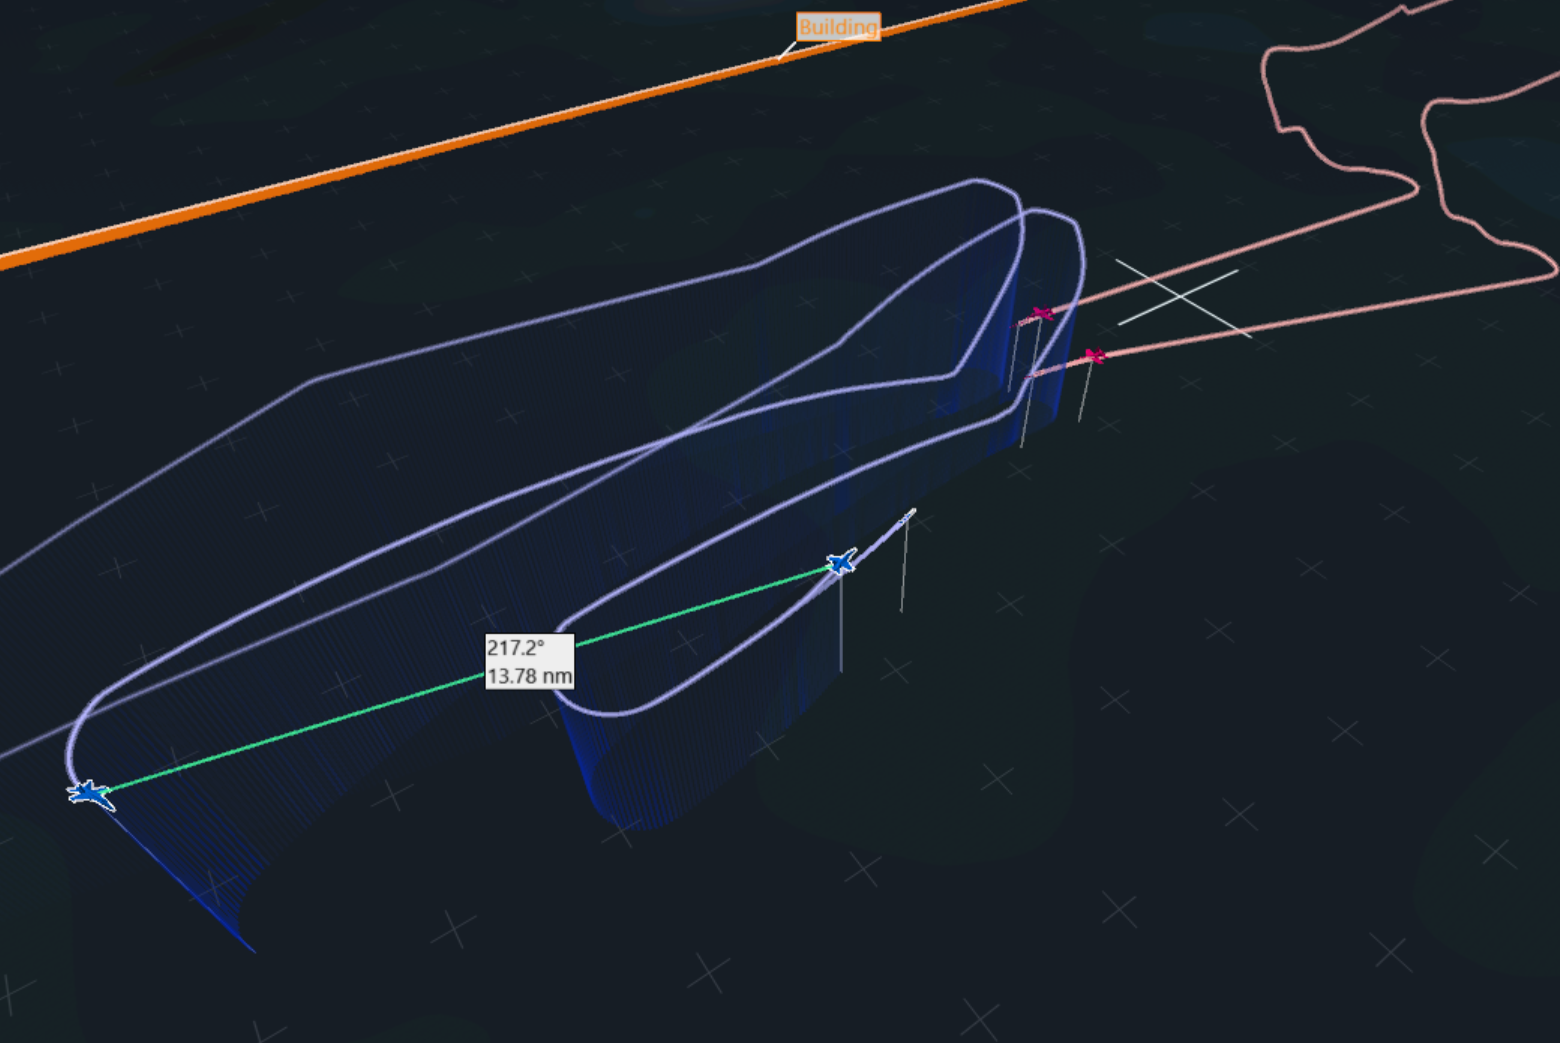
Figure 5 — 전술 행동 시각화(Bait-and-flank)
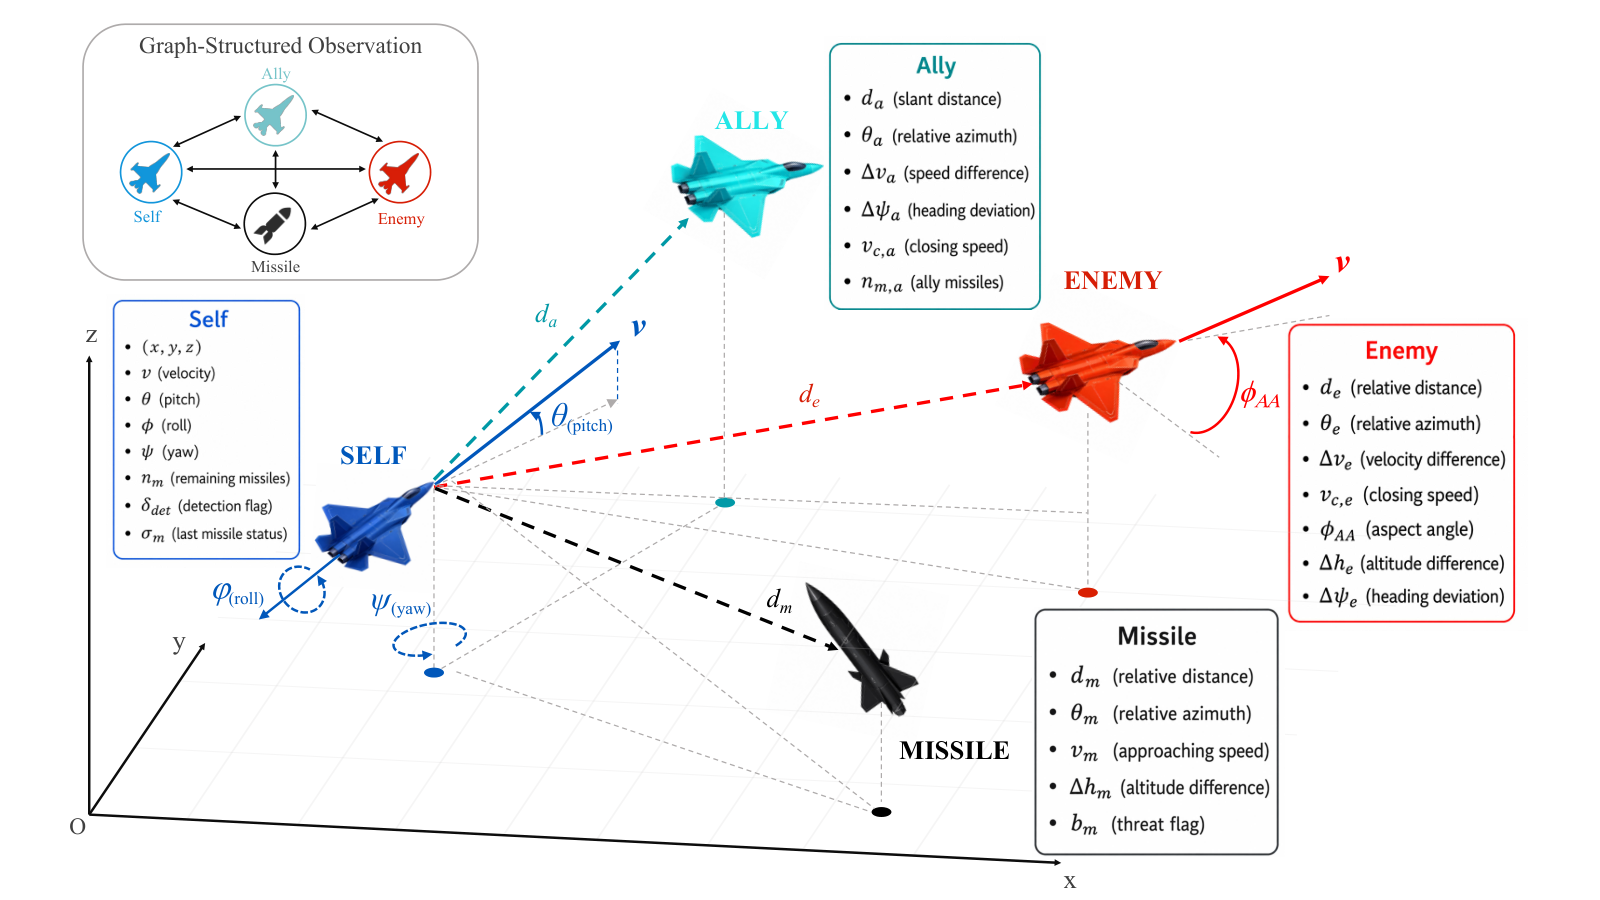
Figure 1 — 전장 전술 기하구조 및 관측 공간
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Co-Evolution in Agentic Systems: Toward Self-Directed Evolution Beyond Human Design
- [논문리뷰] Code-Space Response Oracles: Generating Interpretable Multi-Agent Policies with Large Language Models
- [논문리뷰] Discovering Multiagent Learning Algorithms with Large Language Models
- [논문리뷰] Multi-agent cooperation through in-context co-player inference
- [논문리뷰] WideSeek-R1: Exploring Width Scaling for Broad Information Seeking via Multi-Agent Reinforcement Learning
Review 의 다른글
- 이전글 [논문리뷰] CARDEA: Auditable Reasoning Grounded in Spatial Evidence for End-to-End Coronary Angiography Interpretation
- 현재글 : [논문리뷰] DRG-MAPPO: Hierarchical Dynamic Role-Graph Multi-Agent Reinforcement Learning for Cooperative Air Combat
- 다음글 [논문리뷰] EvoSafeHarness: Evolving Model- and Domain-Specific Harnesses for Securing Agents
댓글