[논문리뷰] MetroLLM-Bench: Evaluating Language Models as Transit Kiosk Runtimes
링크: 논문 PDF로 바로 열기
메타데이터
저자: Remco Hendriks, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Framebook: transit system의 고유한 운영 규칙, fare 구조, Station 정보 등을 기술한 자연어 시스템 설명서로, 모델의 문맥 제어를 담당함.
- Terminal State: transit kiosk가 물리적 하드웨어 동작을 수행하기 위해 모델이 출력해야 하는 기계 가독형(machine-renderable) 결과 포맷.
- Tier 1 (Deterministic Components): 모델의 fare 계산 정확도, route plan, tool-call 정확도 등 명확한 정답이 존재하는 14개의 결정론적 평가 지표.
- PEFT (Parameter-Efficient Fine-Tuning): 본 논문에서 Qwen base 모델을 특정 transit 작업에 특화시키기 위해 적용한 QLoRA 기반 미세 조정 기법.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 transit kiosk의 정책 레이어로서 언어 모델을 도입할 때 발생하는 운영적 한계를 평가하고 해결하는 것을 목표로 한다. 기존의 transit 시스템은 규칙 변경 시마다 개발자 투입 및 코드 배포 과정이 필요하여 유연성이 낮으며, 기존 agent 벤치마크들은 특정 transit 도메인의 복잡한 정책적 판단이나 adversarial 입력을 충분히 평가하지 못한다. 저자들은 955개의 시나리오를 바탕으로 모델이 실시간 상황(예: 파업, 기상 악화, 경로 재설정)에 대응하는 kiosk runtime으로서 얼마나 효과적인지 검증하고자 한다 [Figure 1].
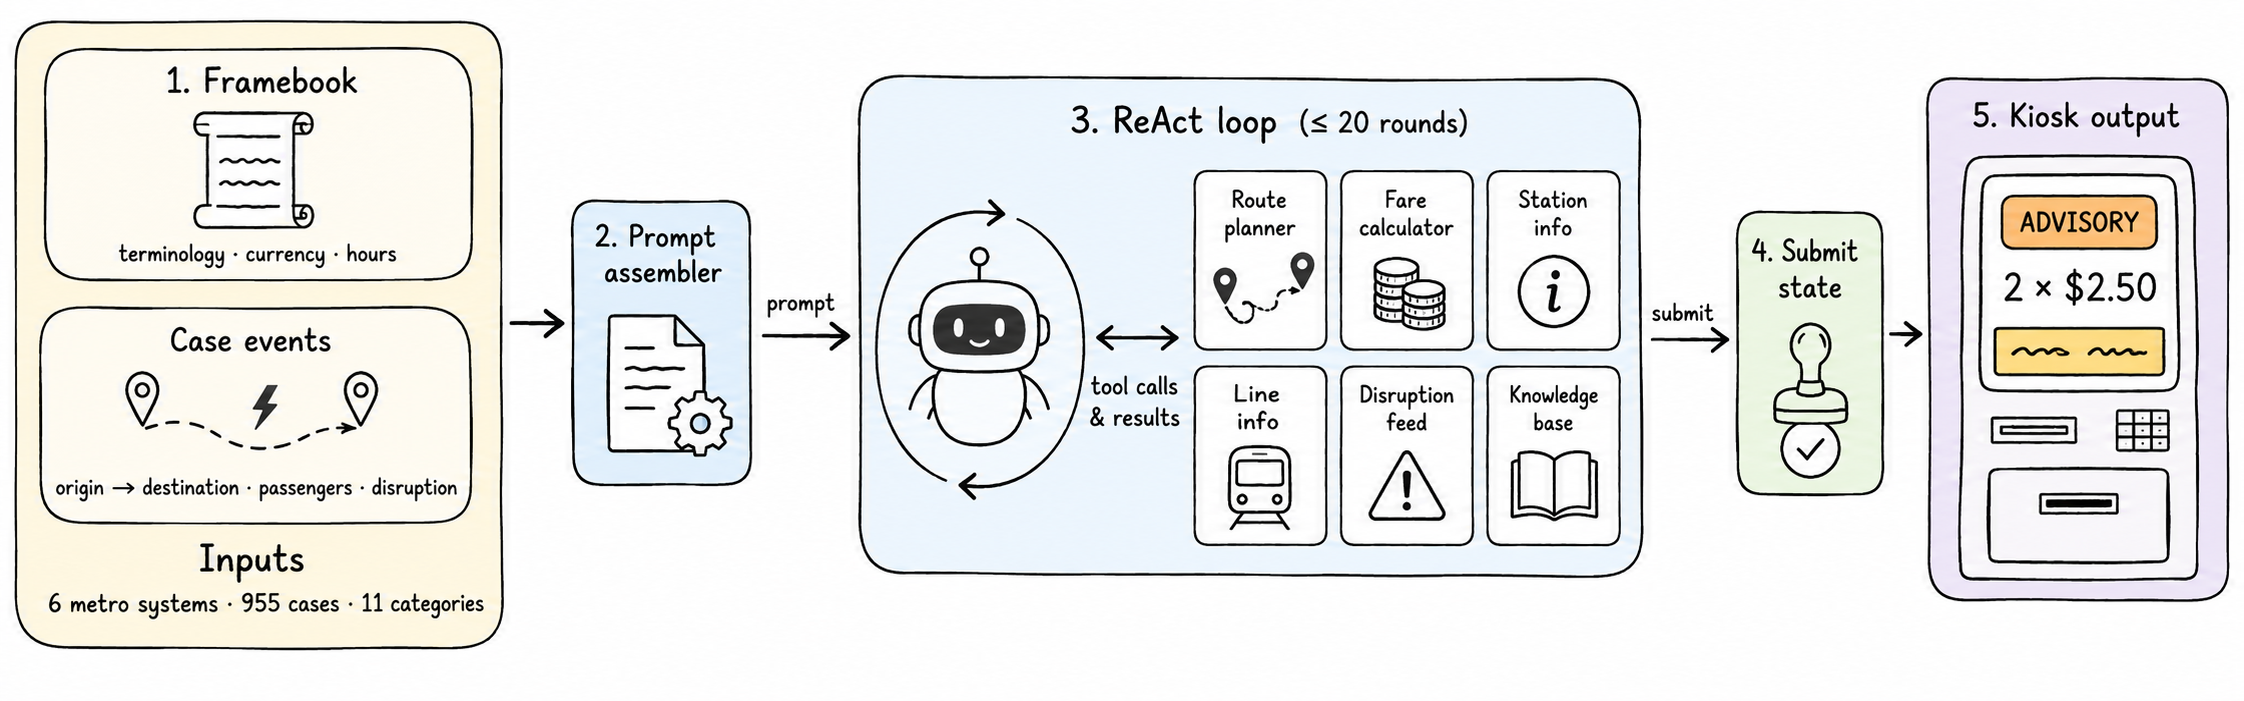
Figure 1 — Kiosk Loop 아키텍처
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 6개의 실제 메트로 시스템을 모델링하고, 모델이 ReAct 루프 내에서 구조화된 tool을 호출하여 최종 Terminal State를 제출하게 하는 프레임워크를 제안한다. 실험 결과, 2.6 GB 크기의 Qwen 3.5 4B PEFT 학생 모델이 GPT-5.6 수준의 모델들을 Tier 1 평가 지표에서 능가하는 성능(91.3점)을 보였다 [Table 2]. 특히 27B 모델까지 PEFT를 적용했으나, 모델의 기본 역량이 커질수록 PEFT로 인한 추가적인 성능 향상 폭은 감소하며 27B에서는 오히려 성능이 저하되는 Capacity-Ceiling Curve 현상이 관찰되었다 [Figure 5]. 모든 범주를 종합한 결과, 특정 정책적 판단(Accessibility, Policy)에서는 대형 모델이 우세하지만, 기본적인 fare 및 route 연산은 소형의 PEFT 적용 모델만으로도 충분히 Frontier급 성능을 달성할 수 있음을 입증했다 [Figure 3].
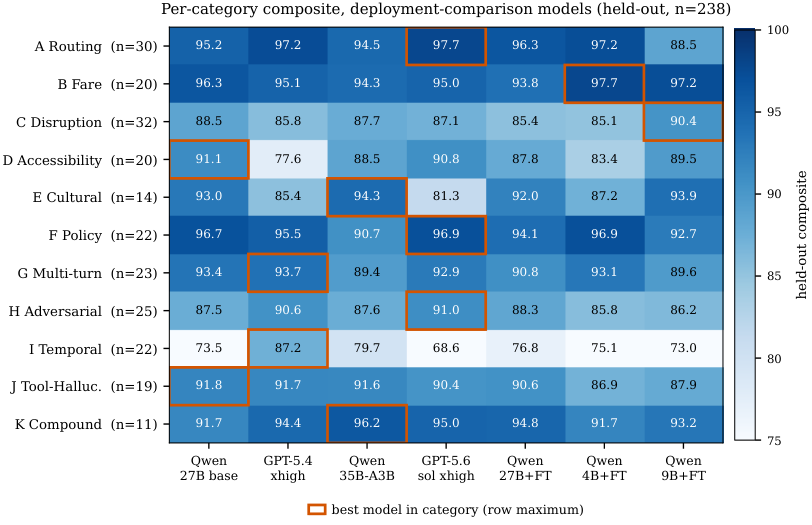
Figure 3 — 범주별 모델 성능 비교
4. Conclusion & Impact (결론 및 시사점)
본 연구는 transit kiosk와 같은 도메인 특화 runtime 환경에서 초거대 모델이 아닌 효율적인 소형 PEFT 모델이 최상의 운영적 성과를 낼 수 있음을 보여준다. 이 결과는 학계와 산업계 모두에 모델 최적화와 비용 효율적인 AI 배포 전략에 대한 중요한 시사점을 제공한다. 향후 transit과 같이 엄격한 규칙 준수가 필요한 분야에서 폐쇄형 API 모델을 대체할 오픈 weight 기반의 특화 모델 생태계가 더욱 확산될 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] WearableQA: A Benchmark for Health Reasoning over Real-World Wearable Data
- [논문리뷰] StochBench: A Domain-Specific Benchmark for Stochastic Processes in Lean
- [논문리뷰] SchemeArena: Factorized Stress Testing of Scheming in LLM Agents
- [논문리뷰] SAEScientist-Bench: Can AI Agents Conduct Autonomous SAE Interpretability Research?
- [논문리뷰] Φ-Bench: Can Large Language Models Engineer the Infrastructure That Powers Them?
Review 의 다른글
- 이전글 [논문리뷰] Memory as Plans: World-Action Modeling with Memory-Grounded Planning
- 현재글 : [논문리뷰] MetroLLM-Bench: Evaluating Language Models as Transit Kiosk Runtimes
- 다음글 [논문리뷰] Mi-Ripple: Restoring Images Degraded by Iterative AI Editing
댓글