[논문리뷰] Memory as Plans: World-Action Modeling with Memory-Grounded Planning
링크: 논문 PDF로 바로 열기
저자: Sizhe Zhao, Haozhe Xie, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- MaP-WAM (Memory-as-Plans World-Action Modeling): 기억 의존적인
world-action modeling을memory-grounded planning과plan-conditioned execution으로 분해하여, 장기multimodal episodic context를planning-time evidence로 활용하는 프레임워크. - Memory-Grounded Planning: 장기
multimodal episodic context를segment-level language plan및 해당visual guidance를 포함하는compact plan으로 변환하는 과정. - Plan-Conditioned Execution:
World-Action-Progress (WAP)모델이action chunks와execution progress를 동시에 예측하여memory-grounded plan을 실행하며,executor context length가 고정된 상태를 유지하는 과정. - World-Action-Progress (WAP) Model:
future visual dynamics,action chunks, 그리고execution progress를 함께 모델링하여adaptive segment transitions및closed-loop context updates를 가능하게 하는 모델. - Multimodal Episodic Context: 완료된
segment records(언어 명령 및sparse visual context포함)로 구성된 구조화된 메모리로,planning을 위한historical evidence로 사용된다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 복잡한 real-world robotic manipulation tasks가 본질적으로 non-Markovian하며, 현재 observation을 넘어선 long-horizon memory를 요구한다는 문제에 직면한다. 기존 Markovian formulation에 기반한 로봇 policy들은 미래 의사결정에 필요한 정보가 현재 시야에 없는 memory-dependent, partially observable tasks에 부적합하다. 기존의 memory mechanism은 language summaries 또는 growing visual windows에 의존하는데, 전자는 fine-grained visual evidence를 손실할 수 있고, 후자는 history coverage와 execution efficiency 사이의 trade-off에 직면하여 inference latency와 GPU memory consumption이 증가하는 한계를 갖는다 [Figure 1, cite: 1]. 이러한 기존 연구들의 한계점은 fine-grained visual grounding을 유지하면서 long-horizon memory를 효율적으로 처리하고, inference latency가 증가하지 않는 새로운 접근 방식의 필요성을 제기한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 memory-dependent robotic manipulation을 위한 Memory-as-Plans 프레임워크인 MaP-WAM을 제안한다. 이 프레임워크는 장기 multimodal episodic context를 memory-grounded plan으로 변환하여, 고정된 executor context length로 fine-grained visual grounding을 유지하면서 plan-conditioned execution을 가능하게 한다. MaP-WAM은 long-term multimodal episodic context에서 다음 segment-level language plan을 예측하는 language planner와 long-term visual context로부터 visual guidance를 생성하는 Causal World Model (CWM)을 포함하는 memory-grounded planning 모듈을 사용한다 [Figure 2, cite: 1]. 제안하는 World-Action-Progress (WAP) 모델은 Mixture-of-Transformers (MoT) 아키텍처를 활용하여 future visual dynamics, action chunks, 그리고 execution progress를 함께 모델링한다. 이 progress 예측은 가변적인 duration으로 각 plan을 실행하고 segment completion 시 replan을 가능하게 한다. 특히, plan-observation alignment 메커니즘은 현재 observation과 planned visual trajectory를 일치시켜 predicted progress를 calibrate하며, 이를 통해 cumulative drift를 완화하고 adaptive segment transitions를 가능하게 한다 [Figure 2, cite: 1].
MaP-WAM은 시뮬레이션 환경인 RMBench에서 83.3%의 성공률을 달성하여 기존 baselines를 능가한다 [Table 1, cite: 1]. 특히, Memory Complexity M(n)이 요구되는 'Press Button' 태스크에서 96%의 성공률을 기록했으며, fine-grained visual evidence가 중요한 'Observe and Pick Up' 태스크에서도 19%로 성능을 크게 향상시켰다 [Table 1, cite: 1]. 실제 로봇 태스크에서도 MaP-WAM은 78.0%의 성공률을 보였으며 [Figure 3, cite: 1], task history가 증가하더라도 executor inference latency를 거의 일정하게 유지하는 효율성을 입증했다 [Figure 5, cite: 1].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 memory-dependent robotic manipulation을 위한 Memory-as-Plans 프레임워크인 MaP-WAM을 성공적으로 제시한다. MaP-WAM은 structured episodic context를 memory-grounded plans로 변환하고 progress-aware execution과 결합하여 planning, execution, 그리고 context updates 간의 closed-loop를 형성한다. 이는 장기적인 fine-grained visual evidence에 대한 planning-time access를 유지하면서 고정된 executor context로 효율적인 KV-cached inference를 가능하게 한다. 이 연구는 long-horizon memory-dependent tasks에서 로봇의 성능을 향상시키고, task history가 증가해도 일정한 per-chunk executor latency를 유지하는 효율적인 robotic policy 설계를 위한 새로운 방향을 제시한다. 향후 연구로는 unsegmented demonstrations에서 automatic segment discovery를 통해 planning을 확장하고, learned similarity measures를 활용하여 plan-observation alignment의 calibration robustness를 더욱 개선하는 것이 제안된다.
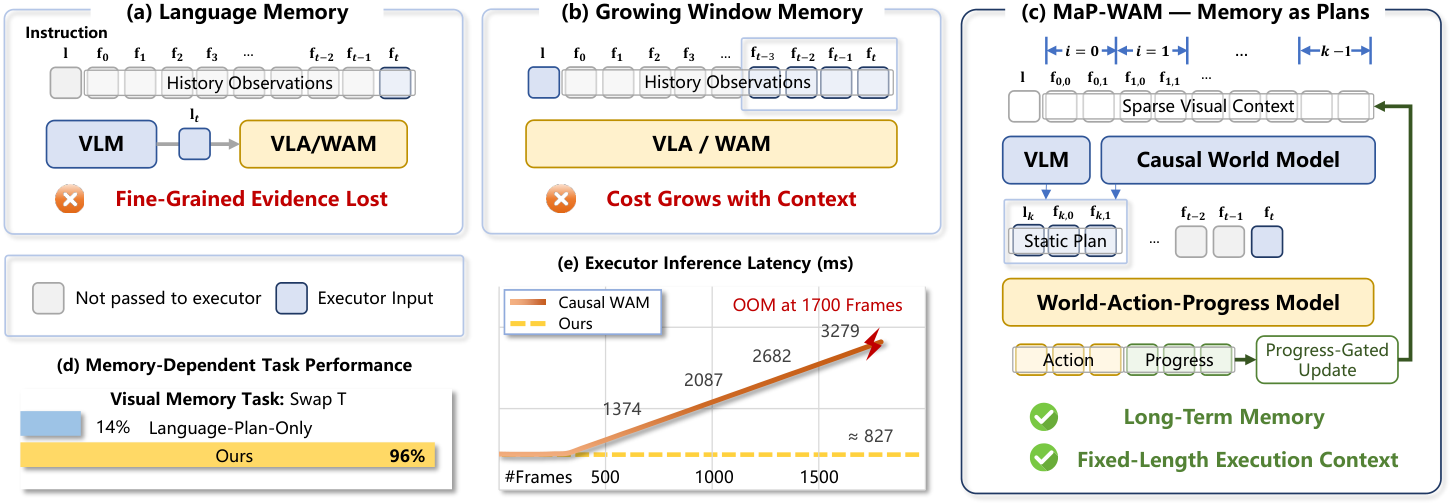
Figure 1 — 제안 모델의 개요 및 기존 방식 비교
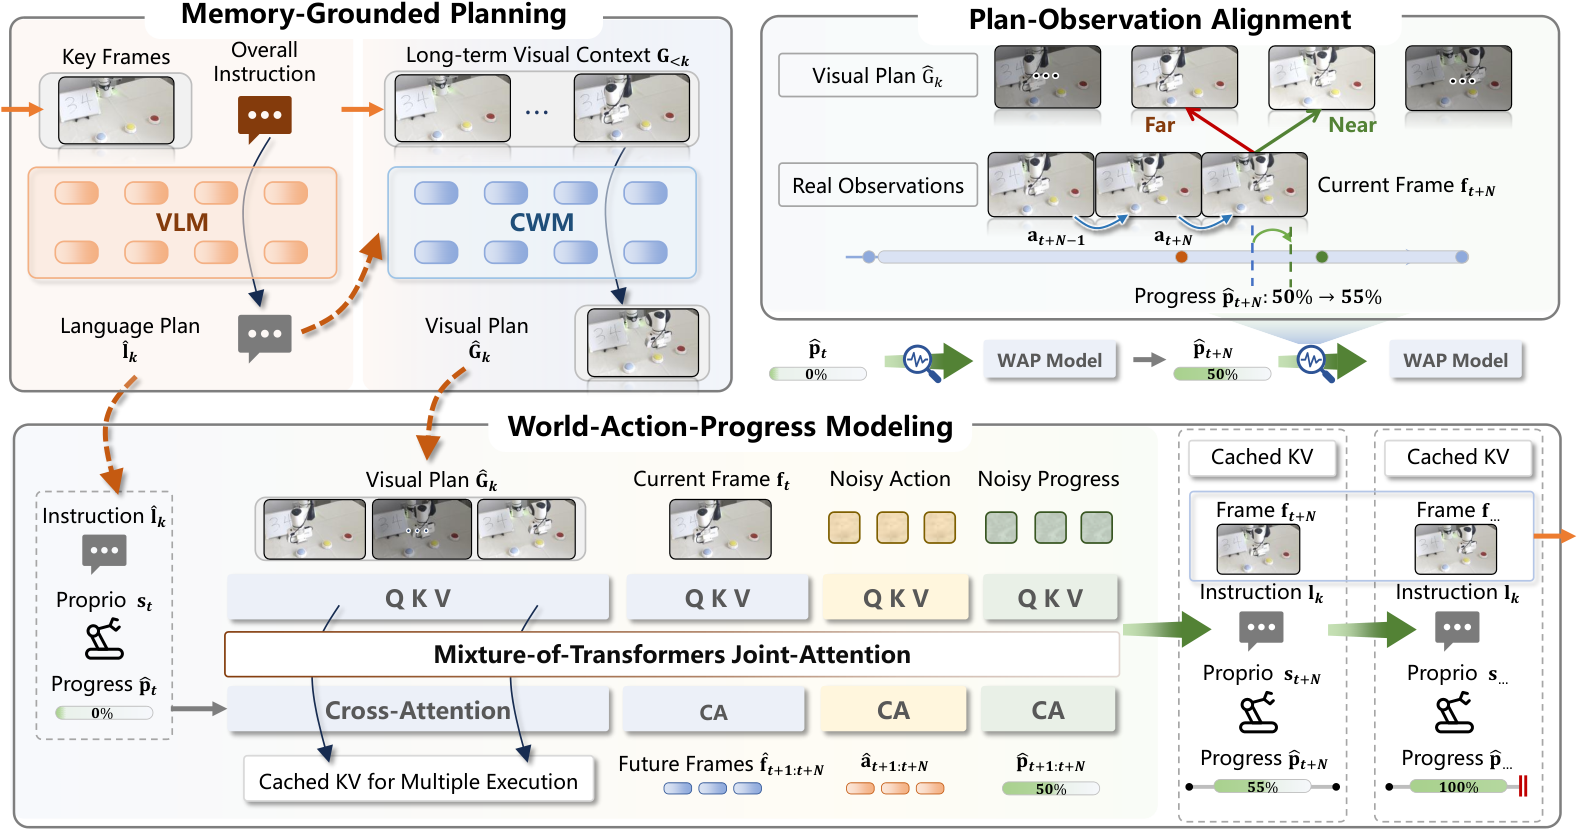
Figure 2 — MaP-WAM의 전체 프레임워크
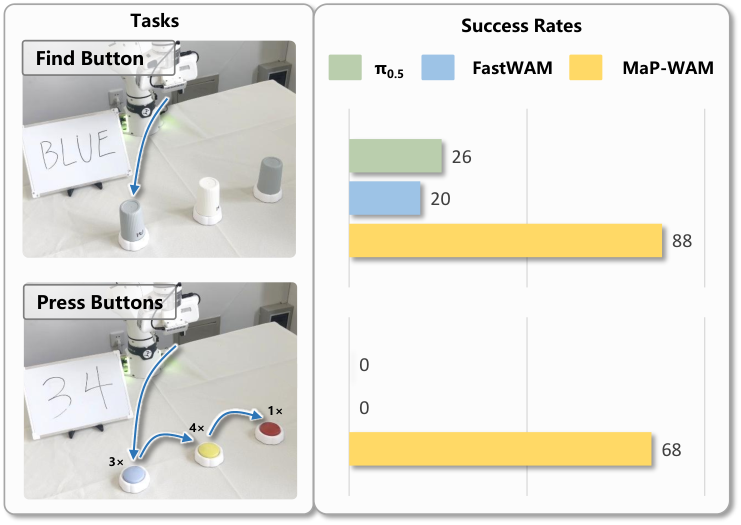
Figure 3 — 실제 로봇 태스크 성공률
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Latent Action as Intention Enables Efficient Future Imagination for World Action Models
- [논문리뷰] DreamX-Phi 1.0: Action-Conditioned Video World Model for Robotic Manipulation
- [논문리뷰] Fast-ThinkAct: Efficient Vision-Language-Action Reasoning via Verbalizable Latent Planning
- [논문리뷰] Why Is Video Still So Expensive? A Survey of Inference-Efficiency Mechanisms in Video and Audiovisual LLMs
- [논문리뷰] SyncWorld: Visual Calibration Enables World Models as Zero-Shot Simulators
Review 의 다른글
- 이전글 [논문리뷰] IdeaAMBIG: Benchmarking Implementation-Critical Gaps in Research-Idea Specifications
- 현재글 : [논문리뷰] Memory as Plans: World-Action Modeling with Memory-Grounded Planning
- 다음글 [논문리뷰] MetroLLM-Bench: Evaluating Language Models as Transit Kiosk Runtimes
댓글