[논문리뷰] Benchmark Radar: A Living Database and Search Engine for AI Benchmarks and Evaluation
링크: 논문 PDF로 바로 열기
저자: Koutian Wu, Junjie Zhou, Ergan Shang, Jiayu Wang, Pengqian Han, Junkai Wang, Wanghan Xu
1. Key Terms & Definitions (핵심 용어 및 정의)
- Benchmark Radar: AI Benchmarks 및 Evaluation을 위한
Living Database이자Search Engine으로, Benchmark 관련 Artifact를 통합적으로 검색하고 발견할 수 있는 시스템이다. - Living Database: 매일 새로운 Benchmark Paper, Repository, Dataset, Release 등의 정보를 자동으로 수집하고 Catalog에 업데이트하여 항상 최신 상태를 유지하는 데이터베이스를 의미한다.
- Score Histories: 특정 Benchmark에 대한 Model들의 Reported Score 기록을 포함하며, 관련
Evaluation Settings및Source정보를 함께 제공하여 Score 비교의 맥락을 이해할 수 있도록 돕는다. - Benchmark Saturation: Benchmark의 성능 향상이 실제 모델의
Capability Gains보다는Benchmark Age나Data Contamination과 같은 요인에 의해 좌우되는 현상을 지칭하며, 이는 Benchmark의 유효성에 대한 비판적 평가를 요구한다. - Source Record: Benchmark Radar 시스템 내에서 하나의 Contributing Source로부터 수집된 개별 Benchmark Entry를 의미하며, Scores 유무와 관계없이 고유한 정보를 보존한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
AI 연구원 및 Large Language Models (LLMs) 개발자들은 관련 Evaluation을 찾아내고, Benchmark Dataset 및 Code를 확보하며, Reported Score 뒤에 숨겨진 Evaluation Settings를 이해하는 데 상당한 어려움을 겪고 있다. 현재 LLM Evaluation과 AI System의 비교는 MMLU, GPQA, Humanity's Last Exam 등 다양한 Benchmark에 의존하고 있으나, 이러한 Benchmark Artifact를 찾는 과정은 Paper Server, Code Hosting Site, Dataset Hub, Vendor Release, Blog 등 여러 분산된 Source를 검색해야 하는 비효율성을 수반한다. 기존의 LLM Stats, OpenCompass, Artificial Analysis와 같은 Platform들이 Leaderboard나 Evaluation Platform을 제공하지만, 새롭게 출시되는 Benchmark와 그 Task Materials, 그리고 이후 Model Report에서의 활용을 연결하는 데는 여전히 여러 독립적인 리소스들을 참조해야 하는 Gap이 존재한다. 이러한 Fragmentation은 AI Model Capability에 대한 포괄적인 이해와 효과적인 비교를 방해하는 핵심 문제로 지적된다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 AI Benchmark 검색 및 발견을 위한 Living Database이자 Search Engine인 Benchmark Radar를 제안한다 [cite: 1, Figure 1]. 제안 시스템은 Daily Discovery 방식을 통해 37개의 Diverse Sources(13개의 Direct Connectors와 24개의 First-Party Research and Engineering Feeds)에서 Benchmark Paper, Repository, Dataset, Release 정보를 수집한다. 이 정보들은 검색 가능한 Benchmark Catalog에 통합되며, Model Card 및 Technical Report에서의 Mention, 그리고 Score Histories를 포함한다 [cite: 1, Figure 2].
Benchmark Radar의 Catalog는 LLM Stats, OpenCompass Hub, Artificial Analysis, Model Reports의 4가지 주요 소스에서 수집된 총 1,283개의 Source Records를 포함하며, 각각의 Source Label을 유지한다 [cite: 1, Table 1]. 특히, Catalog에는 790개의 Records에서 총 12,916개의 Numeric Score Observations가 기록되어 있으며, 이 중 493개의 Records는 Score 없이 Artifact Links만 제공한다 [cite: 1, Table 3]. 개별 Source별로는 Artificial Analysis가 7,050개의 Score Observations로 가장 많은 기여를 했고, LLM Stats는 5,544개의 Score Observations를 제공한다 [cite: 1, Table 3].
Candidate Retrieval에는 Field-weighted Word-matching Score를 사용하는 BM25F Lexical Search 알고리즘이 적용되어 Source Membership과 관계없이 Ranking을 제공한다. Full Catalog Census 결과, 전체 790개의 Scored Records 중 Percentage Unit 및 Known Score Direction이 명확히 선언되고 값이 0~100 범위 내에 있는 Record는 단 82개에 불과하며, 나머지 708개는 Other 또는 Unverified Scales를 사용한다 [cite: 1, Table 6]. 또한, Benchmark Release Date가 기록된 Record는 615개이며, 668개의 Records는 Release Date 정보가 없다 [cite: 1, Table 9]. 이는 Score Comparisons 시 Evaluation Settings 및 Date Evidence에 대한 엄격한 확인이 필수적임을 시사한다 [cite: 1, Figure 3, Figure 4].
4. Conclusion & Impact (결론 및 시사점)
Benchmark Radar는 AI Benchmark의 Daily Discovery, Catalog Search, Model-Report Mentions, 그리고 Score Histories를 단일 Living Search Engine으로 통합하는 데 성공했다. 이 시스템을 통해 연구자들은 Candidate Evaluations를 효과적으로 찾아내고, Task Materials를 쉽게 확보하며, Score를 뒷받침하는 Reporting Choices와 Citations를 면밀히 검토할 수 있게 되었다. 이러한 접근 방식은 AI Benchmark 생태계의 Transparency와 Reproducibility를 크게 향상시키며, AI Model Capabilities에 대한 보다 정확하고 Contextual한 이해를 가능하게 할 것으로 기대된다. 특히, Unscored Records에 대해서도 Artifact Links를 보존하고 Command-Line Interface (CLI)를 통한 Offline Query 기능을 제공함으로써, Prior-Art Search와 같은 실제 연구 Workflow에 직접적인 도움을 제공하며, Benchmark Saturation 및 Adoption Trends와 같은 Evaluation 동향 분석에도 중요한 기여를 한다.
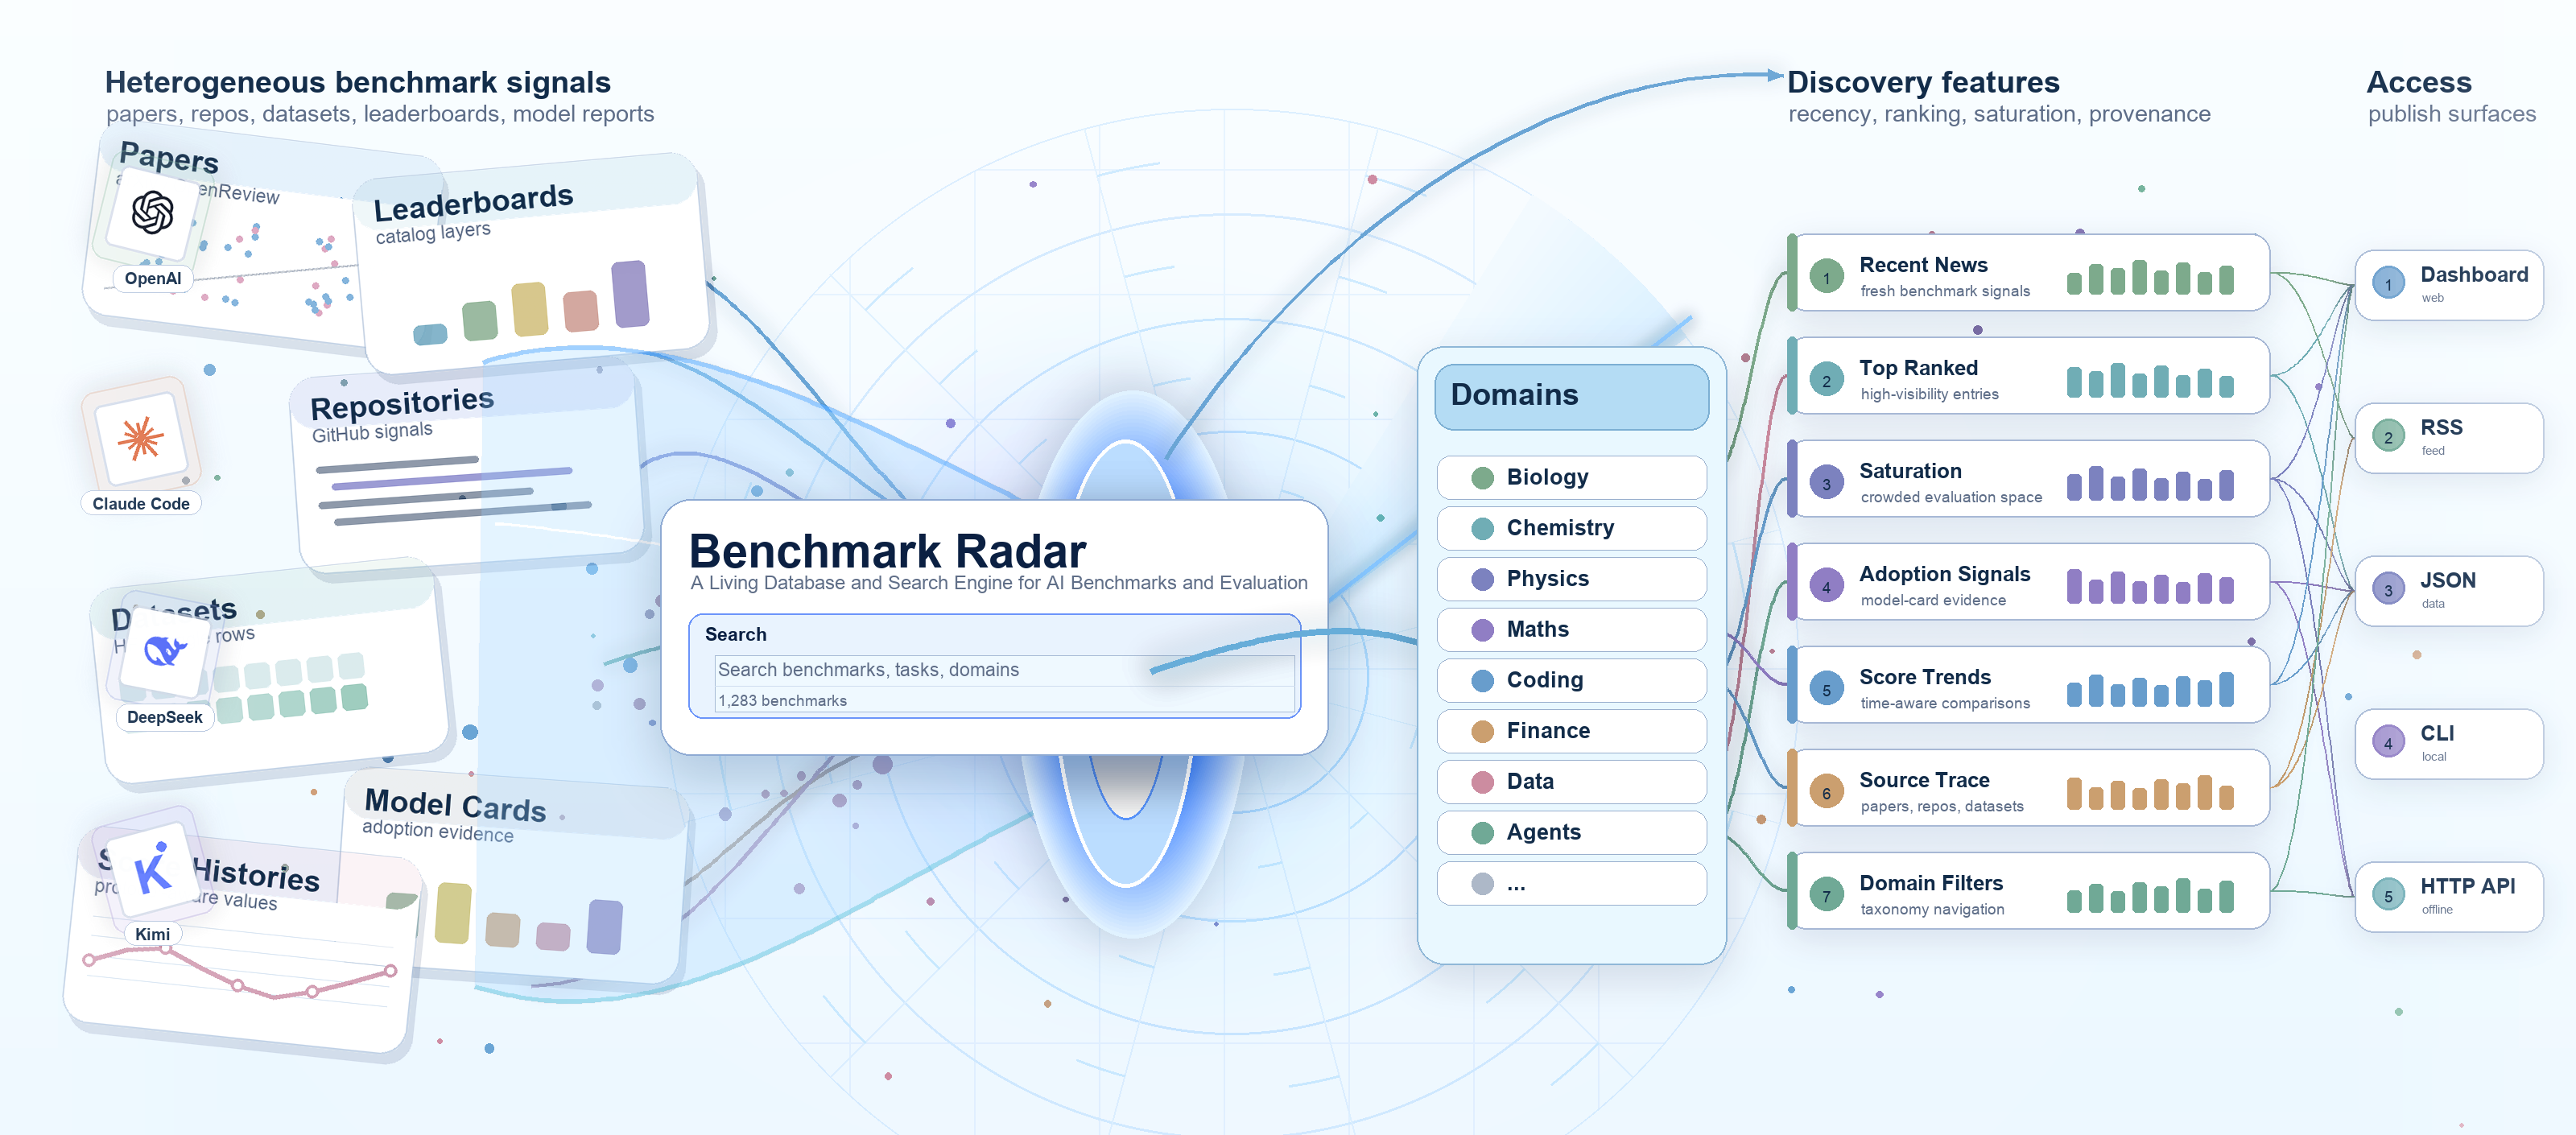
Figure 1 — Benchmark Radar 시스템 개요
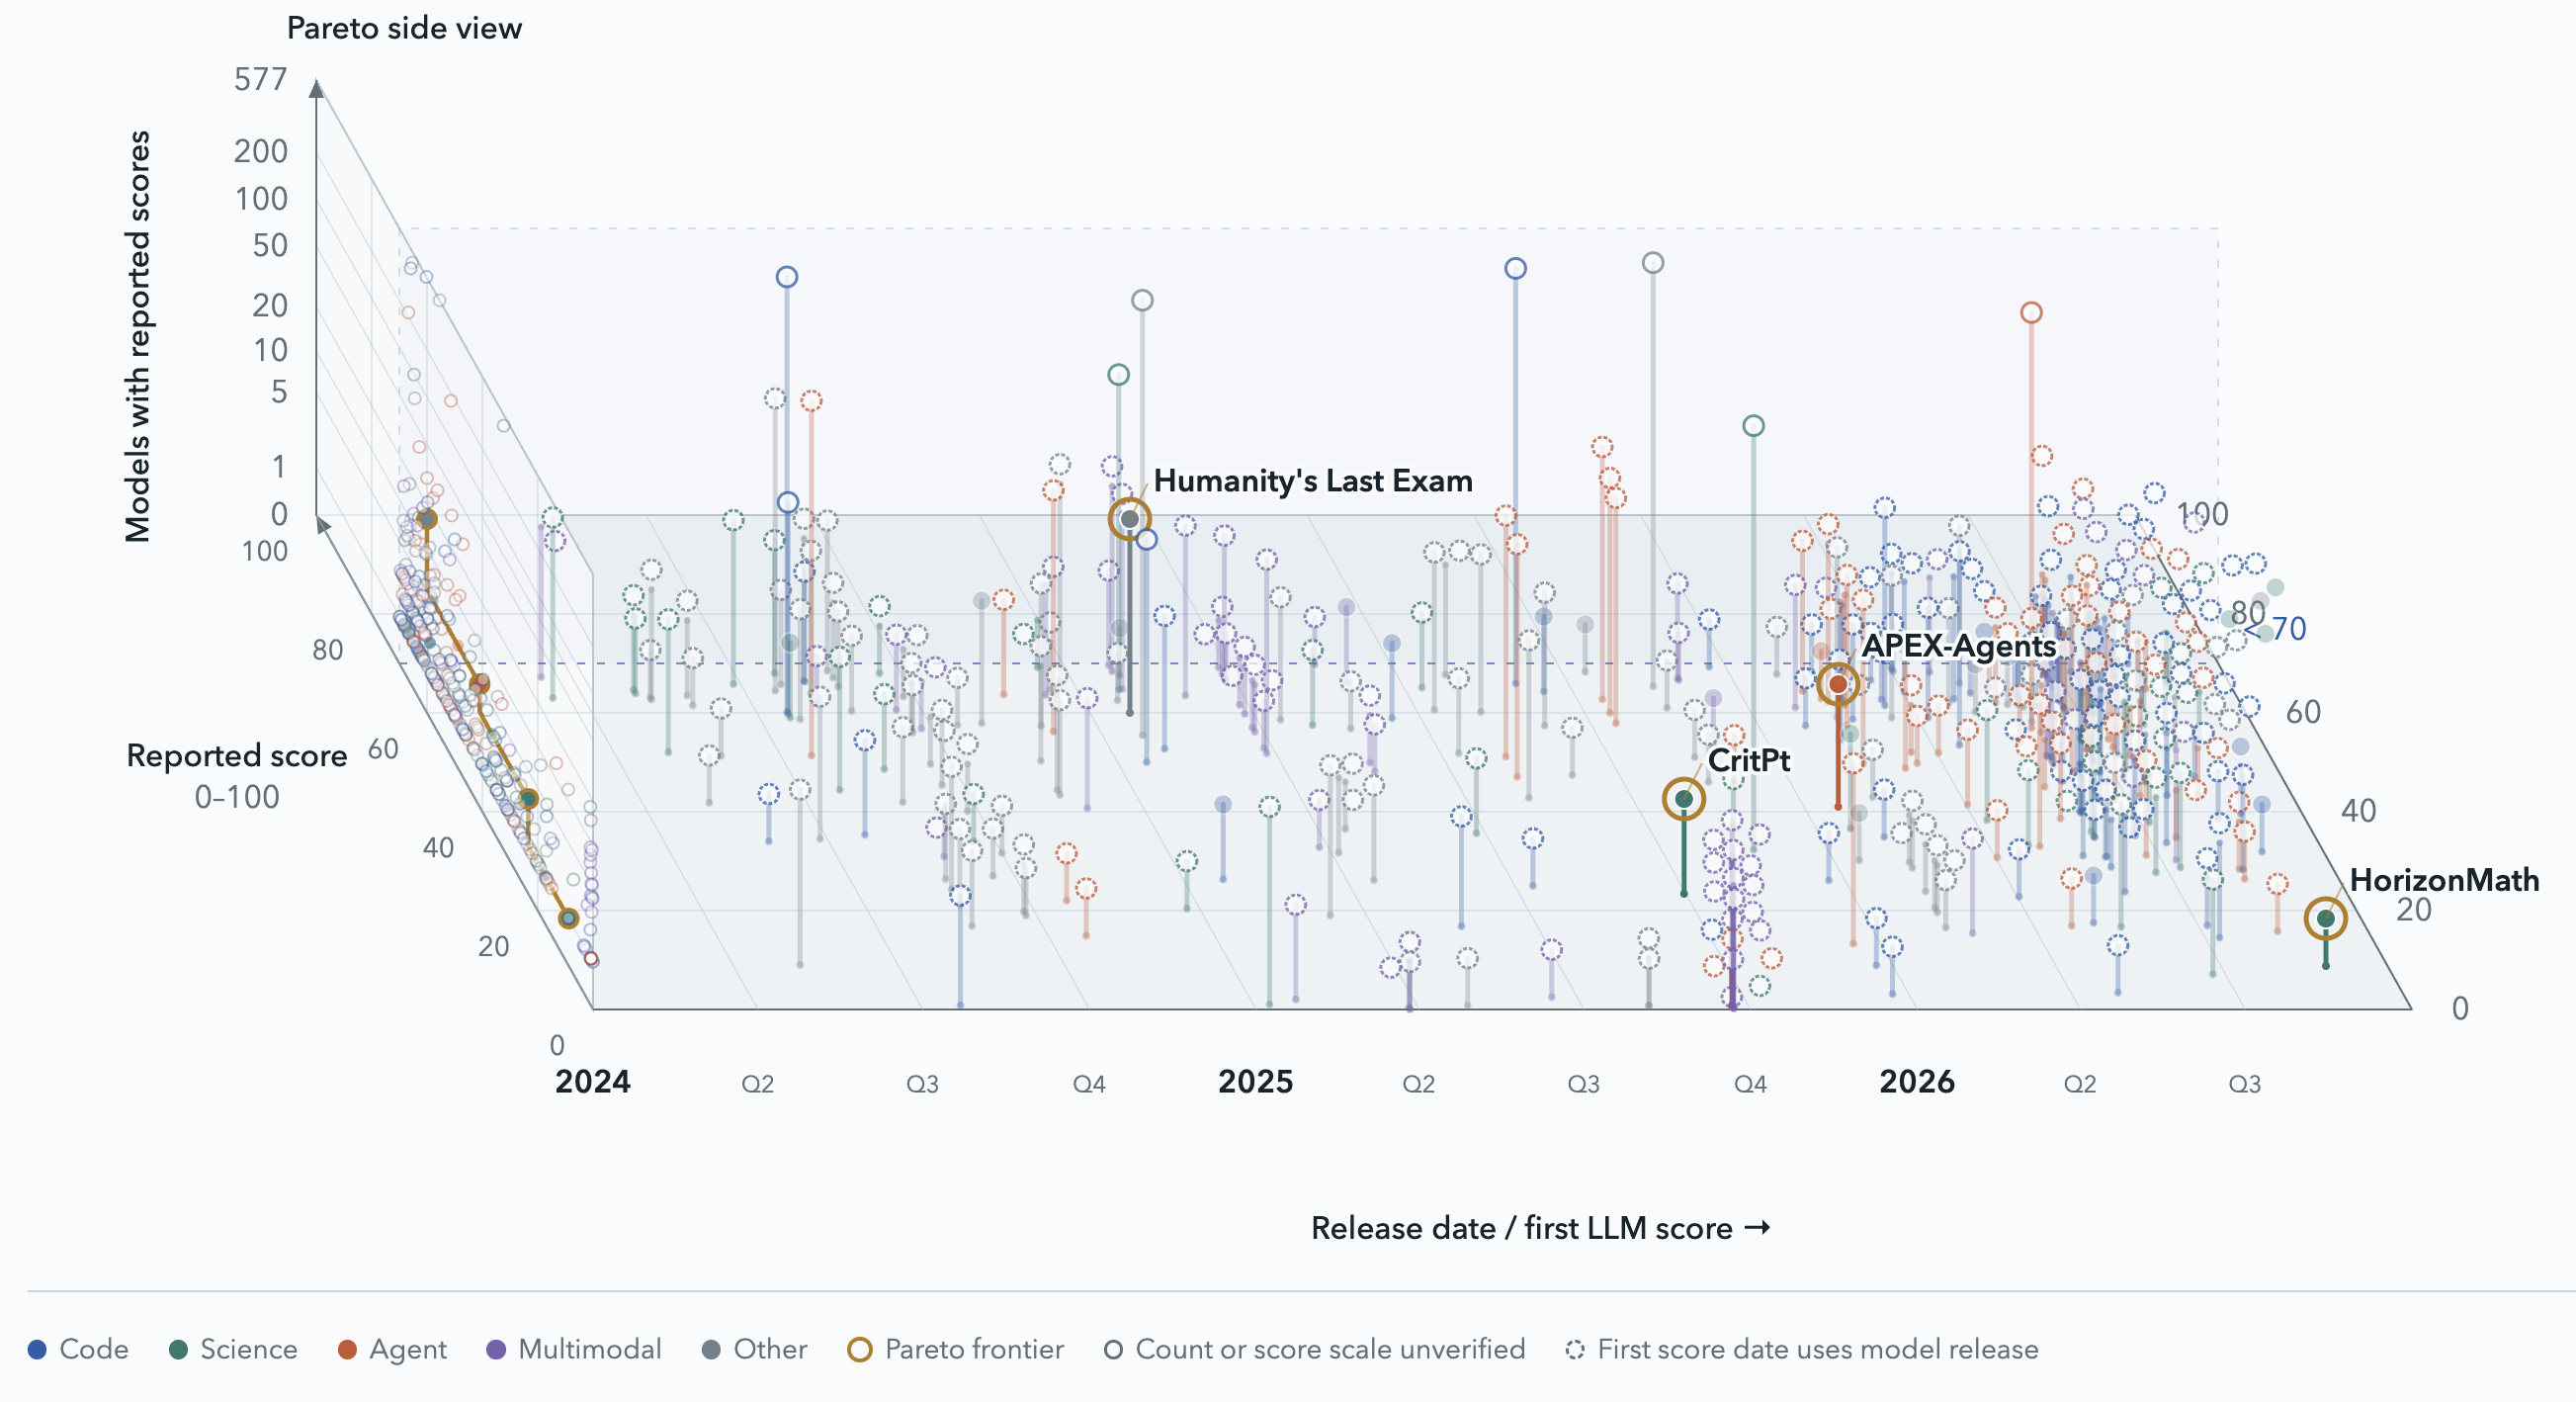
Figure 3 — 리더보드 페이지의 Benchmark Frontier
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RESCUE-BENCH: Towards Relation-Aware Multi-Party Emotional Support Conversation Systems
- [논문리뷰] Learning to Evaluate Before Improving: Automatic Rubric Induction for Automatic Research Agents
- [논문리뷰] Same Agent, Different Answers: A Repeat-Aware Audit of Corpus-Induced Answer Churn in Retrieval-Augmented QA
- [논문리뷰] Zero Gap Is Not Restoration: Stratified Per-Question Probability Evaluation and Step-wise Mitigation of Benchmark Contamination
- [논문리뷰] Measuring Epistemic Resilience of LLMs Under Misleading Medical Context
Review 의 다른글
- 이전글 [논문리뷰] Ambient @ EgoProactive 2026 : Proactive Egocentric Assistance with Visually Grounded Supervision
- 현재글 : [논문리뷰] Benchmark Radar: A Living Database and Search Engine for AI Benchmarks and Evaluation
- 다음글 [논문리뷰] Beyond Top-k Skill Retrieval: Diversity-Aware Skill Routing for LLM Agents
댓글