[논문리뷰] How Far Can Synthetic Data Take Thai OCR?
링크: 논문 PDF로 바로 열기
Part 1: 요약 본문
저자: Kunat Pipatanakul
1. Key Terms & Definitions (핵심 용어 및 정의)
- OCR (Optical Character Recognition): 문서 이미지를 기계 판독 가능한 텍스트로 변환하는 기술로, 문서 디지털화, 검색, 그리고 검색 증강 생성(Retrieval-Augmented Generation)에 활용됩니다.
- Synthetic Data: 실제 문서의 OCR 레이블 없이 인공적으로 생성된 데이터로, 실제 문서 이미지를 재구성하여 생성됩니다. 이 논문에서는 이를 통해 Thai OCR 모델을 학습합니다.
- Character Error Rate (CER): OCR 시스템의 성능을 측정하는 지표로, 예측된 텍스트와 실제 텍스트 간의 편집 거리(Edit Distance)를 참조 문자 수로 나눈 값입니다. 낮을수록 더 나은 성능을 의미합니다.
- Page-level training: 모델이 완전한 문서 이미지를 입력으로 받아 단일 추론(inference) 패스에서 전체 페이지 및 해당 영역을 예측하도록 학습하는 방식입니다.
- Crop-level training: 레이아웃 감지기(layout detector)에 의해 생성된 개별 영역(region)을 인식하도록 모델을 학습하는 방식입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Synthetic Data가 Thai OCR의 성능을 어디까지 향상시킬 수 있는지 탐구합니다. OCR은 문서 이미지를 기계 판독 가능한 텍스트로 변환하는 핵심 기술이지만, Thai어와 같이 리소스가 부족한 언어는 풍부한 문서에도 불구하고 신뢰할 수 있는 OCR label이 부족한 문제가 있습니다. 기존 Open models 및 datasets은 주로 English와 Chinese에 집중되어 있어, Thai어의 고유한 문자 체계로 인해 다른 언어로부터의 직접적인 transfer가 어렵습니다. 수동 labeling은 비용이 많이 들고, PDF 텍스트 추출이나 OCR pseudo-labels은 문자 누락, 순서 변경, 읽기 순서 손상 등의 문제를 야기할 수 있습니다. Typhoon OCR과 같은 최신 Thai OCR 모델은 synthetic data를 활용하여 SOTA 성능을 달성했지만, synthetic supervision의 기여도나 transfer를 지원하는 문서 속성을 명확히 분리하여 연구하지는 않았습니다. 따라서 본 연구는 이러한 한계를 극복하고, synthetic data만으로 실제 Thai 문서에 대한 OCR 성능을 어디까지 끌어올릴 수 있는지 체계적으로 분석합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 기존 문서를 in-place로 재구성하는 controllable document-reconstruction pipeline을 제안합니다 [Figure 1]. 이 pipeline은 source domain, 비텍스트 컨텍스트, typeface diversity, 2차원 layout, 그리고 handwriting glyph source를 독립적으로 제어할 수 있습니다. Qwen3-VL-2B-Instruct 모델을 사용하여 page-level 및 crop-level training 환경에서 다양한 synthetic data의 transfer 효과를 비교했습니다.
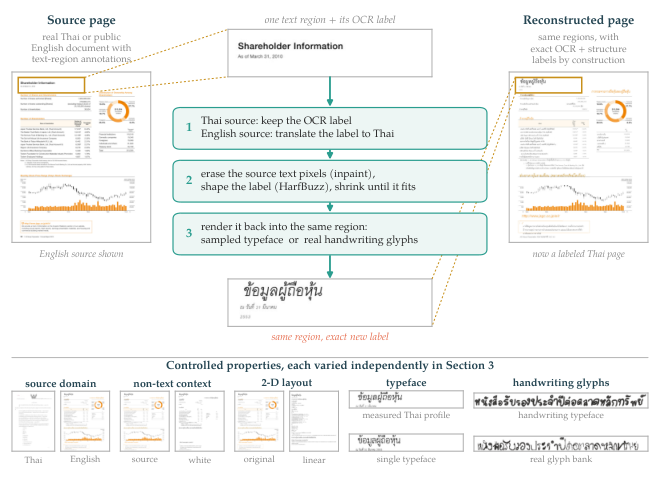
Figure 1 — 문서 재구성 파이프라인 개요
실험 결과, 비텍스트 컨텍스트(non-text context)는 인식에 일관된 영향을 미치지 않았지만, typeface diversity, 2차원 spatial structure, 그리고 실제 handwriting glyphs가 transfer 성능을 향상시키는 데 기여했습니다. 특히, typeface diversity가 제거될 경우 handwriting 인식에서 median CER이 page-level training에서 6.70 및 9.48 포인트, crop-level training에서 11.36 및 13.37 포인트 증가하는 것을 확인했습니다. 또한, source-domain matching은 training granularity에 따라 다르게 작용했습니다: page-level training에서 In-Domain Reconstruction은 실제 인쇄된 supervision에 근접하는 1.82% median Character Error Rate를 달성하여 Out-of-Domain Reconstruction의 5.07%보다 우수했지만, crop-level training에서는 In-Domain Reconstruction이 15.59%로 Out-of-Domain Reconstruction의 5.52%보다 성능이 저조했습니다.
이러한 controlled studies를 기반으로, 저자들은 Wayu-Paxa-OCR-Zero를 개발했습니다. 이 모델은 PaddleOCR-VL-1.6을 base checkpoint로 하며, 45,723개의 synthetic pages로만 학습되었습니다. Wayu-Paxa-OCR-Zero는 base checkpoint 대비 인쇄된 페이지에서 median CER을 6.64%에서 1.24%로, handwriting에서 74.87%에서 20.55%로 크게 줄였습니다 [Table 7]. 또한, 7B Typhoon OCR v1 모델을 모든 five evaluation sets에서 능가하며, synthetic-only training이 경쟁력 있는 성능을 달성할 수 있음을 입증했습니다 [Table 7].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 synthetic reconstruction을 통해 실제 Thai 문서의 page-level OCR labels 없이도 경쟁력 있는 Thai OCR 시스템을 구축할 수 있음을 보여줍니다. Typeface diversity, 2차원 spatial structure, 그리고 실제 handwriting glyphs의 활용이 synthetic-to-real transfer 성능을 향상시키는 핵심 요소임을 규명했습니다. 그러나 synthetic supervision은 여전히 심각한 오류(severe failures)와 handwriting 인식에서 실제 supervision에 비해 격차가 존재하며, in-domain reconstruction의 가치는 training granularity에 따라 달라진다는 한계를 명시했습니다. 이 연구는 리소스가 부족한 언어의 OCR 분야에서 synthetic data의 잠재력을 입증하며, 향후 document layouts, typography, 그리고 handwriting variation에 대한 광범위한 coverage를 통해 generalization을 개선할 수 있는 중요한 연구 방향을 제시합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] MM-Zero: Self-Evolving Multi-Model Vision Language Models From Zero Data
- [논문리뷰] Training Object Permanence in World Models
- [논문리뷰] All-in-One Multilingual Scene Text Recognition with Script-aware Mixture-of-Experts
- [논문리뷰] GameHorizon Suite: Multi-Horizon Data and Evaluation in Gameplay
- [논문리뷰] PANORAMA: Panoptic Grounded Captioning via Mask Proposal Selection
Review 의 다른글
- 이전글 [논문리뷰] Feyospace-v1: How the Cyber Mercury Seven Trained Frontier Cyber Models
- 현재글 : [논문리뷰] How Far Can Synthetic Data Take Thai OCR?
- 다음글 [논문리뷰] Online Learning with LLM Experts from Limited Feedback
댓글