[논문리뷰] Online Learning with LLM Experts from Limited Feedback
링크: 논문 PDF로 바로 열기
저자: Wang Wei, Soumyabrata Pal, Koyel Mukherjee, Franck Dernoncourt, Ryan A. Rossi, Branislav Kveton, Hoda Eldardiry
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 다루는 핵심 용어 및 개념은 다음과 같습니다:
- LLM Experts: 다양한 기능과 비용을 가진 Large Language Model들을 지칭합니다. 이들은 특정 프롬프트에 대해 상이한 응답 품질을 제공합니다.
- Limited Feedback: LLM 응답에 대한 평가(예: 인간 피드백 또는 LLM Judge)가 비용이 많이 들기 때문에, 총 T 라운드 중
m << T횟수만큼만 피드백을 얻을 수 있는 제약된 환경을 의미합니다. - Contextual Bandit: 온라인 학습 프레임워크의 일종으로, 에이전트가 프롬프트 임베딩(context)에 기반하여 최적의 LLM Expert(action)를 선택하여 보상(reward)을 최대화하는 것을 목표로 합니다. 본 연구에서는 제한된 보상 관측(limited feedback)이 주요 차이점입니다.
- Full-Information Setting: 에이전트가 피드백을 요청할 때, 과거의 어떤 라운드에 대해서도 모든 LLM Expert들의 보상을 관측할 수 있는 환경입니다.
- Bandit Setting: 에이전트가 피드백을 요청할 때, 과거의 어떤 라운드에 대해서든 해당 라운드에 선택되었던 특정 LLM Expert의 보상만 관측할 수 있는 환경입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
Large Language Models (LLMs)는 다양한 태스크에서 널리 활용되고 있지만, 모델마다 비용과 능력이 상이하며, 특정 모델이 모든 태스크에서 다른 모델을 압도하지 못하는 경우가 많습니다. 이러한 배경에서, 주어진 프롬프트에 가장 적합한 LLM Expert로 동적으로 라우팅하는 것은 응답 품질을 극대화하는 데 필수적입니다. 그러나 LLM 응답 품질에 대한 피드백, 즉 인간 평가 또는 더 강력한 LLM을 통한 평가(LLM Judge)는 시간 및 계산 비용이 매우 높습니다. 이로 인해 실제 온라인 환경에서는 전체 T 라운드 중 극히 제한된 m번의 피드백만 활용할 수 있습니다 (m << T). 기존의 LLM 최적화 접근 방식들은 주로 오프라인 설정에서 연구되거나, 응답 품질을 직접적으로 최적화하지 않는 경향이 있어, 제한된 피드백 상황에서 온라인으로 LLM Expert 라우팅 전략을 학습하는 문제에 대한 해결책이 부족했습니다. 본 연구는 이러한 온라인 환경에서 제한된 피드백 예산 하에 최적의 라우팅 전략을 학습하여 Regret을 최소화하는 것을 목표로 합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 제한된 피드백 환경에서 LLM Expert로 프롬프트를 Adaptive Routing하기 위한 두 가지 온라인 학습 알고리즘인 LimFullFeed와 LimBanFeed를 제안합니다. 이 알고리즘들은 Contextual Bandit 문제로 정식화되며, 피드백을 언제, 어떤 과거 프롬프트에 대해 요청할지를 전략적으로 결정하는 것이 핵심입니다.
LimFullFeed는 Full-Information Setting에서 사용되며, 에이전트는 T/m 라운드마다 주기적으로 피드백을 수집합니다. 피드백 수집 시, 과거 관측되지 않은 프롬프트 중 공분산 행렬(Covariance Matrix)의 determinant를 가장 크게 증가시키는 프롬프트 s_t를 선택하여 모든 LLM Expert의 보상 벡터를 관측합니다. 이를 통해 모든 전문가의 OLS(Ordinary Least Squares) 추정치 θ^t,a를 업데이트합니다. 이 방법은 O~(dT/sqrt(m))의 Regret Bound를 달성합니다.
LimBanFeed는 Bandit Setting을 위해 제안되었으며, 각 Expert는 고유한 통계(공분산 행렬 V_0,a 및 OLS 추정치 θ^0,a)를 가집니다. 알고리즘은 각 라운드에서 Upper Confidence Bound(UCB)에 기반하여 최적의 Expert a_t를 선택합니다 [Figure 1b]. Expert a가 z = T/m번 선택될 때마다, 해당 Expert가 처리했던 과거 프롬프트 중 공분산 행렬의 determinant 증가를 최대화하는 프롬프트를 선택하여 해당 Expert의 보상만을 관측하고 통계를 업데이트합니다. 이 방법은 **O~(dT*sqrt(K/m))**의 Regret Bound를 달성합니다.
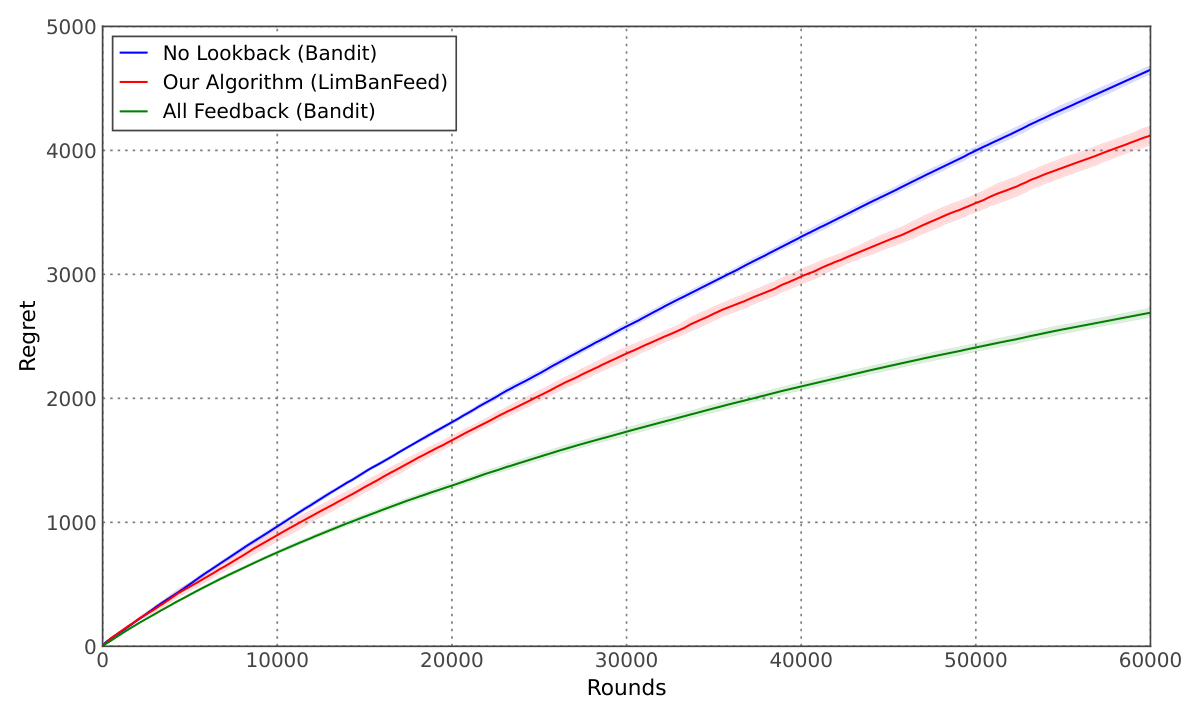
Figure 1b — Bandit Regret 비교
실험 결과, Nectar 및 RouterBench 데이터셋에서 제안하는 LimFullFeed와 LimBanFeed는 모두 NoLookBack 베이스라인 대비 일관되게 낮은 Regret을 보였습니다 [Figure 1a, Figure 1b]. 특히, LimBanFeed는 NoLookBack보다 최대 1000 Regret 이상의 성능 향상을 보이며, 피드백 예산 m이 증가할수록 Regret이 감소하여 이론적 분석과 일치하는 경향을 보였습니다. Full-Information Setting에서의 Regret은 Bandit Setting보다 일관되게 낮게 나타났는데, 이는 Full-Information Setting이 관측당 더 풍부한 피드백을 제공하기 때문입니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 제한된 피드백 환경에서 LLM Expert로의 Adaptive Prompt Routing 문제를 Contextual Bandit 문제로 접근하고, Full-Information Setting을 위한 LimFullFeed와 Bandit Setting을 위한 LimBanFeed 알고리즘을 제안합니다. 이 연구의 핵심은 정보 이득(Information Gain)을 최대화하는 과거 프롬프트에 대한 피드백을 전략적으로 선택함으로써, 제한된 예산 하에서도 효과적으로 학습할 수 있음을 이론적 및 실험적으로 입증한 것입니다. 제안된 방법론들은 기존 베이스라인 대비 Regret을 크게 줄여 Near-Optimal Learning Rate를 달성합니다.
이 연구는 학계 및 산업계에 중요한 시사점을 제공합니다. 실제 LLM 시스템 배포 환경에서는 고비용의 인간 또는 LLM Judge 피드백에 대한 의존도를 낮추면서도, 지속적으로 LLM Expert의 라우팅 성능을 개선할 수 있는 실용적인 방안을 제시합니다. 이는 한정된 자원으로도 고품질의 LLM 서비스 제공을 가능하게 하여, LLM 기반 애플리케이션의 비용 효율성과 성능 최적화에 기여할 것입니다.
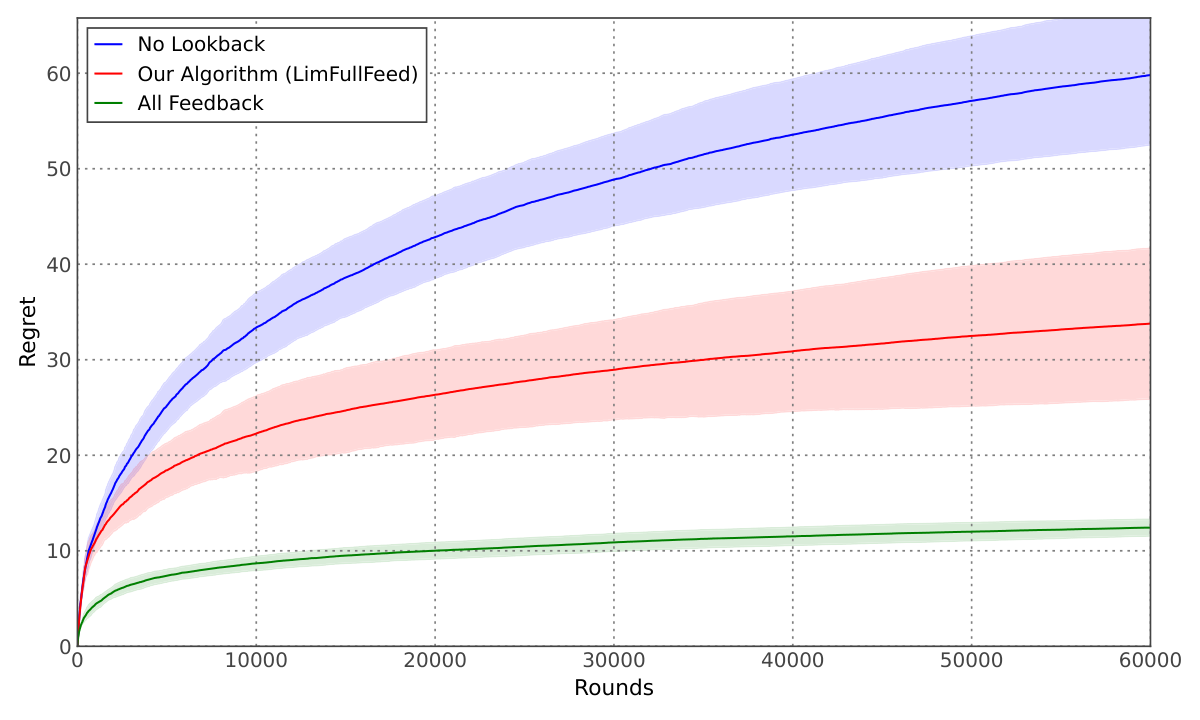
Figure 1a — Full-Information Regret 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] COBRA-Skills: Contextual Bandit-Guided Evolution for Agent Skill Optimization
- [논문리뷰] UniMoMo: Expert Merging-Based MoE Acceleration for Large Recommendation Models
- [논문리뷰] When Classic Cache Policies Fail: Learning-Augmented Replacement for Semantic Retrieval Buffers
- [논문리뷰] Reasoning Arena: Trace Tournaments When Verifiable Rewards Fall Short
- [논문리뷰] CASCADE: Case-Based Continual Adaptation for Large Language Models During Deployment
Review 의 다른글
- 이전글 [논문리뷰] How Far Can Synthetic Data Take Thai OCR?
- 현재글 : [논문리뷰] Online Learning with LLM Experts from Limited Feedback
- 다음글 [논문리뷰] PLC-DPO: Posterior Label Correction in Noisy and Ambiguous Preference Optimization
댓글