[논문리뷰] LynnReal-Omni: Native multi-modal Video Generation for Agentic Visual Workflows
링크: 논문 PDF로 바로 열기
저자: Xiaofeng Mao, Peijia Lin, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- LynnReal-Omni: 본 논문에서 제안하는 Native Multimodal Video Generation Framework로, 다양한 모달리티 입력에 대한 통합된 비디오 생성 및 제어를 목표로 합니다.
- Agentic Visual Creation: 대규모 언어 모델(LLM) 에이전트가 명시적인 레퍼런스 이미지, 편집 가능한 3D 장면 또는 실행 가능한 게임 상태를 생성하여 비디오 생성 프로세스를 안정적으로 제어하는 워크플로우를 의미합니다.
- MSAVP (MultiShot-AV-Physics Bench): LynnReal-Omni 개발 과정에서 도입된 새로운 벤치마크로, 복잡한 Audiovisual 및 Physical Video Generation을 평가하기 위해 Instruction Following, Cross-shot Consistency, Physical Plausibility, Audiovisual Coordination 등 20개 이상의 Metric을 포함합니다.
- Diffusion Transformer (DiT): LynnReal-Omni의 핵심 Generative Model Architecture로, 32B Shared Multimodal Diffusion Transformer를 기반으로 Text, Image, Audio 등 다양한 모달리티를 통합하여 비디오를 생성합니다.
- Lightweight VAE Decoder: 추론 시 Bottleneck이 되는 VAE Decoder의 비용을 절감하기 위해 Original VAE Decoder를 Distillation하여 더 얕고 효율적으로 만든 Decoder입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
현재 Video Diffusion Models는 인상적인 Visual Fidelity를 달성했지만, 그 제어는 여전히 어렵습니다. 생성 과정이 Stochastic하여 정확한 콘텐츠를 얻기 위해 반복적인 Sampling이 필요하며, Long-horizon Scene에서는 Appearance, Object Interaction 및 Temporal Coherence가 Drift하는 문제가 발생합니다. Agentic Visual Creation은 이러한 제어 문제를 해결하기 위한 유망한 접근 방식이지만, Object나 Character의 High-fidelity Appearance를 보장하지는 못합니다.
기존 연구의 주요 한계점은 다음과 같습니다:
- Fragmented Task-specific Pipelines: Text-to-Video, Image-conditioned Generation, Reference-guided Generation 등 각기 다른 비디오 생성 태스크에 대해 파편화된 파이프라인이 존재하여, 에이전트가 여러 모델과 Ad-hoc 인터페이스를 조합해야 하므로 엔지니어링 비용이 증가하고 태스크 간 일관성이 저해됩니다.
- Long-horizon Inconsistency: Long-video 생성 시 Appearance Drift, Identity Change, Photometric Artifact 등의 문제가 빈번하게 발생하여 Temporal Coherence가 부족합니다.
- Incomplete Evaluation Protocols: 기존 VBench나 VideoPhy와 같은 평가 프로토콜은 비디오 품질의 일부 차원만 다루며, Multi-shot Continuity, Action Binding, Physical Plausibility, Controllability, Audio Quality 등을 종합적으로 커버하지 못합니다.
- Decoding Bottleneck: Few-step Distillation을 통해 Denoising Cost가 감소하면서, VAE Decoder가 Inference Cost의 지배적인 병목 현상(Bottleneck)이 됩니다. 따라서 Decoder 가속화가 필수적입니다. Agentic Visual Creation은 명시적인 레퍼런스, 편집 가능한 3D 장면 또는 실행 가능한 게임 상태를 제공하여 비디오 생성 프로세스를 안정화하지만, High-fidelity Appearance를 보장하지는 못합니다 [Figure 1].
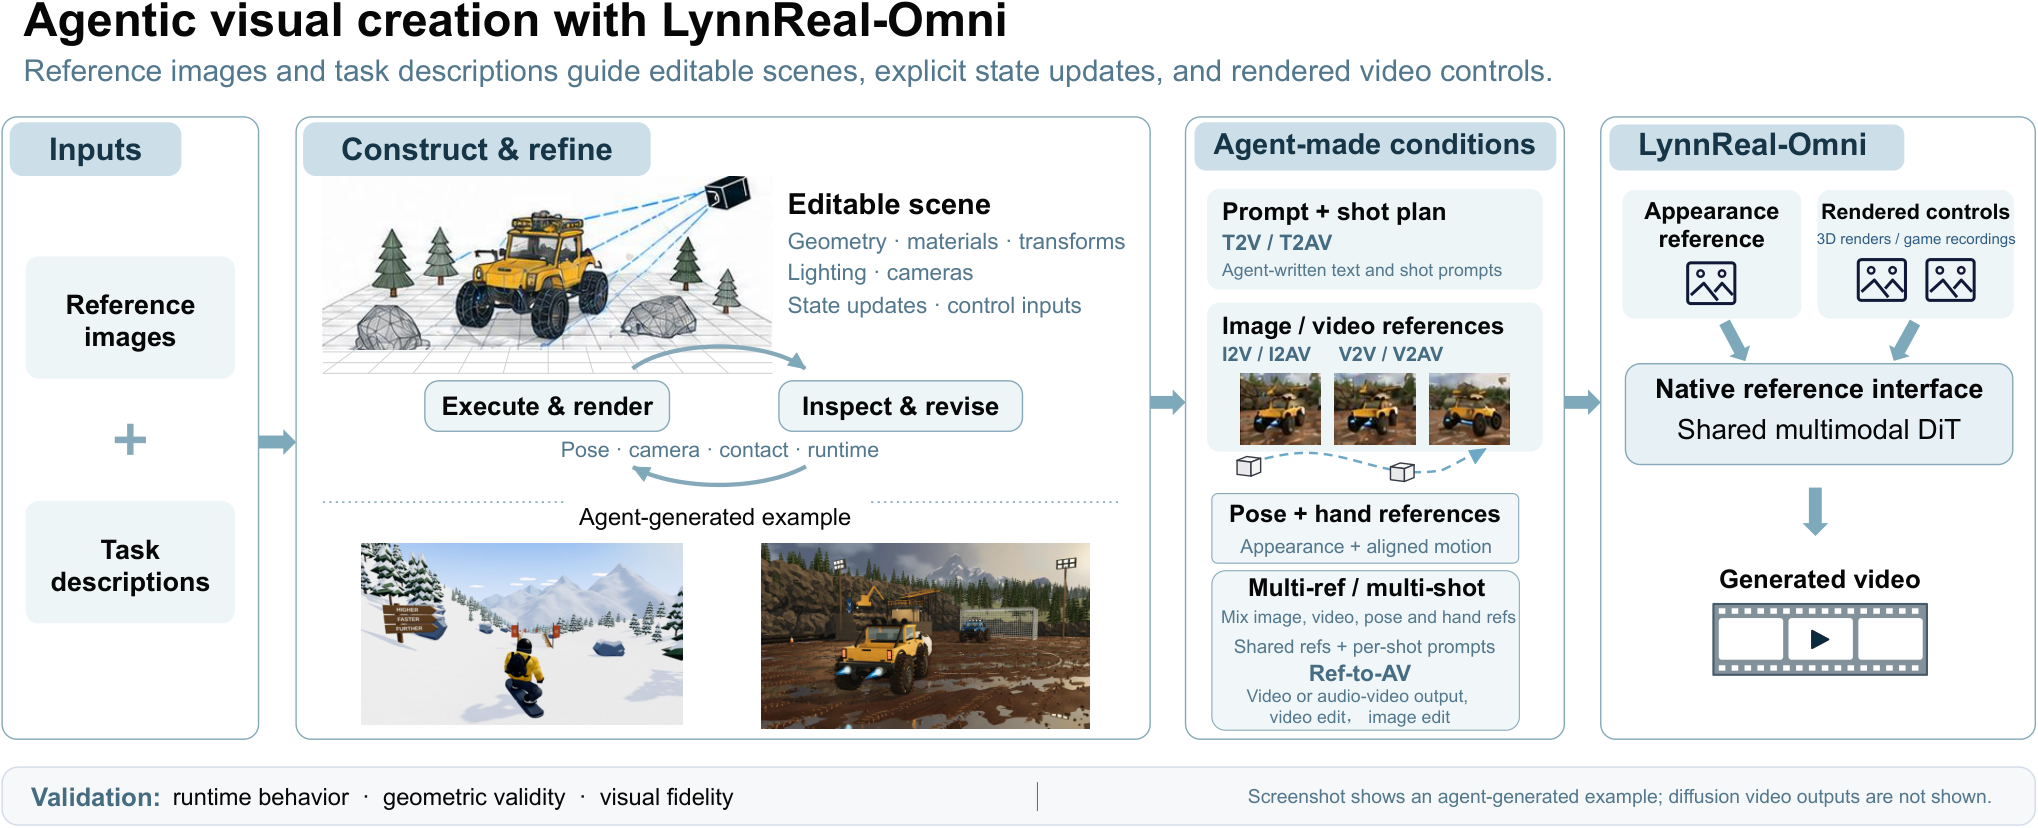
Figure 1 — 에이전트 워크플로우
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 이러한 한계점을 극복하기 위해 LynnReal-Omni를 제안합니다. LynnReal-Omni는 32B Shared Multimodal Diffusion Transformer를 기반으로 Text-to-Video, Image-conditioned Generation, Reference-guided Generation, Structural Control, Editing, Degraded Video Restoration, Long-video Generation을 통합하는 Native Multimodal Video Generation Framework입니다. 또한, 실시간 렌더링을 위한 전용 27B Flash Shared Multimodal Diffusion Transformer를 훈련시켰습니다.
LynnReal-Omni의 핵심 방법론은 다음과 같습니다:
- Unified Framework 및 Native Task Representation: 파편화된 Task-specific 스택 대신 단일 모델 내에서 다양한 비디오 생성 및 편집 태스크를 통합합니다. Modality Identity, Temporal Coordinates, Noise Levels, Output Targets을 명시적으로 인코딩하는 Native Task Representation을 통해 Appearance References, Frame-aligned Controls, Editable 3D Renders, Game Recordings 등 이질적인 Visual Input을 하나의 모델로 처리할 수 있습니다.
- Systematic Data Pipeline: Video Cleaning, Subject Association, Multimodal Annotation, Aligned Control Construction을 위한 체계적인 데이터 파이프라인을 구축하여, 고품질의 Multi-shot Audiovisual Segment Corpus를 생성합니다 [Figure 2]. 이 데이터셋은 검증된 Conditioning Assets을 포함하며, Scene-level Shot Grouping과 Subject Discovery and Linking을 통해 일관성을 확보합니다.
- Multitask Training and Few-Step Distillation: LynnReal-Omni는 Multitask Flow Training과 Few-step Distillation을 통해 효율적인 생성을 가능하게 합니다. 특히 Flash Variant는 Transformer Depth Reduction 및 Spatial Token Compression을 통해 Denoise Cost를 절감합니다. Video와 Audio는 동일한 Denoising Evaluation을 공유하지만, 서로 다른 Modality-specific Noise Schedules에 따라 Condition됩니다 [Figure 3].
- Long Video Generation with Bounded History: 고정된 Head-overlap Interface와 Bounded History Storage를 사용하여 Long Video Generation을 지원합니다. 이는 Temporal Coherence를 유지하면서 Fixed Memory Interface를 보장합니다.
- Lightweight Decoder Distillation: Pretrained Denoiser의 Latent Interface를 유지하면서 Decoding Cost를 줄이기 위해 Original Video Decoder를 더 얕은 Student Decoder로 Distill합니다 [Figure 4]. 이는 Teacher Reconstruction, Spatial and Temporal Supervision, Frozen Encoder를 통한 Consistency를 결합하여 이루어집니다.
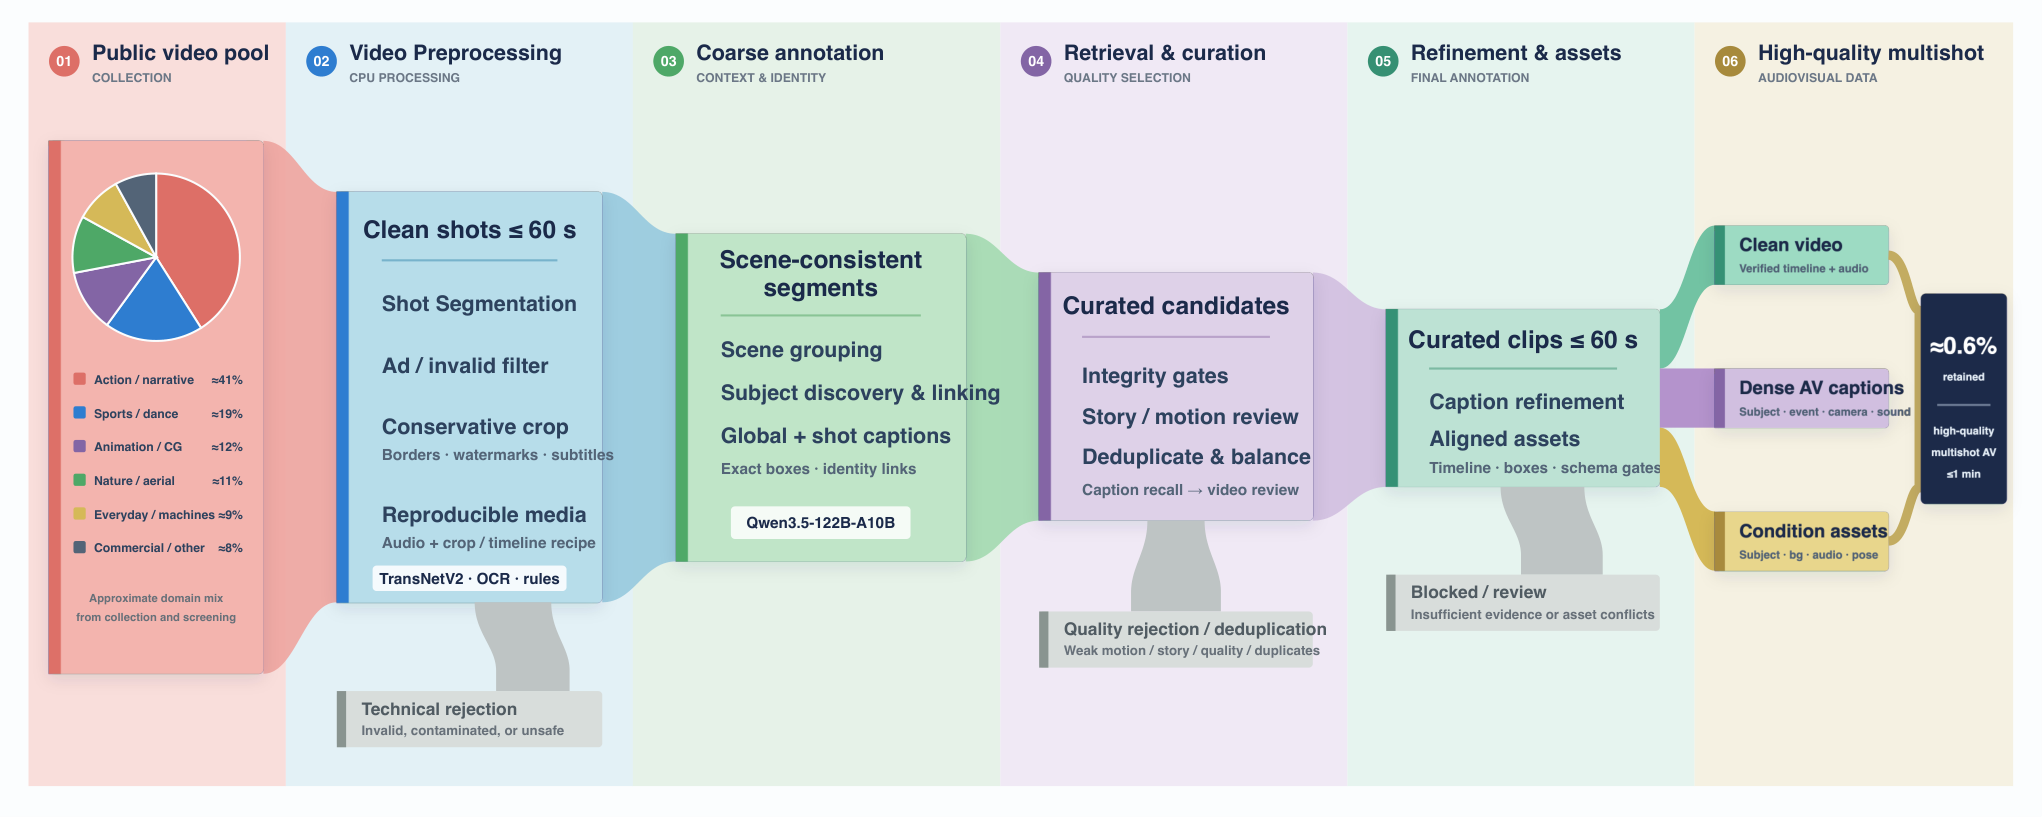
Figure 2 — 데이터 처리 및 주석 파이프라인
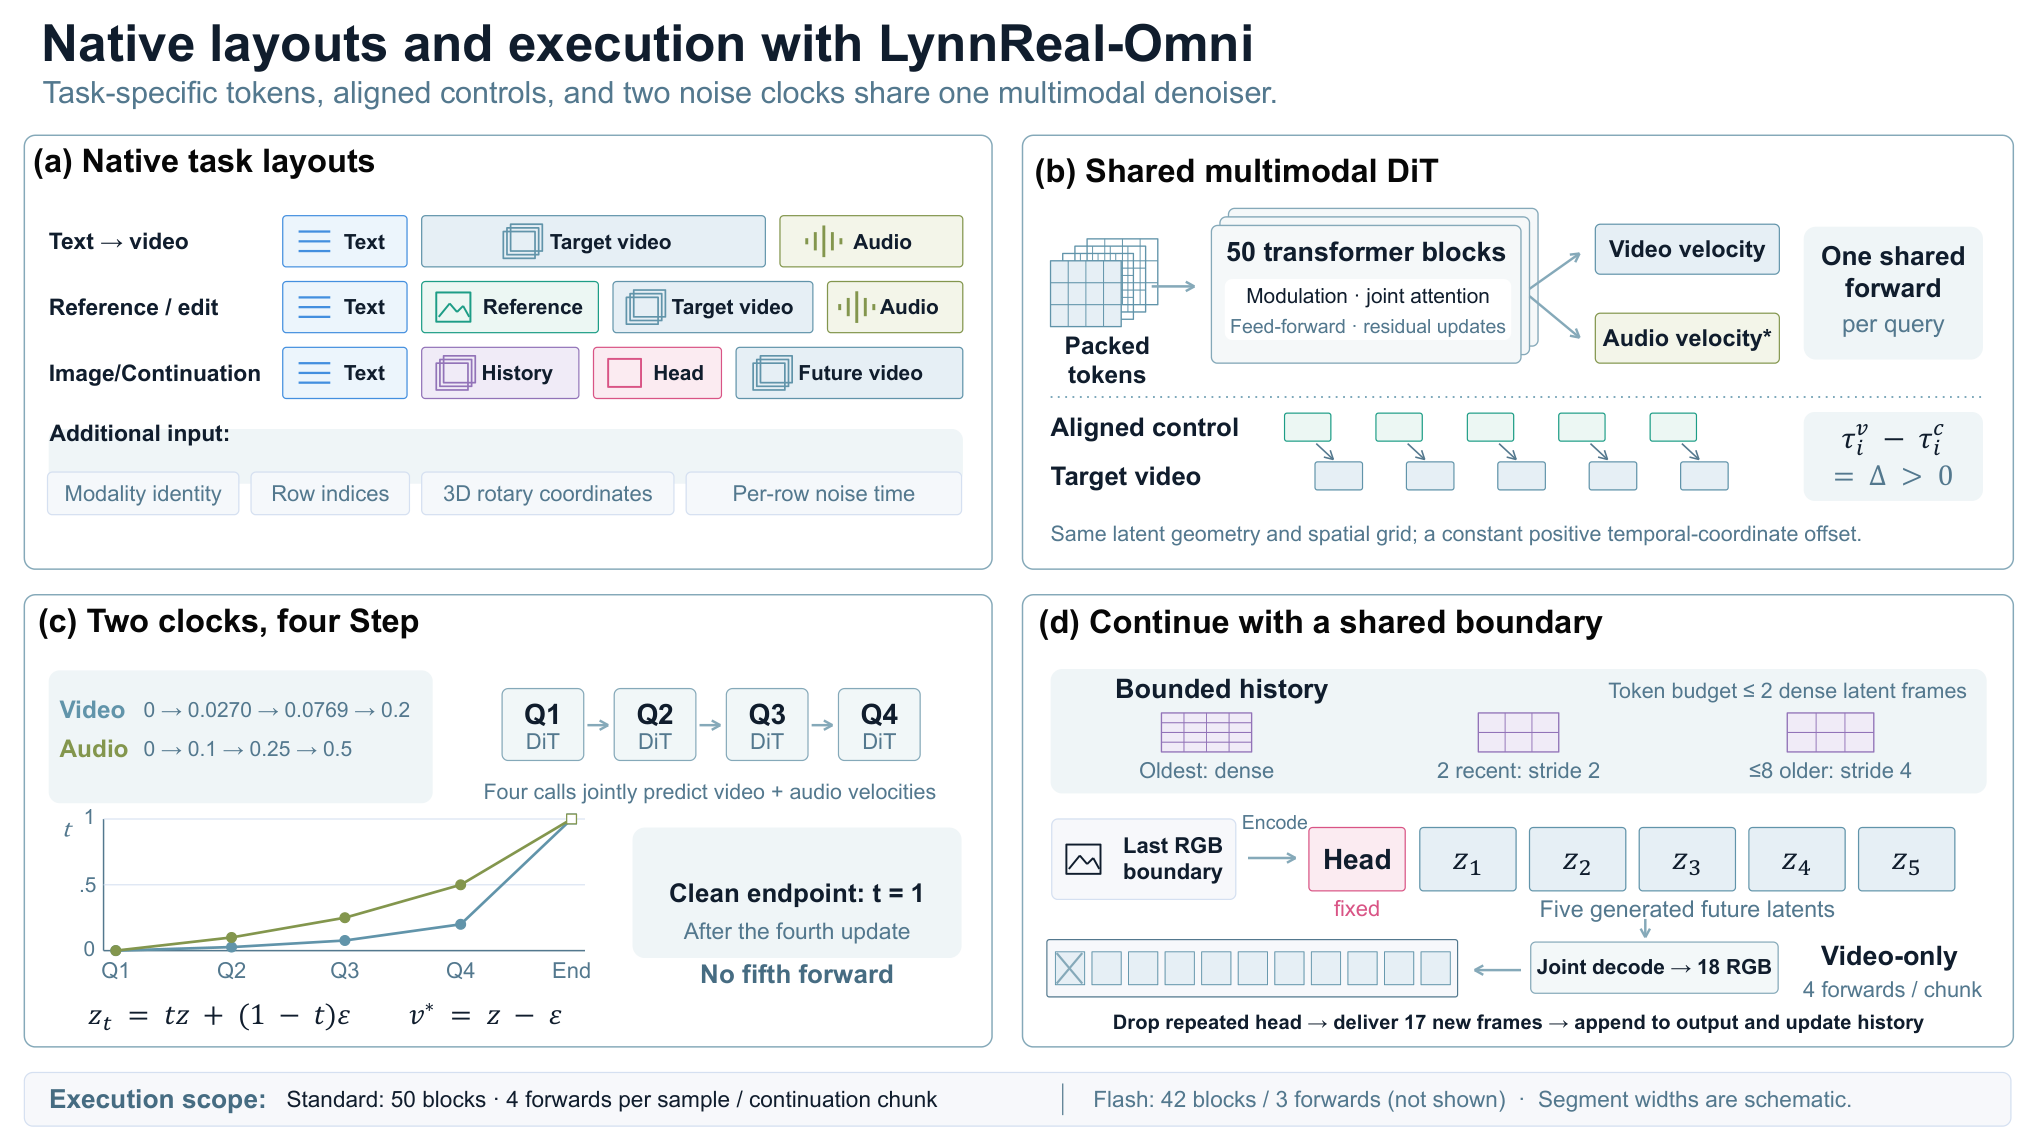
Figure 3 — Native 레이아웃 및 실행
주요 실험 결과는 다음과 같습니다:
- Inference Latency: LynnReal-Omni는 H100 GPU 한 대에서 22-frame 540p 비디오의 Warm Generation 및 Decoding에 843 ms가 소요되었으며, LynnReal-Omni-Flash는 이를 377 ms로 단축시켰습니다. 이는 기존 모델 대비 Significantly Improved Throughput을 보여줍니다. Flash Variant의 Decoder Compilation은 DiT + Decoder 시간을 540p, 22 frames에서 Standard 모델의 843 ms에서 Flash 모델의 377 ms로 줄였습니다.
- MSAVP Benchmark Performance: Text-to-Video (T2V) 및 Image-to-Video (I2V) 모드에서 LynnReal-Omni는 각각 77.76과 79.20의 Overall Score를 달성했습니다. 특히 I2V Prompt Fidelity 부문에서 선두를 차지했으며, Entity Fidelity, World-state Consistency, Aesthetic Quality, Imaging Quality에서 강점을 보였습니다. 768p, 15s 영상 생성 시, Standard 모델은 Generate 시간이 122.920초였던 반면, Flash 모델은 40.362초로 약 3배 빠른 성능을 보였습니다.
4. Conclusion & Impact (결론 및 시사점)
LynnReal-Omni는 Native Multimodal Video Diffusion과 Appearance, Geometry, Motion, History에 대한 명시적 제어를 성공적으로 결합한 Framework입니다. 본 연구는 고품질의 Multi-modal Video Generation을 위한 Unified, Controllable, Efficient Basis를 제공합니다. 특히 체계적인 데이터 파이프라인과 Native Task Representation을 통해 기존의 파편화된 접근 방식이 가진 한계를 극복하고, Agent-produced Scene 및 Executable Game Controls을 활용하여 검증 가능한 공간 및 움직임 Guidance를 제공합니다.
이 연구는 Real-time Streaming Video Generation 및 Agentic Visual Creation 분야에 중요한 기반을 마련하며, 복잡하고 Long-horizon Scene의 생성에 있어 일관성과 제어력을 크게 향상시키는 시사점을 가집니다. 미래 연구 방향으로는 독립적인 Cross-model MSAVP Scoring 완료, Automated Judge와 Human Agreement 측정, Recorded Action-to-display Timing을 포함하는 Long-er Interactive Trajectory 테스트가 제시되었습니다. 또한, Strong Style Transfer 하에서의 Temporal Stability 개선과 Physical Contact 유지 또한 중요한 과제로 남아 있습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Seedance 1.5 pro: A Native Audio-Visual Joint Generation Foundation Model
- [논문리뷰] LongCat-Video Technical Report
- [논문리뷰] Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs
- [논문리뷰] UltraTex: Unleashing 2K Multi-View Diffusion for 3D Texturing
- [논문리뷰] Modality-Autoregressive World-Action Models
Review 의 다른글
- 이전글 [논문리뷰] LLaDA-UI: Bringing Block-wise Diffusion to Vision-Language GUI Agents
- 현재글 : [논문리뷰] LynnReal-Omni: Native multi-modal Video Generation for Agentic Visual Workflows
- 다음글 [논문리뷰] ModaLens: Measuring Image Sensitivity in Report-Conditioned Medical VLMs
댓글