[논문리뷰] LLaDA-UI: Bringing Block-wise Diffusion to Vision-Language GUI Agents
링크: 논문 PDF로 바로 열기
저자: Zhangxuan Gu, Haoxing Chen, Qi Qin, Yi Xin, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 핵심적으로 다루는 용어 및 정의는 다음과 같다.
- Diffusion Large Language Models (dLLMs): 마스킹된 상태로부터 완전한 시퀀스를 재구성하여, 블록 병렬(block-parallel) 및 임의 순서(arbitrary-order) 생성을 가능하게 하는 언어 모델 패러다임이다.
- GUI Agent: 사용자 인터페이스(GUI) 환경에서 화면 상태를 인지하고 구조화되고 공간적으로 Grounded된(spatially grounded) Action을 실시간으로 수행하여 작업을 완료하는 AI 에이전트를 의미한다.
- Block-wise Diffusion: 디퓨전 모델의 생성 메커니즘으로, 현재 블록 내의 여러 토큰을 병렬적으로(in parallel) 정제하여 디코딩 효율성(decoding efficiency)을 향상시킨다.
- Native-Resolution Vision Encoder: 원본 해상도(native resolution)로 이미지를 처리할 수 있는 비전 인코더로, GUI 상호작용과 같이 미세한 시각적 디테일이 요구되는 태스크에 필수적이다.
- Supervised Fine-Tuning (SFT): 사전 훈련된 모델을 특정 데이터셋(여기서는 GUI Trajectories)에 대해 추가 훈련시켜, 특정 태스크에 대한 모델의 전문적인 능력을 강화하는 과정이다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 autoregressive (AR) 패러다임의 멀티모달 대규모 언어 모델(Large Language Models, LLMs)은 내재적인 순차적(sequential) 특성으로 인해 병렬화(parallelism)가 제한되고 상당한 추론 Latency를 발생시켜, 실시간성이 중요한 GUI Agent 애플리케이션에는 비효율적이다. 이러한 AR 모델들은 엄격한 인과적 구조(causal structure)를 가지므로 양방향 컨텍스트(bidirectional context) 모델링이나 전역적(global) 의미 정제(semantic refinement)가 필요한 태스크에는 제한적이다. Diffusion 모델은 텍스트 전용 및 일부 멀티모달 생성에서 유망한 대안으로 부상했지만, 동적인 모바일, 데스크톱, 웹 환경에서 반복적으로 변화하는 화면을 인지하고 실행 가능한 Action을 생성하여 장기적인(long-horizon) 태스크를 완료하는 Vision-Language GUI Agent로서의 확장 가능성은 여전히 미개척 분야였다. 따라서 본 연구는 디퓨전 모델의 병렬 디코딩(parallel decoding) 이점을 활용하여 효율적인 실시간 GUI 상호작용을 가능하게 하는 새로운 접근 방식이 필요함을 강조한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
LLaDA-UI는 16.7B-parameter MoE-based, block-wise diffusion vision–language GUI agent로, 두 단계의 훈련 파이프라인을 따른다. 첫 번째 단계에서는 일반적인 멀티모달 사전 훈련(pre-training)을 통해 native-resolution vision encoder (SigLIP ViT로 초기화)를 LLaDA2.0-mini-base diffusion language backbone과 정렬시킨다. 이 사전 훈련 단계는 Vision-Language Alignment, Perception Enhancement, Multi-task Pre-training의 세 가지 커리큘럼으로 구성되며, Vision Encoder와 Language Backbone의 representation space를 정렬하고 강력한 시각 이해 능력(visual understanding)을 부여한다. Figure 2에서 볼 수 있듯이, LLaDA-UI의 전체 아키텍처는 Diffusion Large Language Model, Vision Encoder, 그리고 Vision-Language Projector로 구성되어 GUI Observation을 인코딩하고 Task 및 Interaction-History 토큰과 인터리브(interleave)하여, LLaDA2.0 block-wise diffusion decoder가 마스킹된 출력 토큰을 구조화된 추론 및 실행 가능한 Action으로 점진적으로 정제한다. 이 Foundation 모델은 Qwen2.5-VL (4.1T) 및 Qwen3-VL (2.2T)과 같은 autoregressive 모델에 비해 적은 토큰(145B)으로 훈련되었음에도 불구하고, 멀티모달 추론(reasoning) 및 텍스트 중심(text-rich) 태스크에서 SDAR-VL-8B 대비 MathVista에서 12.8%, MathVision에서 13.6%, MathVerse에서 31.1%의 성능 우위를 달성하며 디퓨전 기반 MLLM(Multimodal Large Language Model) 중 최고 성능을 기록했다.
두 번째 단계는 GUI-Agent supervised fine-tuning (SFT)으로, 모바일(mobile), 데스크톱(desktop), 웹(web), Grounding 데이터를 포함하는 다양하고 대규모의 GUI Trajectories를 사용하여 모델을 특화시킨다. 이 SFT 데이터는 UI-Venus 프로젝트를 통해 수집되었으며, Figure 3에서 제시된 바와 같이 Task posing, Sub-capability decomposition, Capability composition, Environment execution 및 Validation 과정을 거쳐 생성된다. 실험 결과, LLaDA-UI는 Qwen2.5-VL-7B를 모든 벤치마크에서 능가했으며, 유사한 규모의 autoregressive 모델인 Qwen3-VL-8B를 ScreenSpot-Pro, AndroidWorld, MobileWorld, WebVoyager 네 가지 GUI 벤치마크에서 뛰어넘는 성능을 보였다. 특히, LLaDA-UI는 비캐시(non-cache-hit) API 호출 시 웹, OSWorld, MobileWorld 도메인에서 Qwen3-VL-8B 대비 평균 Latency가 3.579–8.951배 빠름을 입증하여, Inference 효율성 측면에서 실질적인 이점을 제공한다. LLaDA-UI는 AndroidWorld에서 98.65%의 Parse Rate와 98.59%의 Schema-valid Rate를 보이는 등 높은 Structured-action validity를 달성했지만, 장기적인(long-horizon) Recovery와 매우 큰 스크린샷에서의 High-resolution Grounding은 여전히 개선이 필요한 주요 failure mode로 분석되었다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 블록 단위 디퓨전(block-wise diffusion) 방식을 활용한 실질적으로 효과적인 Vision-Language GUI Agent인 LLaDA-UI를 제안한다. LLaDA-UI는 일반 멀티모달 사전 훈련(pre-training)을 통해 native-resolution ViT와 LLaDA2.0-mini-base diffusion language backbone을 정렬하고, 이어서 GUI-Agent SFT를 통해 모바일, 데스크톱, 웹 및 Grounding 태스크에서 실행 가능한 행동(executable behavior)을 학습하는 2단계 접근 방식을 따른다. LLaDA-UI는 Qwen2.5-VL-7B를 모든 벤치마크에서 크게 능가했으며, 유사한 규모의 autoregressive 모델인 Qwen3-VL-8B를 보고된 6개 Grounding 및 Cross-platform Navigation 벤치마크 중 4개에서 뛰어넘는 성능을 입증했다. 특히, LLaDA-UI는 비캐시(non-cache-hit) API Latency 측정에서 Qwen3-VL-8B 대비 3.579–8.951배 빠른 속도를 보여, 디퓨전 언어 모델이 Vision-Language Agent 분야에서 실용적인 새로운 가능성을 제공함을 시사한다. 이러한 결과는 디퓨전 기반 모델이 실시간 GUI 인터랙션과 같이 Latency-sensitive한 애플리케이션에서 AR 모델의 한계를 극복할 수 있음을 보여주며, 향후 고성능 GUI Agent 개발의 중요한 기반을 마련한다.
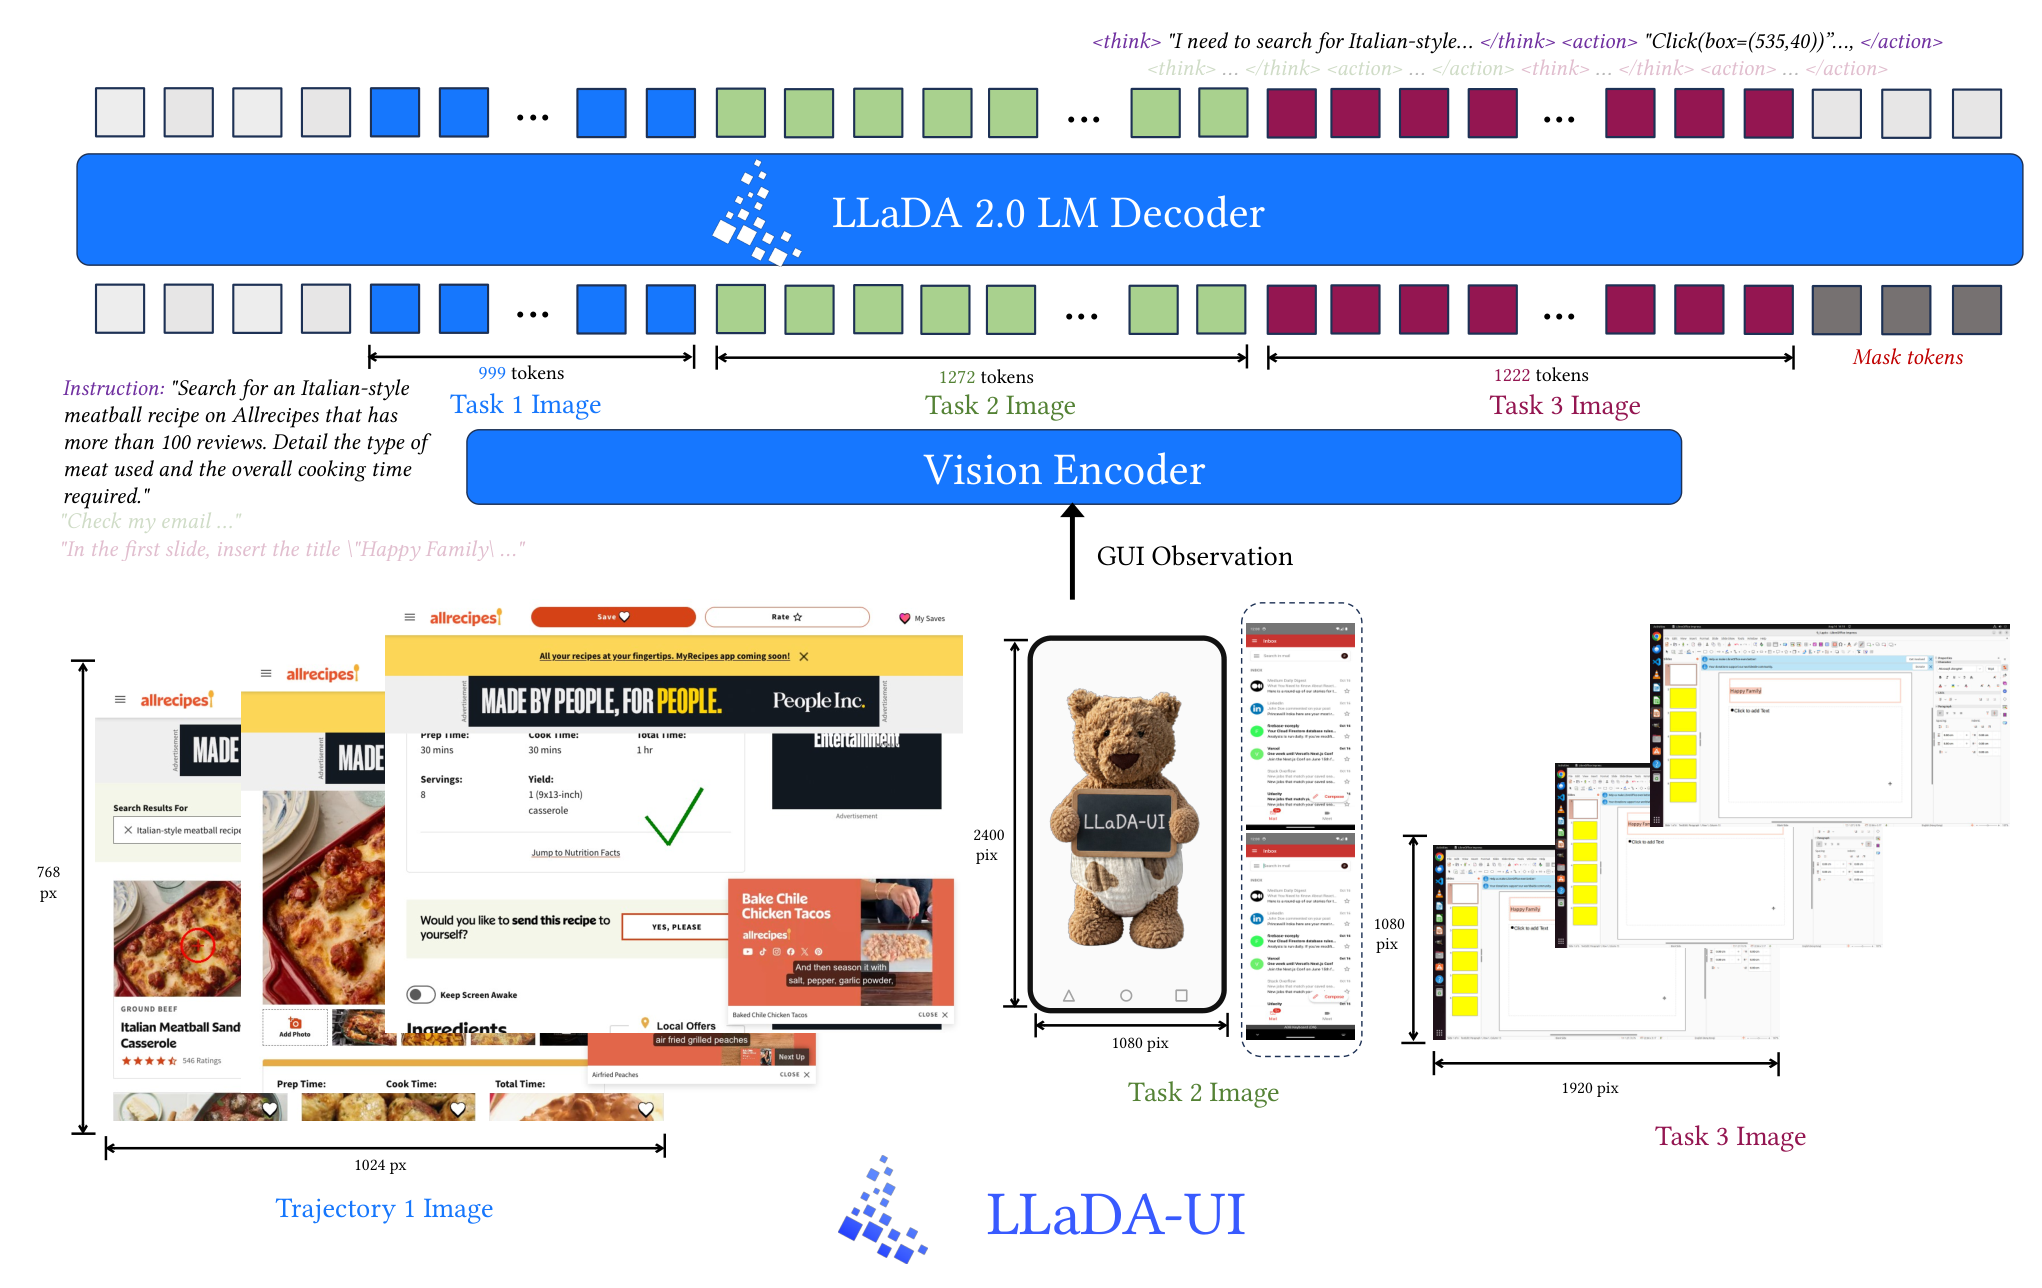
Figure 2 — LLaDA-UI 프레임워크
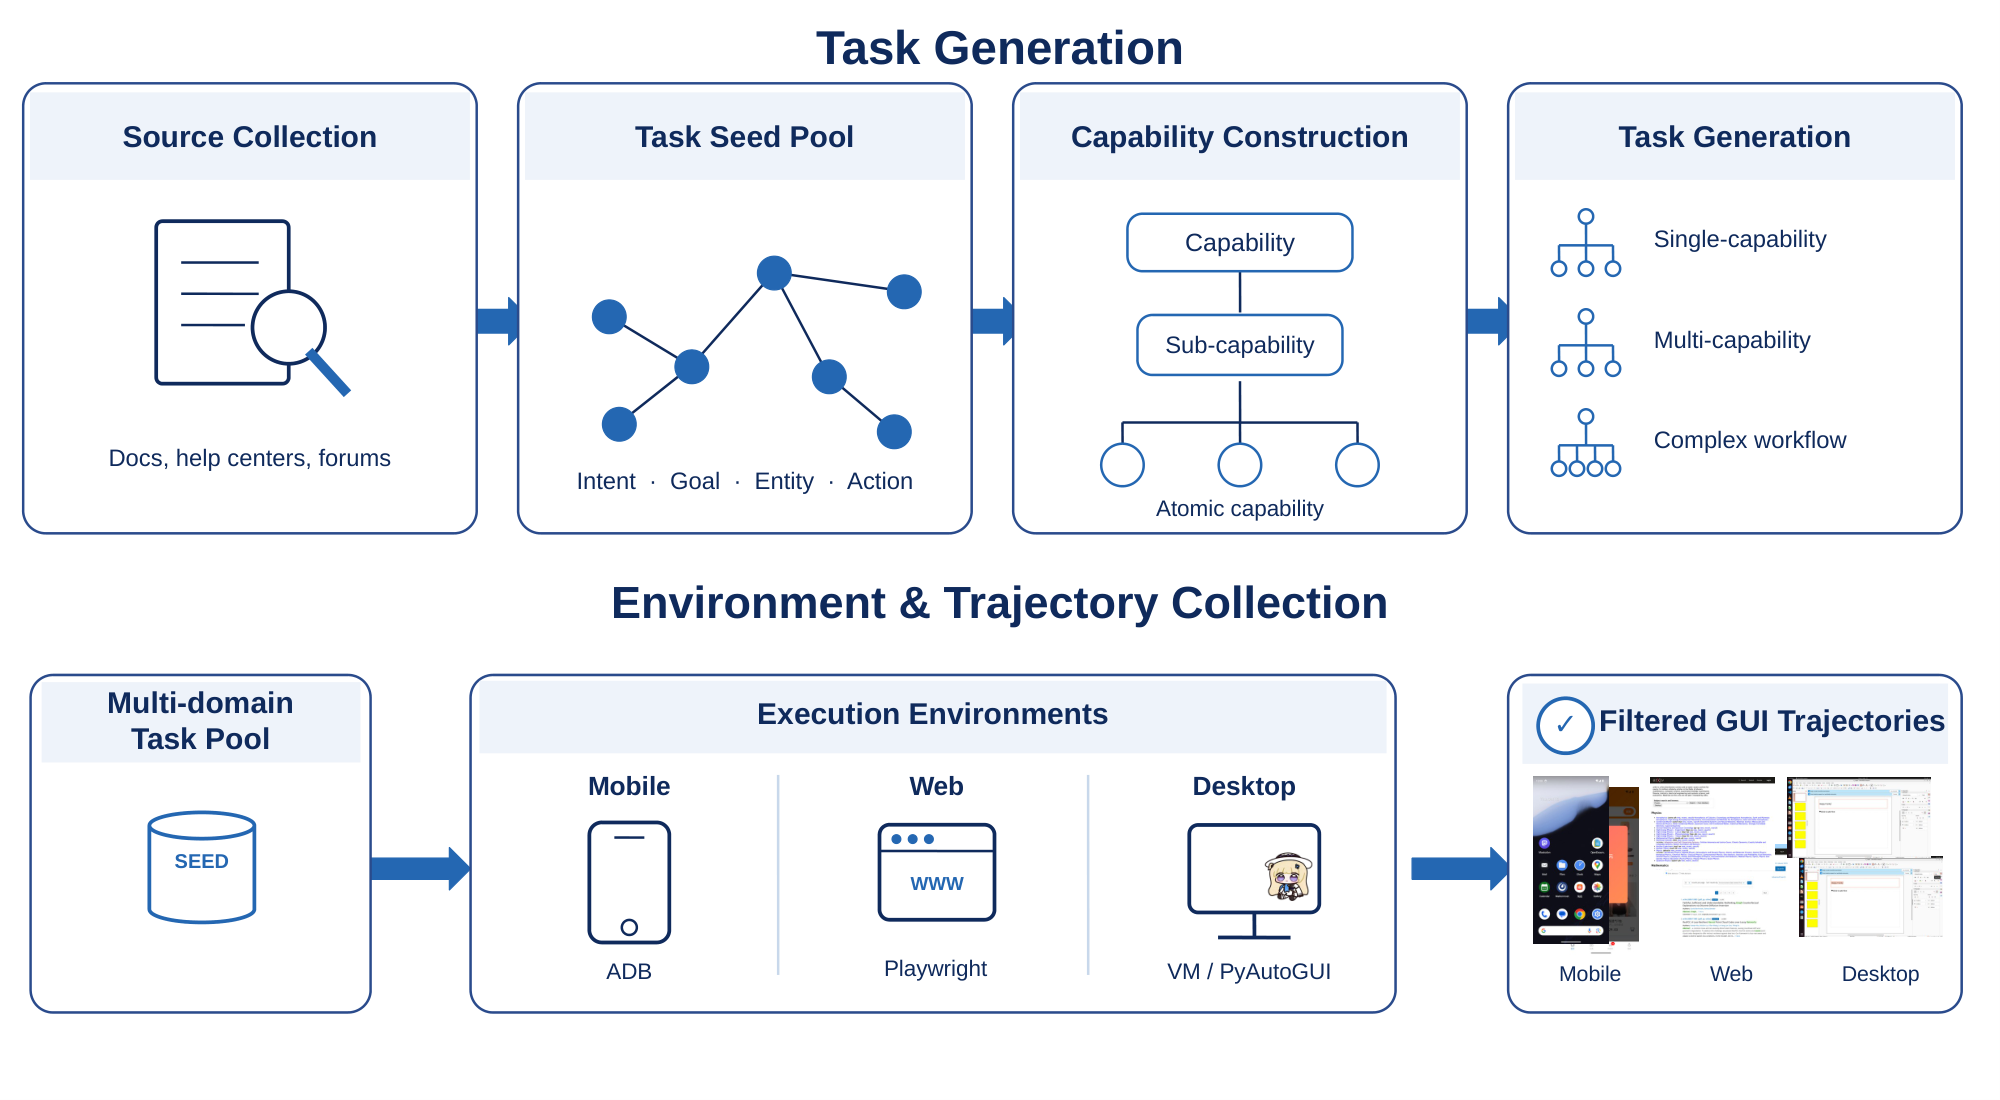
Figure 3 — GUI 데이터 생성 파이프라인
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] HPD-Parsing: Hierarchical Parallel Document Parsing
- [논문리뷰] Compress-Distill: Reasoning Trace Compression for Efficient Knowledge Distillation
- [논문리뷰] AutoGUI-v2: A Comprehensive Multi-Modal GUI Functionality Understanding Benchmark
- [논문리뷰] NaviDriveVLM: Decoupling High-Level Reasoning and Motion Planning for Autonomous Driving
- [논문리뷰] GUI-Libra: Training Native GUI Agents to Reason and Act with Action-aware Supervision and Partially Verifiable RL
Review 의 다른글
- 이전글 [논문리뷰] Kaininja: Extending Native 3D Generators to the Part Level
- 현재글 : [논문리뷰] LLaDA-UI: Bringing Block-wise Diffusion to Vision-Language GUI Agents
- 다음글 [논문리뷰] LynnReal-Omni: Native multi-modal Video Generation for Agentic Visual Workflows
댓글