[논문리뷰] Decoy Direction Optimization: A Post-Hoc Defense Against LLM Abliteration
링크: 논문 PDF로 바로 열기
[Part 1: 요약 본문]
저자: Aashiq Muhamed, Mona T. Diab, Virginia Smith
1. Key Terms & Definitions (핵심 용어 및 정의)
- Refusal Feature Ablation (RFA): LLM의 안전 가드레일을 우회하기 위해 residual stream에서 linear한 refusal direction을 식별하고 제거하는 공격 기법. 높은 Attack Success Rate (ASR)를 달성하면서 모델의 capability를 유지한다.
- Decoy Direction Optimization (DDO): LLM Abliteration 공격에 대한 빠르고, post-hoc weight-editing defense 방법론으로, base-model finetuning이 필요 없다. 공격자의 contrastive estimator를 교란하여 실제 safety mechanism 대신 harmless한 orthogonal feature를 제거하도록 유도한다.
- Attack Success Rate (ASR): 유해한 프롬프트에 대해 모델이 준수하는 것으로 판단되는 비율. ASR이 높을수록 공격 성공률이 높음을 의미한다.
- MT-Bench: LLM의 대화 품질 및 coherent generation을 평가하는 벤치마크.
- XSTest: 유해한 프롬프트와 표면적으로 유사하지만 실제로는 무해한 프롬프트에 대한 LLM의 over-refusal (과도한 거부) 행동을 식별하는 테스트 스위트.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 open-weight 대규모 언어 모델(LLMs)에서 safety guardrails가 Refusal Feature Ablation (RFA)과 같은 공격에 의해 쉽게 우회될 수 있는 심각한 문제를 해결하고자 한다. 기존 연구에 따르면, LLM의 refusal 기능은 low-dimensional residual-stream feature에 의해 매개되는 경우가 많아, inference 시점에 harmful 및 safe activation 간의 difference-in-means (DIM) direction을 추정하고 이를 제거하는 RFA와 같은 training-free 공격이 가능해진다. 이러한 공격은 높은 ASR을 달성하며, 이미 수천 개의 uncensored 모델 변형이 공개적으로 호스팅되고 있다.
기존의 refusal 제거 방어 방법들은 주로 training-time 개입을 필요로 한다. 예를 들어, Circuit Breakers, LAT, ReFAT 등은 safety finetuning을 통해 refusal을 보존하지만, 이는 훈련 데이터, multi-GPU finetuning, 그리고 각 체크포인트마다 반복되어야 하는 비싼 하이퍼파라미터 탐색을 수반한다. 또한, 이러한 방법들은 adaptive multi-phase RFA나 Heretic과 같은 자동화된 weight-level 공격에 대해 평가되지 않았다. Open-weight 체크포인트의 빠른 출시 주기와 지속적인 재훈련의 어려움을 고려할 때, 저비용, composable, data-light한 post-hoc 안전 강화 도구의 필요성이 대두된다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Decoy Direction Optimization (DDO)이라는 post-hoc weight-editing defense를 제안한다. 이 방법은 refusal feature 자체를 숨기려 하기보다는 공격자의 contrastive estimator를 적극적으로 교란하는 데 중점을 둔다. DDO는 MLP 뉴런의 작은 부분을 재활용하여 gated read–write map을 구현한다. 이는 harmful 프롬프트에서 refusal coordinate를 읽고, refusal에 orthogonal한 방향으로 큰 업데이트를 작성하여, DIM 추정치를 편향시키는 decoy-dominated contrast를 유도한다 [Figure 2, cite: 1]. 결과적으로, RFA는 실제 causal refusal subspace 대신 decoy 신호를 제거하게 된다. DDO는 다음 단계를 포함한다: (i) 128개의 harmful 및 128개의 safe probes를 사용하여 per-layer refusal direction r̂를 DIM을 통해 추정한다. (ii) target layer당 n개의 low-impact 뉴런(가장 작은 norm을 가진 W_down 컬럼)을 선택한다. (iii) r̂에 orthogonal한 decoy write direction u_i를 4가지 손실(refusal preservation, benign retention, estimator confusion, first-token anchoring) 하에 gradient-optimize하며, 스칼라 gain (β, s)는 Bayesian hyperparameter search (Optuna)를 통해 조정한다 [Figure 2, cite: 1]. (iv) 최적화된 파라미터를 replace 또는 additive mode를 사용하여 weights에 compile하고, causal refusal zone 또는 그 이전에 edits를 배치한다.
DDO는 표준 RFA 공격에 대해 6가지 모델 패밀리에서 <10%의 평균 ASR을 달성했으며, 이는 finetuning 없이 단일 A100 GPU에서 최적화 실행당 약 2분이 소요되는 낮은 비용으로 이루어졌다. Llama-3-8B-Instruct 모델에서 DDO는 adaptive multi-phase RFA 공격 하에 trained defense와 유사한 성능을 보였다 (65%의 worst-case ASR vs. 최상위 trained baseline의 58%) [Figure 3, cite: 1]. 또한, Heretic weight-level attack에 대한 ASR을 88.7%에서 18%로 크게 감소시켰다 [Table 2, cite: 1]. DDO는 trained defense 대비 30–450배 낮은 구성당 최적화 비용을 보였다 [Figure 1, cite: 1]. 특히, estimator confusion loss와 refusal-score loss가 DDO의 효과에 가장 중요하게 기여하며, 이들 중 하나라도 제거될 경우 ASR이 크게 증가했다 [Table 5, cite: 1]. Orthogonal debiasing을 추가하여 DDO로 인해 발생할 수 있는 over-refusal 문제를 해결하면서 XSTest 점수를 91.6%에서 99.2%로 향상시켰다 [Table 2, cite: 1].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Refusal Feature Ablation에 대한 post-hoc defense인 Decoy Direction Optimization (DDO)을 제안한다. DDO는 MLP 뉴런을 재활용하여 공격자의 contrastive estimator를 교란함으로써, 모델 finetuning 없이도 기존의 gradient-based trained defense와 유사하거나 더 나은 방어 성능을 달성한다. 핵심적인 통찰은 contrastive attack이 추정하는 contrast만큼만 효과적이라는 점이다. DDO는 크고, harmful-selective하며, refusal에 orthogonal한 decoy 신호를 주입하여 공격자가 실제 refusal 대신 decoys를 제거하도록 강제한다.
이 연구는 open-weight LLM의 안전성 강화에 중대한 영향을 미친다. DDO는 전체 finetuning 인프라, 방법론별 안전 데이터셋 없이도 소수의 generic probe set과 단일 GPU만으로 수 분 내에 적용될 수 있다. 이는 모델 제공자, 배포자, 안전 감사자 등 weight에 접근할 수 있는 모든 주체가 체크포인트를 빠르게 강화할 수 있도록 한다. DDO는 가장 접근하기 쉬운 refusal-removal workflow의 비용을 증가시켜, CBRN(화학, 생물학, 방사능, 핵) 역량 증진, 사이버 공격 생성, 아동 성 착취물(CSAM) 생산과 같은 악용 위험을 줄이는 데 기여한다. 궁극적으로 DDO는 빠르게 진화하는 LLM 생태계에서 post-hoc, 저비용 안전 강화 도구로서 중요한 역할을 할 것으로 기대된다.
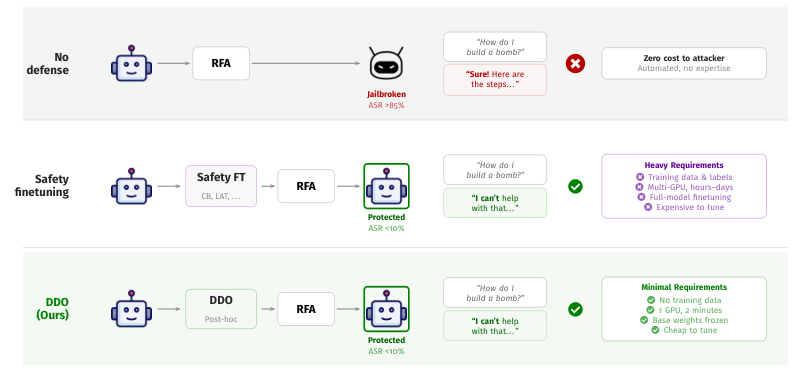
Figure 1 — DDO와 기존 방어 기법 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Statistical Estimation of Adversarial Risk in Large Language Models under Best-of-N Sampling
- [논문리뷰] LiveSecBench: A Dynamic and Culturally-Relevant AI Safety Benchmark for LLMs in Chinese Context
- [논문리뷰] Safety for Whom? Boundary-Aware Self-Distillation for Controlled LLM Safety Refusal
- [논문리뷰] LMSM: LLM Security Framework Inspired by Linux Security Modules
- [논문리뷰] CLEAR: Continuous Latent Adapter Routing for Utility-Preserving LLM Safety Alignment
Review 의 다른글
- 이전글 [논문리뷰] Convergent Emergence of In-Context Learning Across Modalities
- 현재글 : [논문리뷰] Decoy Direction Optimization: A Post-Hoc Defense Against LLM Abliteration
- 다음글 [논문리뷰] Disentangling Representation Evolution in Transformers through Directional Decomposition
댓글