[논문리뷰] Disentangling Representation Evolution in Transformers through Directional Decomposition
링크: 논문 PDF로 바로 열기
메타데이터
저자: Shwai He, Haichao Zhang, Shen Yan
1. Key Terms & Definitions (핵심 용어 및 정의)
- Directional Decomposition: Transformer의 학습된 업데이트 벡터를 기준 상태(Incoming hidden state 또는 Value vector)에 대해
Parallel및Perpendicular성분으로 분해하는 기법입니다. - Parallel Component: 기준 벡터와 같은 방향을 가지며, 정보의 크기(Magnitude)를 조절하는 성분입니다.
- Perpendicular Component: 기준 벡터와 수직인 방향으로, 모델의 의미적 궤적(Semantic trajectory)을 변경하거나 새로운 부분 공간(Subspace)으로 정보를 투영하는 핵심 성분입니다.
- Exclude-self Scaling: Attention Value space에서 자기 자신(Self-token)으로 향하는 메시지(
Direct self-message)를 보존하면서, 다른 토큰들로부터 오는Cross-token aggregation성분만을 독립적으로 조절하는 기법입니다. - Isotropic Compression Error: 방향을 고려하지 않고 단순 유클리드 거리(L2 norm)로 계산된 압축 오차로, 본 논문은 이 방식이 모델의 실제 성능 저하를 정확히 반영하지 못함을 지적합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Transformer 계층의 학습된 업데이트 벡터가 왜 상당한 양의 Parallel 성분을 포함하며, 이것이 모델의 성능에 실제적인 기여를 하는지 혹은 단순한 중복(Redundancy)인지를 규명하고자 합니다. 기존의 Residual stream 구조는 이미 단순한 스칼라 Rescaling 기능을 제공함에도 불구하고, 많은 파라미터가 Parallel 성분 생성에 할당되고 있습니다. 저자들은 이러한 Parallel 업데이트가 Perpendicular 업데이트와 비교했을 때 기능적으로 어떠한 역할을 수행하는지, 그리고 특정 representation 공간에 따라 어떻게 다른지 체계적으로 분석합니다. 특히, 기존의 무차별적인 압축 기법들이 왜 모델의 성능 저하를 정확히 진단하지 못하는지에 대한 기하학적 근거를 제시합니다 [Figure 1].
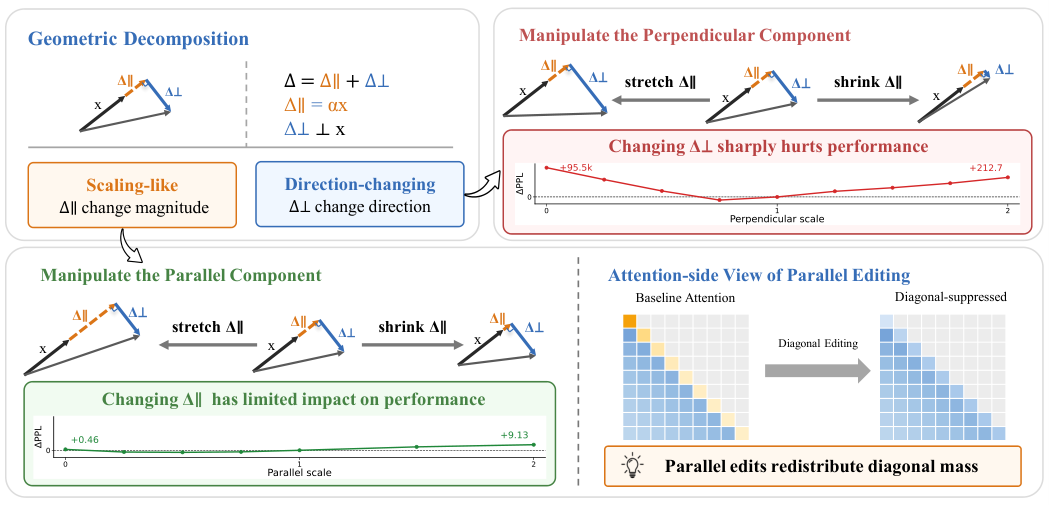
Figure 1 — 레이어별 Parallel 성분 유지
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Transformer의 업데이트를 Residual space와 Attention value space라는 두 공간에서 방향성 분해하여 독립적으로 scaling하는 방법론을 제안합니다 [Figure 2]. 실험 결과, Perpendicular 성분을 수정하는 것은 모델 성능을 즉각적으로 붕괴시키는 Hyper-fragile한 특성을 보인 반면, Parallel 성분을 조절하는 것은 Broad stability를 유지함을 확인하였습니다. 특히 Value-space에서 Exclude-self Scaling을 적용할 경우, 자기 자신에 대한 정보가 유지되어 downstream task에서 baseline 모델과 대등한 성능을 유지함을 입증했습니다 [Table 1]. 또한, 모델 압축 및 사전 학습 과정에서도 Perpendicular 오차가 모델 품질을 더 정확하게 예측하는 지표임을 확인하였으며, 사전 학습 시 Parallel 성분을 억제(Suppression)하는 것이 오히려 validation loss와 downstream 성능 향상을 유도한다는 점을 수치적으로 증명했습니다 [Figure 5, Figure 6]. 4-bit AWQ 및 Wanda pruning 결과에서 확인된 것처럼, 뛰어난 성능을 보이는 압축 모델들은 일관되게 낮은 Perpendicular error를 유지합니다.
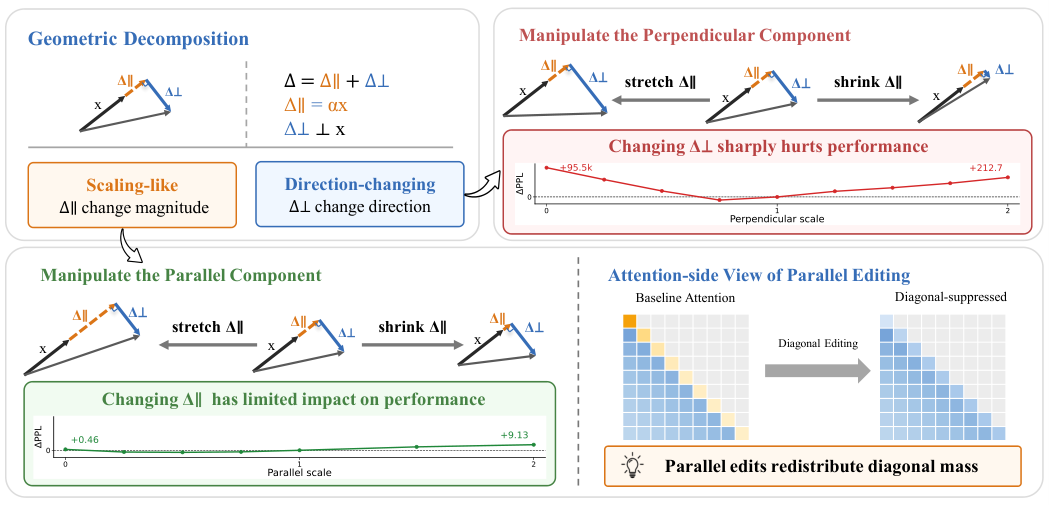
Figure 2 — 기하학적 분해 및 Scaling
4. Conclusion & Impact (결론 및 시사점)
본 연구는 Transformer의 표현 진화(Representation evolution)가 단순한 정보 추가가 아닌, 방향성을 가진 기하학적 업데이트라는 점을 성공적으로 밝혀냈습니다. Parallel 업데이트는 상당 부분 기능적 중복성을 띠며, Perpendicular 성분이 모델의 핵심적인 의미적 steerability를 담당한다는 사실은 모델 설계와 효율화 전략에 중대한 시사점을 제공합니다. 이 연구는 향후 효율적인 모델 압축(Model compression), 더 가벼운 아키텍처 설계, 그리고 모델의 내부 표현을 해석하고 편집하는 기법 개발에 중요한 기초 이론으로 활용될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] The Strong Lottery Ticket Hypothesis for Multi-Head Attention Mechanisms
- [논문리뷰] Why Is Video Still So Expensive? A Survey of Inference-Efficiency Mechanisms in Video and Audiovisual LLMs
- [논문리뷰] A*-Thought-V2: Efficient Latent Reasoning via Geometric Dynamics of LLM
- [논문리뷰] Debias-SparseGPT: Bias-Aware Pruning for Large Language Models
- [논문리뷰] Quantization-Aware Healing: A Practical Recipe for Recovering Compressed, 4-Bit LLMs
Review 의 다른글
- 이전글 [논문리뷰] Decoy Direction Optimization: A Post-Hoc Defense Against LLM Abliteration
- 현재글 : [논문리뷰] Disentangling Representation Evolution in Transformers through Directional Decomposition
- 다음글 [논문리뷰] Drift-Constrained Optimization: Only Direction Matters in Fine-Tuning Instruct Models
댓글