[논문리뷰] A*-Thought-V2: Efficient Latent Reasoning via Geometric Dynamics of LLM
링크: 논문 PDF로 바로 열기
메타데이터
저자: Xiaoang Xu, Siyuan Liu, Shuo Wang, Junlan Feng, Fanyu Meng, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Explicit-Implicit Interleaved Architecture: 중요 Reasoning 단계는 명시적 텍스트(Explicit Text)로, 중복되거나 부차적인 단계는 압축된 연속적 잠재 벡터(Implicit Latent Token)로 구성하여 효율성과 정보 보존을 동시에 달성하는 구조입니다.
- Embedding Forcing: 중복되는 Reasoning 단계의 토큰 임베딩을 평균 풀링(Mean Pooling)하여 하나의 고차원 잠재 벡터로 변환함으로써 컨텍스트 길이를 획기적으로 줄이는 기술입니다.
- Label Forcing: 잠재 토큰이 단순한 원-핫(One-hot) 타겟이 아닌, 해당 단계의 전체 토큰 분포를 평균낸 소프트(Soft) 다중 모달 타겟을 예측하도록 유도하여 학습 효율을 극대화하는 기법입니다.
- Geometric Dynamics: LLM의 은닉 상태(Hidden State)를 PCA 공간에 투영하여 질문-답변 방향과 Reasoning 단계 간의 각도 변화를 분석함으로써 Reasoning의 탐색, 수렴, 정제 단계를 시각화하고 제어하는 방법론입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 Chain-of-Thought(CoT)가 유발하는 과도한 컴퓨팅 비용과 컨텍스트 길이에 따른 성능 저하 문제를 해결하기 위해 고안되었습니다. 기존의 하드 프루닝(Hard Pruning) 기법은 Reasoning 과정 중 일부 정보를 완전히 삭제하여 정보 손실이 발생하는 한계가 있습니다. 저자들은 Reasoning 과정을 은닉 상태 공간에서의 궤적(Trajectory)으로 재정의하고, 정보 손실 없는 효율적인 압축을 위해 기하학적 역학을 활용한 새로운 접근 방식을 제안합니다 [Figure 1].
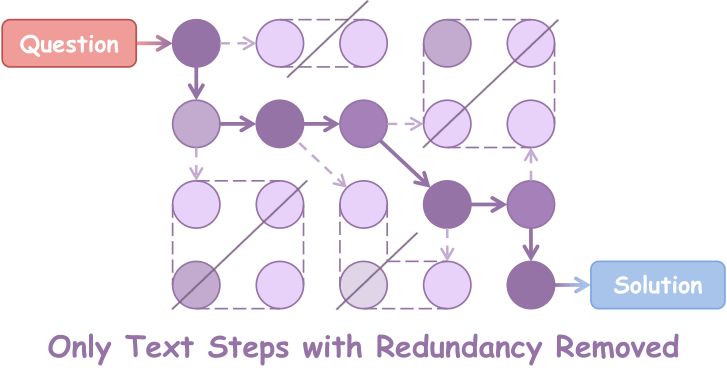
Figure 1 — 기존 CoT와 제안 방식 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 PCA 공간에서 질문-답변 방향과 Reasoning 단계 간의 각도를 계산하여 중요도가 낮은 단계들을 선별하고, 이를 Embedding Forcing 및 Label Forcing을 통해 잠재 공간으로 압축하는 A-Thought-V2* 프레임워크를 제안합니다 [Figure 2]. 해당 방법론은 Reasoning 단계를 탐색, 수렴, 정제 단계로 구분하여 기하학적 각도 임계값에 따라 동적으로 Step을 할당합니다 [Figure 3]. 실험 결과, Qwen3.6-27B 모델 기준 기존 SFT 대비 평균 정확도를 최대 2.6% 향상시켰으며, 응답 길이를 최대 절반 수준으로 단축했습니다 [Table 1]. 또한, ACU(Accuracy per Computation Unit) 지표에서 기존 대비 2.29× 개선된 효율성을 보였으며, 전처리 및 학습 시간을 각각 94.6%, 최대 80.3% 단축하는 성과를 거두었습니다 [Table 1], [Table 3].
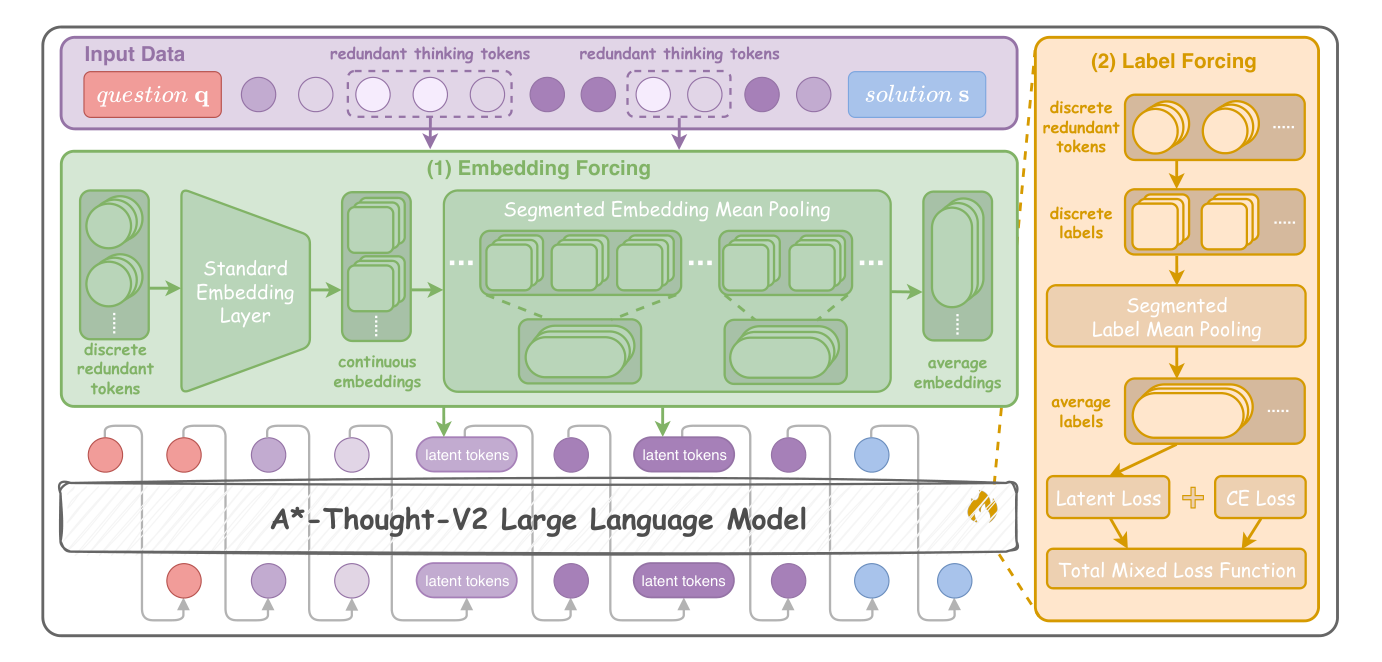
Figure 2 — A-Thought-V2 전체 프레임워크*
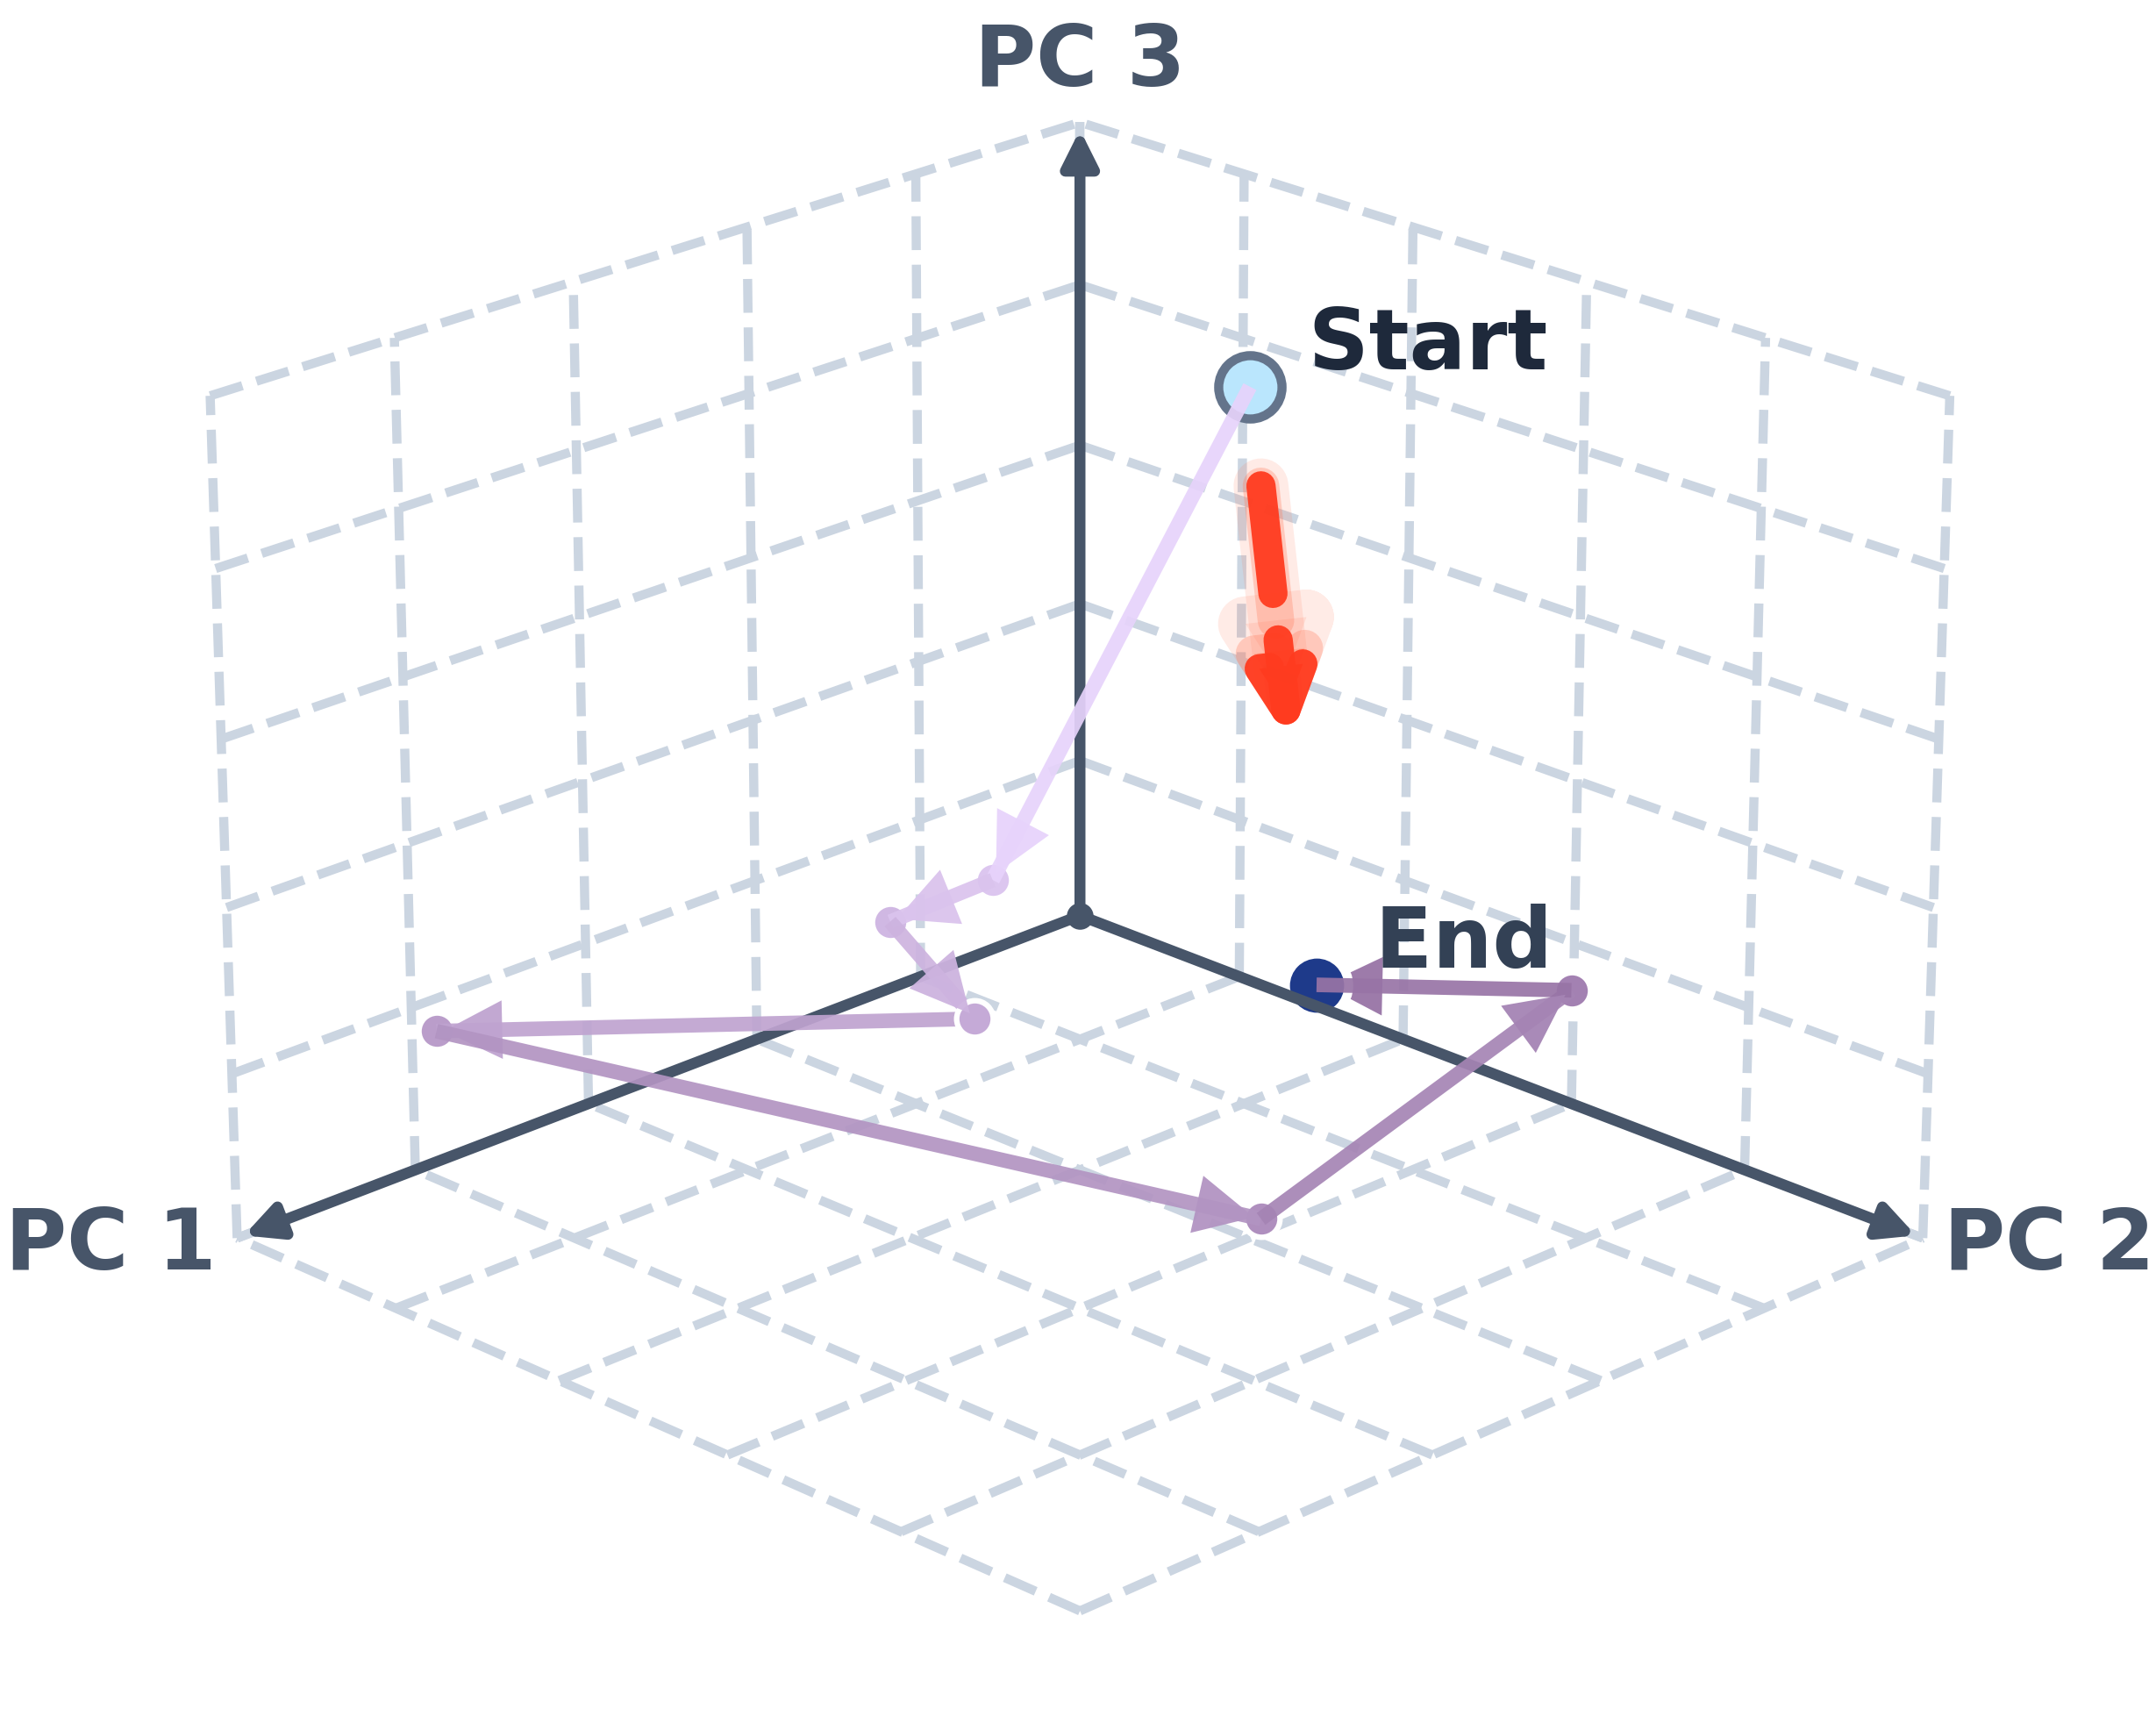
Figure 3 — PCA 투영 궤적 및 역학 분석
4. Conclusion & Impact (결론 및 시사점)
본 연구는 LLM의 Reasoning 과정을 기하학적으로 해석하여 데이터 선택과 압축을 자동화하고, 연속적인 잠재 공간에서 학습 가능한 인터리브 구조를 성공적으로 구현하였습니다. *A-Thought-V2**는 복잡한 Reasoning 모델의 추론 비용을 획기적으로 낮추면서도 성능을 개선했다는 점에서 실용적인 학술적 가치를 지닙니다. 이 연구는 향후 경량화된 LLM이 고도화된 추론 성능을 유지해야 하는 온디바이스(On-device) 및 대규모 산업용 AI 환경에서 매우 중요한 방법론적 토대를 제공할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Intern-S2-Mobius: Foundation Model with Decoupled Knowledge and Reasoning
- [논문리뷰] IV-CoT: Implicit Visual Chain-of-Thought for Structure-Aware Text-to-Image Generation
- [논문리뷰] Compress-Distill: Reasoning Trace Compression for Efficient Knowledge Distillation
- [논문리뷰] Latent Reasoning with Normalizing Flows
- [논문리뷰] LatentOmni: Rethinking Omni-Modal Understanding via Unified Audio-Visual Latent Reasoning
Review 의 다른글
- 이전글 [논문리뷰] What Else Needs Fixing? Exploring Cost-Effective Test-Time Compute for Revision Propagation in Artifacts Generated Through Conversation
- 현재글 : [논문리뷰] A*-Thought-V2: Efficient Latent Reasoning via Geometric Dynamics of LLM
- 다음글 [논문리뷰] Agentic Visual Generation: From Generative Models to Agentic Control
댓글