[논문리뷰] VākQA: A Benchmark and Evaluation Study for Telugu Spoken Factoid Question Answering
링크: 논문 PDF로 바로 열기
저자: Bhavana Akkiraju, Ravi Sastry Kolluru, Charan Devarakonda, Srihari Bandarupalli, Santosh Kesiraju, Anil Kumar Vuppala
1. Key Terms & Definitions (핵심 용어 및 정의)
- Spoken Question Answering (SQA): 음성 입력을 받아 직접적인 답변을 생성하는 시스템으로, 음성 인식(speech understanding)과 질문 답변(question answering)을 결합한 분야입니다.
- Factoid Question Answering: 명확하고 간결한 사실적 답변을 요구하는 질문-답변 유형입니다.
- Low-resource languages: 음성 및 텍스트 데이터가 부족하여 자연어 처리(NLP) 연구 및 모델 개발이 어려운 언어를 지칭하며, 본 논문에서는 텔루구어(Telugu)가 이에 해당합니다.
- LLM-as-a-judge: 대규모 언어 모델(Large Language Model, LLM)을 활용하여 다른 모델이 생성한 답변의 정확성, 유창성 등을 평가하는 방식입니다.
- ASR (Automatic Speech Recognition): 음성 신호를 텍스트로 자동 변환하는 기술입니다.
- MT (Machine Translation): 한 언어의 텍스트를 다른 언어로 자동 번역하는 기술입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 텔루구어 Spoken Question Answering (SQA) 분야의 벤치마크 부재와 자동 평가의 신뢰성 문제를 해결하고자 합니다. 기존 Question Answering (QA) 연구는 주로 영어와 같은 고자원 언어에 집중되어 있으며, 텔루구어 SQA 벤치마크는 거의 탐색되지 않았습니다. TeQuAD와 같은 텔루구어 텍스트 QA 데이터셋은 존재하지만, 음성 변동성을 고려하지 않아 SQA 환경에는 부적합하다는 한계가 있습니다. 또한, 기존 평가 지표인 Exact Match (EM) 및 F1은 paraphrase에 취약하며, ASR 오류 및 이중 언어 전사(transcription) 상황에서 정확하지만 표면 형태가 다른 답변을 제대로 평가하지 못하는 한계가 있습니다. LLM-as-a-judge 방식 또한 언어 및 태스크에 따라 일관성이 없다는 문제가 제기되었으나, 텔루구어 SQA 환경에서의 신뢰성은 아직 정량화되지 않았습니다. 이러한 문제점들은 텔루구어 SQA 모델의 개발과 평가를 어렵게 만듭니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 텔루구어 Spoken Factoid Question Answering을 위한 벤치마크 VākQA를 구축하고 공개했습니다. VākQA는 6개 도메인에 걸쳐 2,001개의 factoid 질문-답변 쌍과 총 2.53시간 분량의 음성 오디오, 이중 언어 전사 및 인간 검증된 참조 답변으로 구성됩니다. 데이터셋 구축은 YouTube 퀴즈 콘텐츠에서 음성 데이터를 수집하고, Pyannote VAD, fine-tuned Seamless-large-v2 (Seamless FT) Telugu ASR model, Gemini를 활용한 QA 쌍 추출, 그리고 인간 검증 및 번역의 다단계 파이프라인으로 진행되었습니다.
평가 신뢰성 연구에서는 Gemini-as-a-judge가 인간 평가와 가장 높은 상관관계(Spearman’s ρ = 0.86, Kendall’s τ = 0.77)를 보이며 다른 오픈-웨이트 모델들을 능가했습니다 [cite: 1, Table III]. 반면, Gemma-3-12B와 같은 오픈-웨이트 LLM-judges는 표면 형태가 다른 올바른 텔루구어 답변을 체계적으로 불이익을 주는 경향을 보였습니다 [cite: 1, Figure 2]. 이는 수치(numeric)와 철자(spelled-out) 날짜와 같은 의미론적 동등성을 인식하는 데 어려움을 겪기 때문입니다 [cite: 1, Table IV (E2)].
QA 모델 벤치마킹 결과, Gemini와 같은 proprietary 모델이 모든 입력 구성에서 오픈-웨이트 모델 대비 일관되게 높은 성능을 보였습니다 [cite: 1, Table V]. Oracle Telugu text 입력 시 Gemini는 평균 3.63점(1–5 척도)을 기록한 반면, 오픈-웨이트 모델인 Gemma-27B는 2.55점, Gemma-12B는 2.01점, Sarvam-m은 1.98점을 기록했습니다 [cite: 1, Table V]. 입력 언어의 영향 분석에서, Oracle Telugu text가 Oracle English text (평균 3.52점)보다 약간 더 나은 성능을 보였으며, 이는 텔루구어 구문이 문화적 특이성을 유지하여 번역 시 손실될 수 있음을 시사합니다 [cite: 1, Table V, Table VI]. 음성 입력 (평균 3.28점)은 텍스트 입력 (평균 3.63점)보다 성능 저하를 보였는데, 이는 음성 입력에서 발생하는 음향적 혼동이 질문의 의미를 변경하기 때문입니다 [cite: 1, Table V, Table VI, Table IV (E4)]. 특히 ASR 오류는 질문의 의미를 완전히 바꿀 수 있으며, cascaded ASR→MT 오류는 성능을 점진적으로 저하시키는 것으로 나타났습니다 [cite: 1, Table V, Table VI, Table VII, Table IV (E5)]. 도메인별 성능에서는 Culture 도메인이 텔루구어 입력에서 가장 강했지만, 영어로 번역될 때 가장 큰 성능 저하를 보였습니다 [cite: 1, Figure 3, Figure 4]. Science 및 Geography 도메인은 전문 용어와 고유 명사 덕분에 언어 간에 더 안정적으로 전이되었습니다 [cite: 1, Figure 3, Figure 4].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 텔루구어 Spoken Factoid Question Answering을 위한 최초의 벤치마크인 VākQA를 제시하고 공개하며, proprietary 및 open-weight 모델 모두에게 여전히 도전적인 과제임을 보여주었습니다. 입력 언어, 입력 양식, 그리고 cascaded ASR→MT 파이프라인의 설계가 모델 성능에 결정적인 영향을 미친다는 것을 입증했습니다. 특히, 텔루구어 텍스트는 번역된 영어보다 문화적 특이성과 질문의 범위를 더 잘 보존하며, 음성 입력은 음향적 혼동을 유발하고, ASR 및 MT 오류는 단계적으로 누적되어 성능 저하로 이어진다고 강조했습니다. 평가의 신뢰성 문제도 지적되었는데, 작은 open-weight LLM-judges는 텔루구어의 의미론적 동등성을 인식하지 못하며, Gemini-as-a-judge조차 낮은 점수에서는 관대하고 높은 점수에서는 엄격한 비균일적인 특성을 보였다는 한계를 언급했습니다. 이 연구는 저자원 언어 SQA의 복잡성을 조명하고, 향후 다국어 SQA 시스템 개발 및 평가 방법론 개선에 중요한 기여를 할 것으로 기대됩니다.
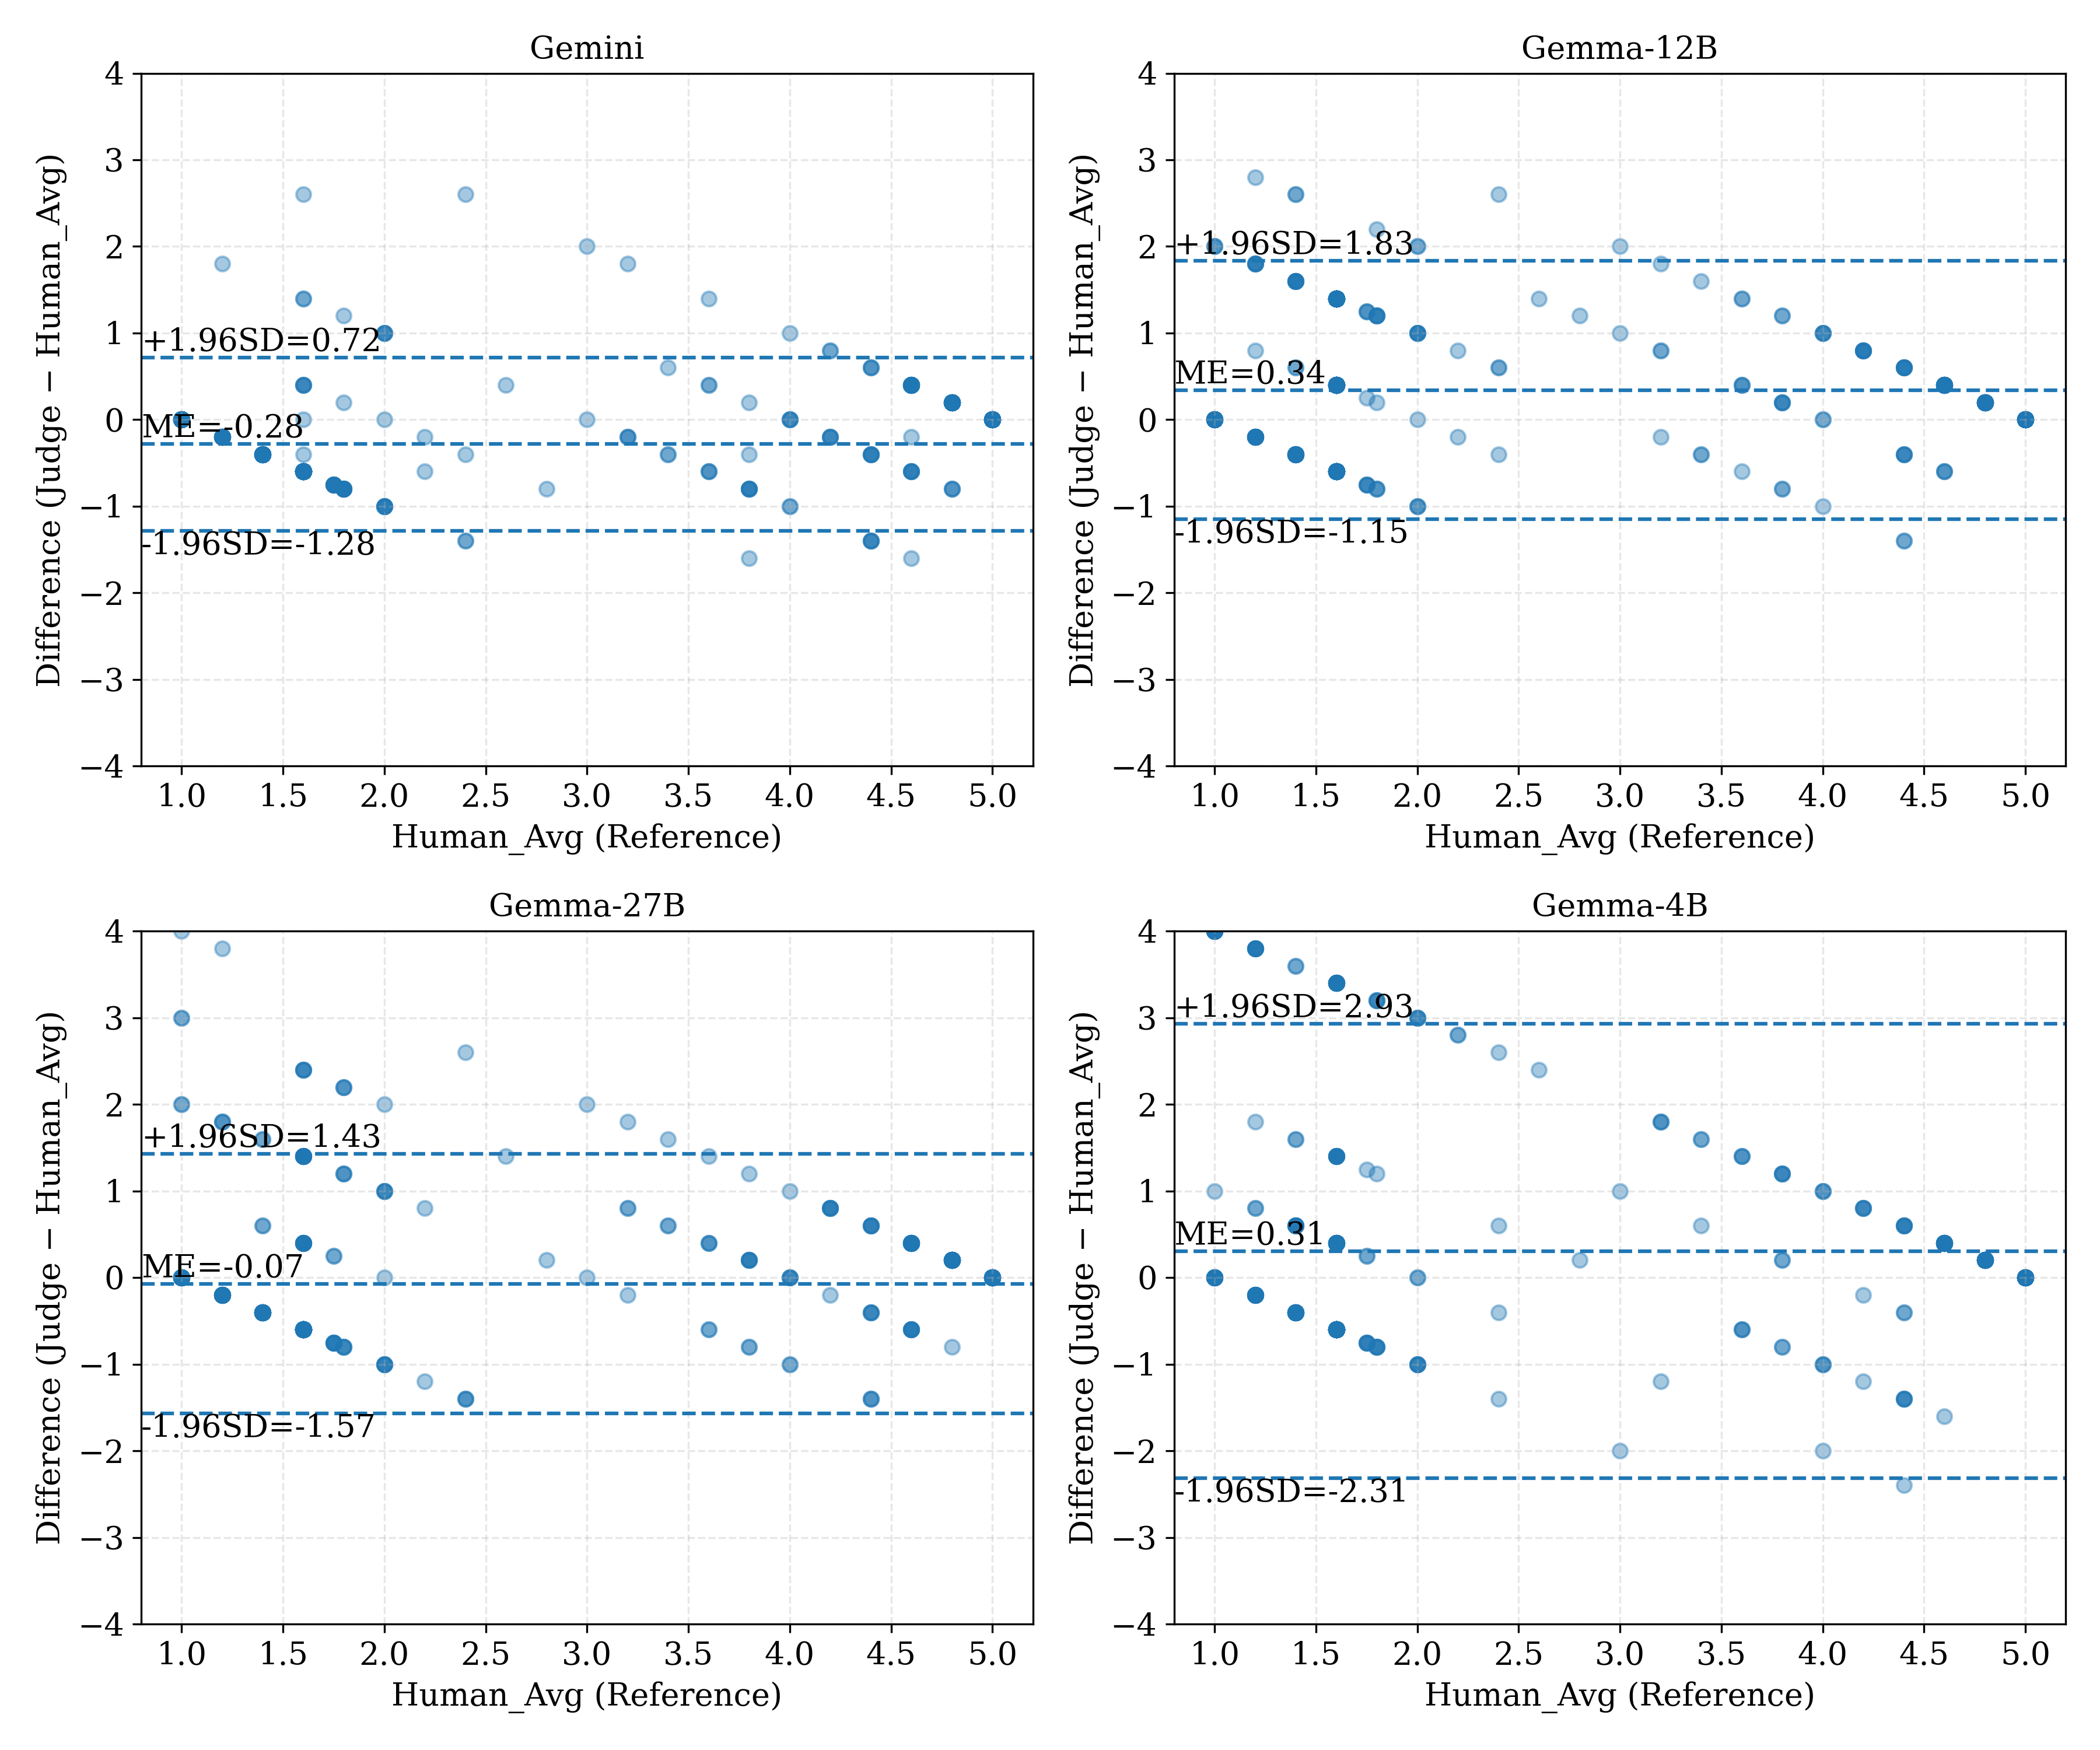
Figure 2 — LLM-as-a-judge 평가 비교
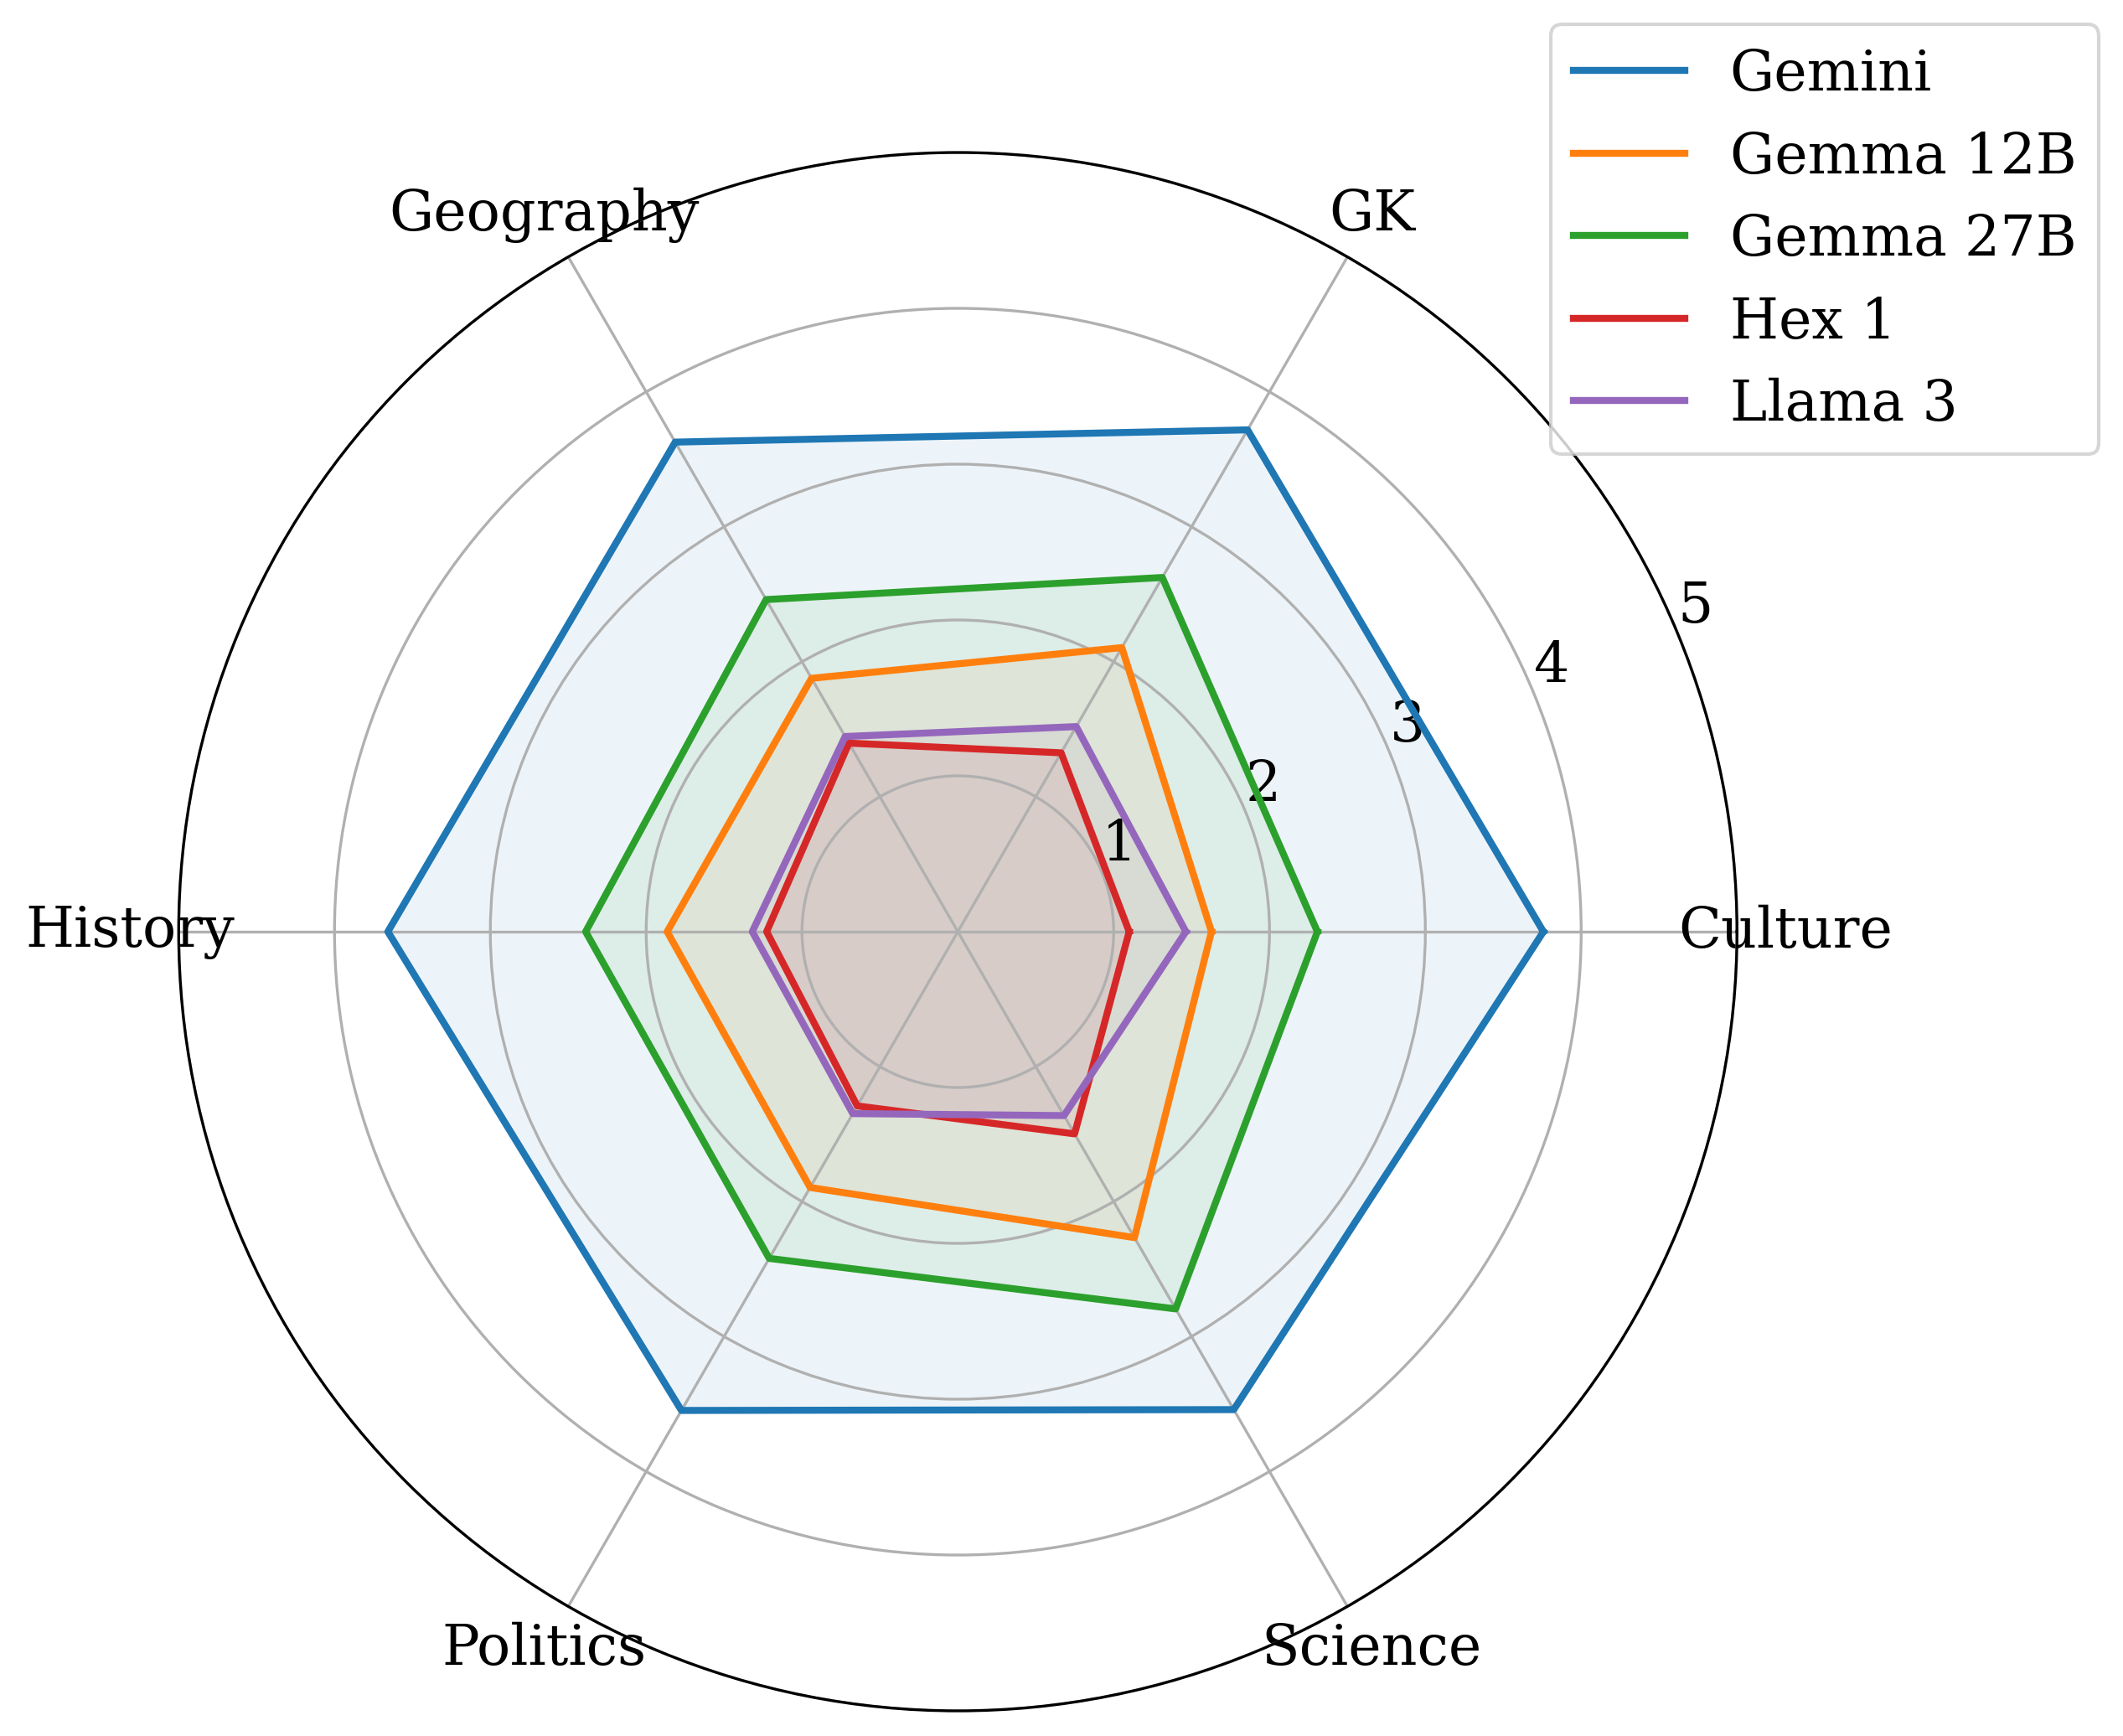
Figure 3 — 텔루구어 텍스트 입력 도메인별 성능
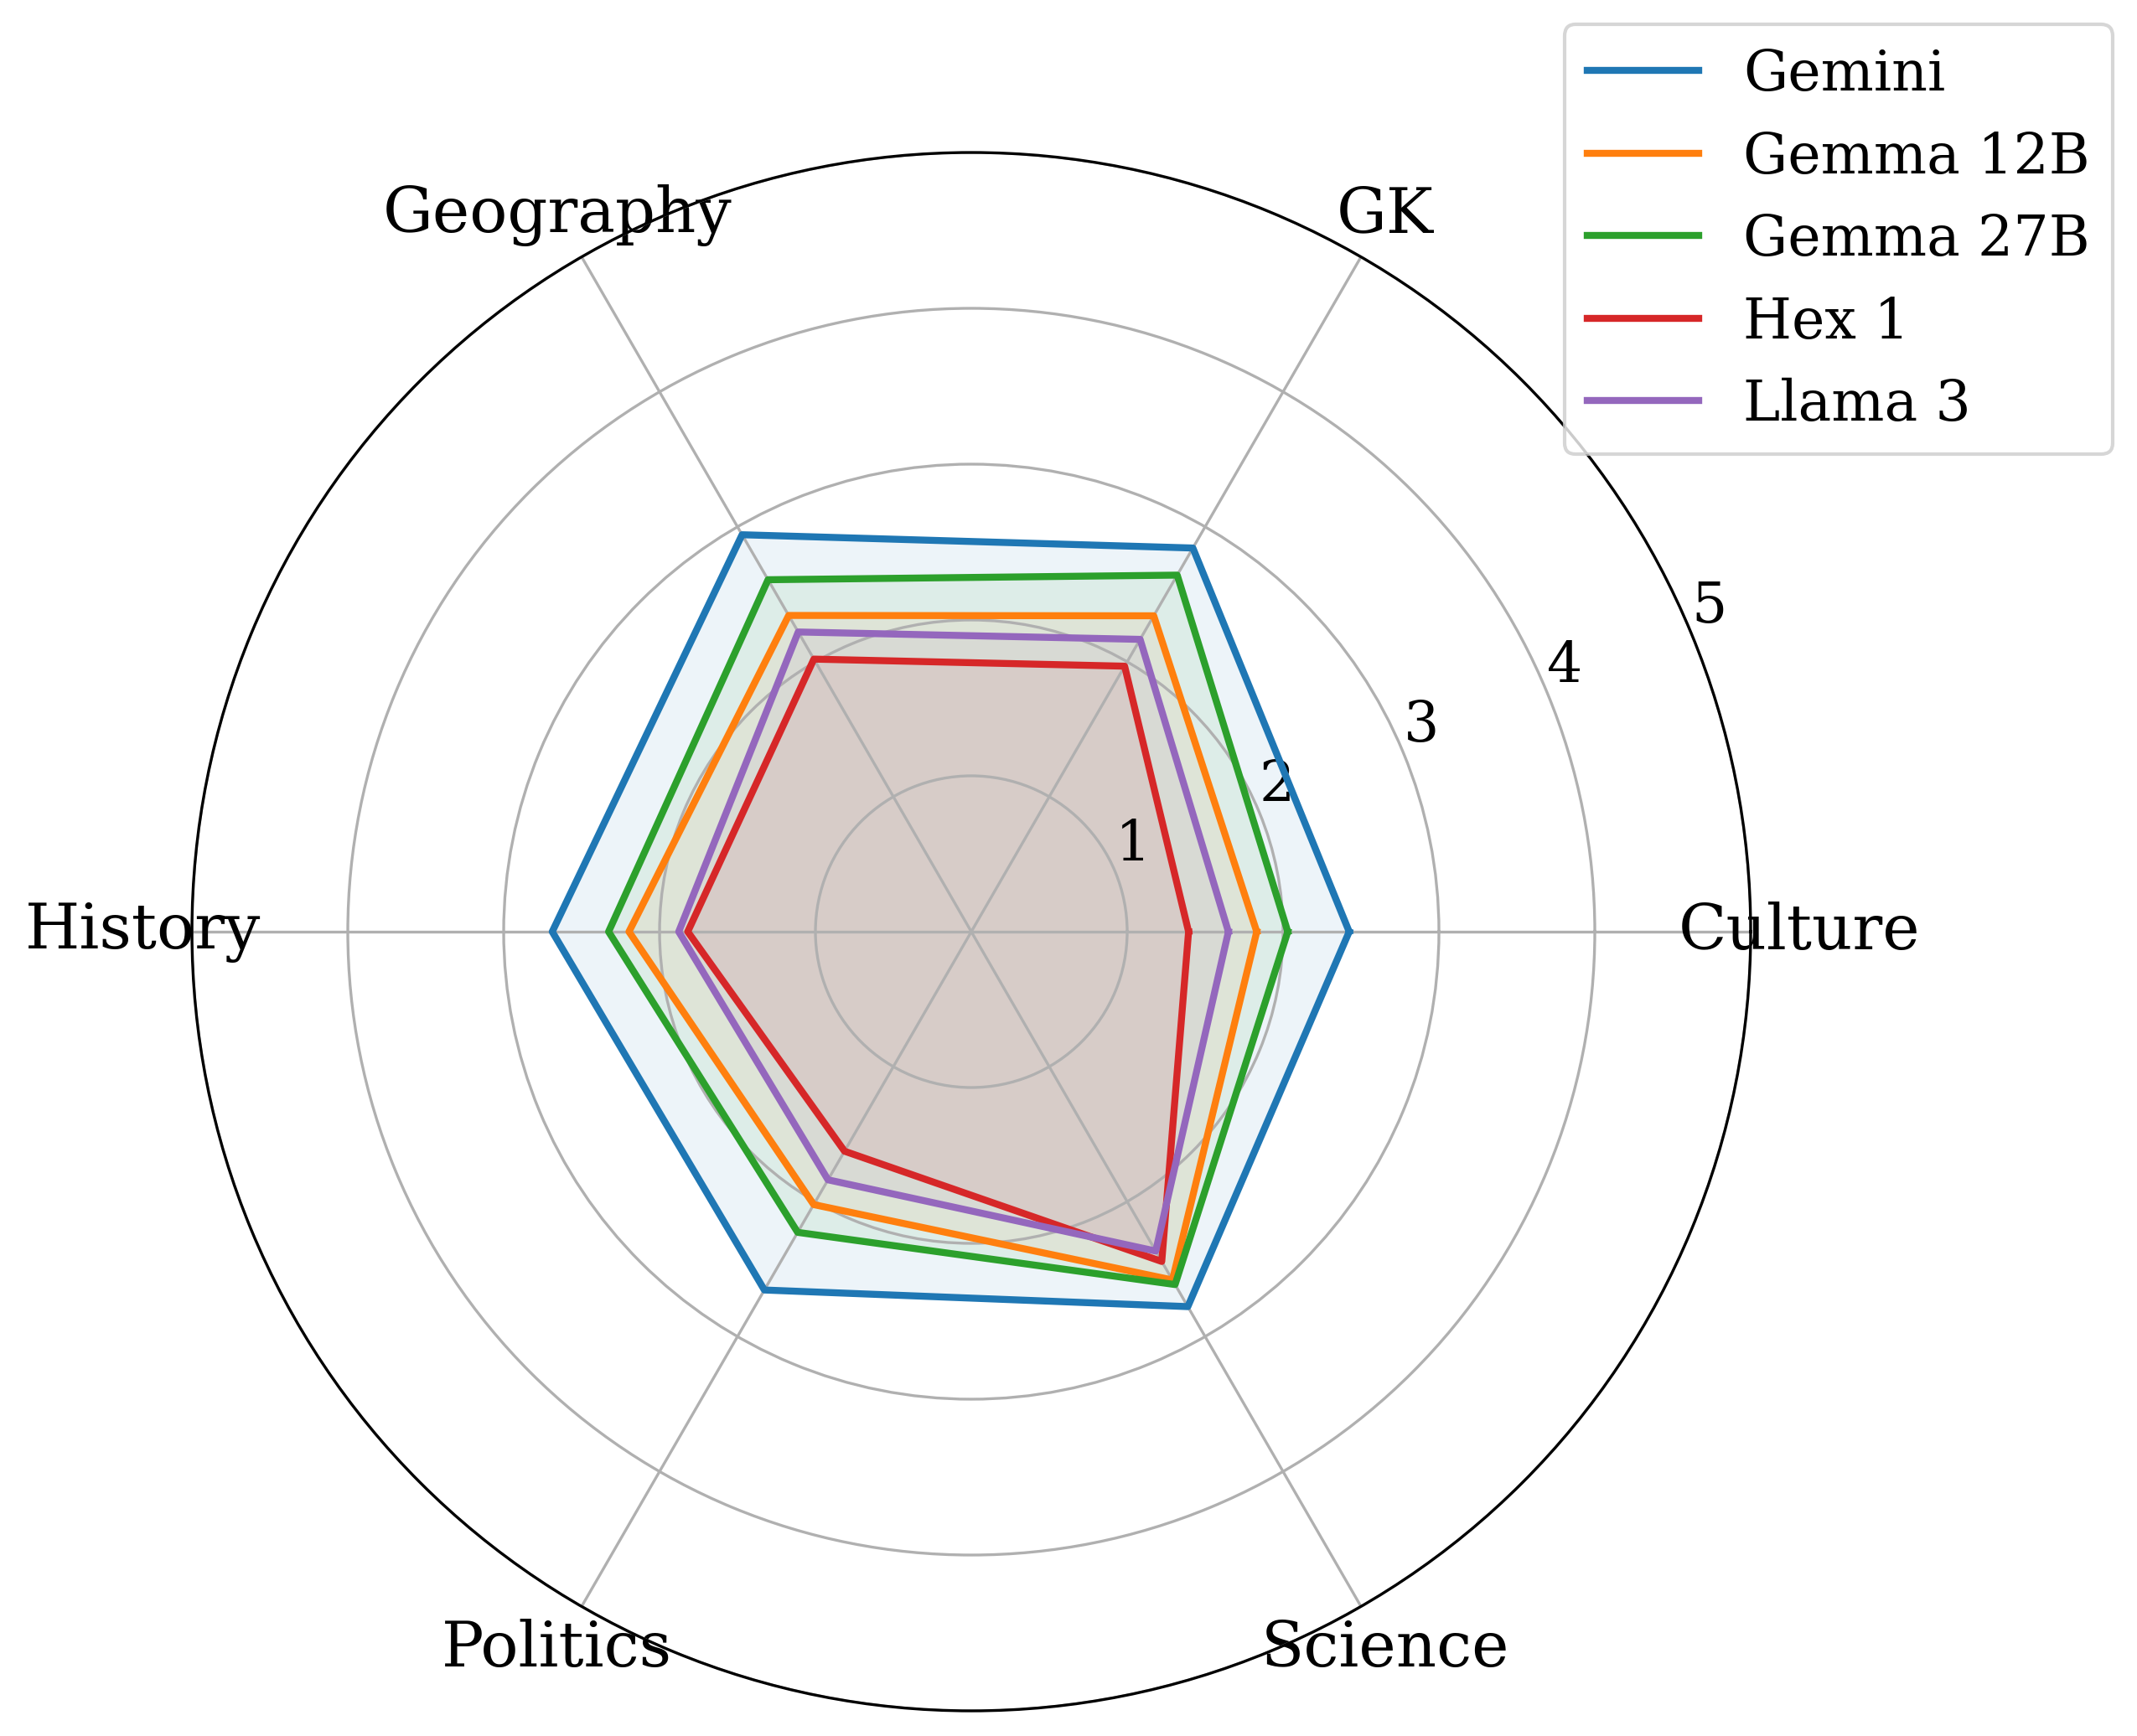
Figure 4 — 번역된 영어 텍스트 입력 도메인별 성능
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Two-Level Meta-Rubrics for Evaluating Open-Ended Generation: GAMUT, a Benchmark for Factual Completeness
- [논문리뷰] IndicParam: Benchmark to evaluate LLMs on low-resource Indic Languages
- [논문리뷰] OmniEcho: Spatial Audio Understanding for Embodied Agents
- [논문리뷰] JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
- [논문리뷰] OmniVBench: A Benchmark and Large-Scale Dataset for Omni Reference-to-Video Generation
Review 의 다른글
- 이전글 [논문리뷰] Video DeltaNet: A Video-Native Hybrid Attention for Livestream Video Generation
- 현재글 : [논문리뷰] VākQA: A Benchmark and Evaluation Study for Telugu Spoken Factoid Question Answering
- 다음글 [논문리뷰] WeVisDoc: From Coverage to Capability for Robust End-to-End Document Parsing
댓글