[논문리뷰] JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
링크: 논문 PDF로 바로 열기
저자: Yubo Li, Yidi Miao, Ramayya Krishnan, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- LLM-as-a-Judge: Large Language Model(LLM)을 사용하여 다양한 태스크에서 생성된 응답의 품질을 평가하는 방법론을 지칭합니다. 이는 인간 평가의 확장성과 자동화된 지표의 한계를 보완합니다.
- JEV (TypeSafe JEV): 논문에서 제안하는 의사결정 전용(decision-only) 인터페이스를 가진 평가 모델로, natural-language instructions와 structured inputs을 받아 verdict와 label probabilities를 직접 반환합니다.
- Confidence: JEV가 생성하는 label probability distribution에서 파생된 통계량으로, 특정 결정에 대한 모델의 확신도를 나타냅니다. 이는 selective evaluation을 위한 중요한 신호로 사용됩니다.
- Escalation Policy: JEV의 Confidence가 낮은 경우, 보다 강력하고 비용이 높은 LLM judge에게 평가 태스크를 위임하여 전체 시스템의 Accuracy를 유지하면서 비용 효율성을 높이는 전략입니다.
- Operating Envelope: JEV가 비용 효율적이면서도 고품질의 평가를 제공할 수 있는 특정 workload 및 태스크 조건을 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM-as-a-Judge 기반 평가 시스템의 Inference Cost와 Confidence Reliability 문제를 해결하기 위해 JEV-as-a-Judge를 제안합니다. 기존 LLM judge는 다양한 open-ended task에서 contextual assessment를 확장할 수 있는 유용한 도구이지만, 복잡한 Reasoning 과정에서 발생하는 추가적인 Token Generation은 Computation Cost와 Latency 증가로 이어집니다. 또한, LLM이 자체 Confidence를 보고할 때 과도한 Overconfidence를 보이는 경향이 있어, 신뢰할 수 있는 불확실성 신호(uncertainty signal)를 확보하는 것이 Reliability 및 Resource Allocation에 중요합니다. 이러한 문제점들은 평가를 대규모로 반복할 때 시스템 개발 및 운영 비용에 심각한 제약을 가합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 JEV를 활용하여 Confidence가 높은 판단은 직접 수용하고 불확실한 판단은 더 강력한 LLM으로 Escalation하는 Method를 제안합니다. JEV는 decision-only interface를 통해 verdict와 label probabilities를 직접 노출하며, 이로부터 Confidence를 도출하여 selective evaluation에 활용합니다. 연구는 RewardBench, JudgeBench, HaluEval 등 다양한 Public Benchmarks 및 자체 Existing Data에 걸쳐 16개의 Generative LLM Judges 및 Reward Model Judges와 JEV를 비교했습니다.
핵심 결과는 다음과 같습니다:
- Cost Efficiency: JEV는 Ordinary Preference 및 Evidence-grounded Factuality 태스크에서 최강의 비교 대상인 GPT-6와 3%p 이내의 Accuracy 차이를 보였습니다. 이와 동시에 JEV는 GPT-6 대비 0.36%의 Fee로 훨씬 낮은 비용을 기록했습니다. Matched Isolated Panel에서 JEV의 Median Latency는 0.152초, Fee는 1,000 Judgment당 $0.044였으며, 이는 GPT-6의 Median Latency 1.885초 및 Fee $12.182와 비교해 압도적인 효율성을 보여줍니다. [Figure 2]
- Quality Trade-offs: JudgeBench와 같이 Multi-step Derivation을 확인하거나 Elaborately Written Wrong Answer에 저항해야 하는 Difficult Correctness 태스크에서는 JEV의 Accuracy가 GPT-6 대비 14.6%p (78.6% vs 93.1%) 낮게 나타나, 이러한 Workload에서는 Escalation이 필요함을 보여주었습니다. [Table 1, Table 2]
- Error Complementarity & Deferral: JEV의 Confidence는 오류 발생을 효과적으로 예측하여, Confidence가 낮은 Decision에 GPT-6를 Fallback으로 사용하는 Cascade Policy를 통해 GPT-6 Accuracy의 99%를 유지하면서 GPT-6 단독 사용 대비 57%의 비용으로 운영 가능함을 입증했습니다. [Figure 4, Figure 5]
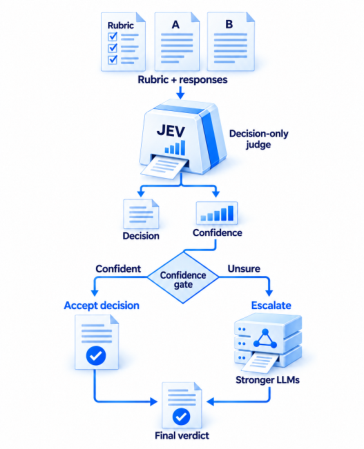
Figure 2 — JEV 캐스케이드 정책
4. Conclusion & Impact (결론 및 시사점)
본 연구는 JEV-as-a-Judge가 Ordinary Preference, Evidence-grounded Factuality, Final-answer Adjudication과 같은 광범위한 평가 Task에서 비용 효율적이면서도 강력한 LLM Judge에 필적하는 Performance를 제공함을 입증했습니다. JEV의 Confidence Signal은 Escalation Policy를 효과적으로 구현하여, Uncertainty가 높은 판단만 고비용의 강력한 LLM으로 위임함으로써 Accuracy를 거의 손실 없이 유지하면서도 전체 운영 비용을 크게 절감할 수 있는 실용적인 Framework를 제시합니다.
이 연구는 LLM 기반 평가 시스템의 대규모 상용화에 필수적인 비용 효율성 및 신뢰성 확보에 중요한 시사점을 제공합니다. 특히, Accept When Confident, Escalate When Unsure 전략은 LLM Judge의 운영 비용을 최적화하고 특정 Workload에서 Human Evaluation의 부담을 경감하는 데 기여할 것입니다. 다만, Style-adversarial Pairs나 Reference-free Natural Prose와 같이 JEV가 Confidently Misled되는 Workload에서는 Confidence Signal의 Validation이 중요함을 강조합니다.
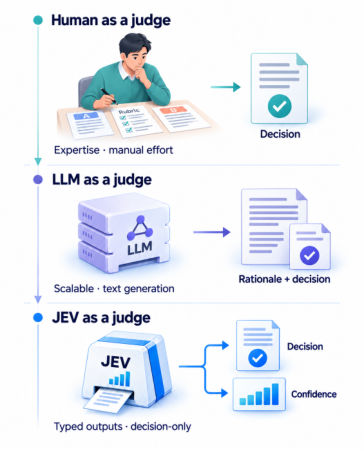
Figure 1 — 판단 진화 다이어그램
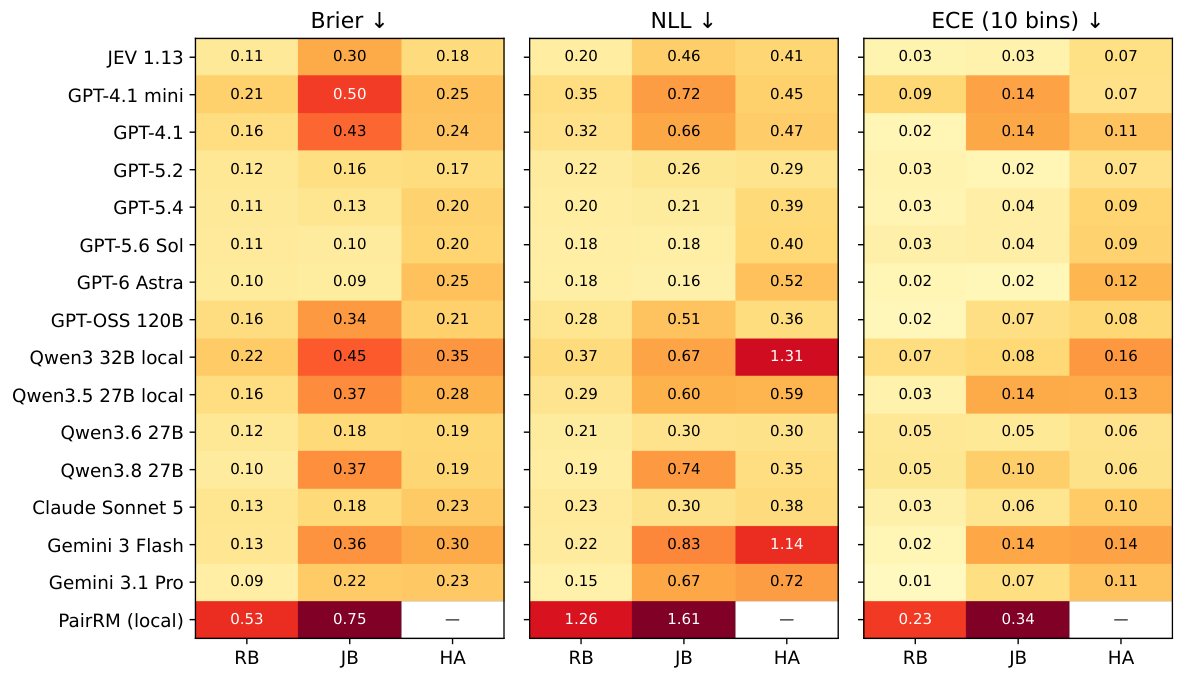
Figure 3 — 확률 품질 지표
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] VākQA: A Benchmark and Evaluation Study for Telugu Spoken Factoid Question Answering
- [논문리뷰] Scaling Large Reasoning Models beyond Human Supervision: A Path toward Superintelligence
- [논문리뷰] Prior Audit-Repair Context Shifts LLM Verifier Thresholds Toward Leniency
- [논문리뷰] OSReward: Instituting Standardized Evaluation for Cross-Platform Computer-Use Reward Models
- [논문리뷰] RefCaptioner: Multi-Reference Image-Grounded Video Captioning
Review 의 다른글
- 이전글 [논문리뷰] ImIR: Image-Instruction Tuning for All-in-One Image Restoration
- 현재글 : [논문리뷰] JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
- 다음글 [논문리뷰] LatentPort: Beyond KV Cache - Cross-Model Transfer of Recurrent Memory in Hybrid Language Models: A 4B-to-9B Hybrid-State Handoff Without Target Prefix Replay
댓글