[논문리뷰] ImIR: Image-Instruction Tuning for All-in-One Image Restoration
링크: 논문 PDF로 바로 열기
저자: Süleyman Aslan, Görkay Aydemir, Mısra Yavuz, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- ImIR (Image-Instructed Restoration): 본 논문에서 제안하는 방법론으로, 이미지에서 직접 추출한 instruction을 사용하여 다양한 이미지 degradation을 복원하는 all-in-one image restoration 시스템입니다.
- All-in-One Image Restoration: 단일 모델이 여러 종류의 이미지 degradation (예: 저조도, 비, 안개, 블러, 노이즈, JPEG 압축)을 동시에 처리하여 clean image를 복구하는 task입니다.
- Image-Instruction Tuning: 텍스트 프롬프트 대신 degraded image 자체에서 vision-language embedding을 추출하여 restoration model의 instruction으로 사용하는 fine-tuning 접근 방식입니다.
- Qwen-Image-Edit: ImIR의 backbone으로 사용되는 대규모 pretrained image-editing model이며, instruction을 기반으로 이미지 편집 작업을 수행합니다.
- Low-rank Adapter (LoRA): pretrained model의 전체 가중치를 fine-tuning하는 대신, 적은 수의 파라미터를 추가하여 특정 task에 모델을 효율적으로 adapting하는 기법입니다.
- Token Mapper: degraded image의 vision-language embedding을 clean image instruction embedding으로 변환하는 경량 신경망으로, ImIR의 핵심 구성 요소입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 다양한 이미지 degradation에 효과적으로 대응할 수 있는 all-in-one image restoration 시스템의 필요성을 제기합니다. 실제 환경에서는 degradation 유형이 매우 다양하므로, 단일 degradation에 특화된 기존 네트워크들은 높은 품질을 제공하지만, degradation 유형마다 별도의 모델을 학습, 저장, 선택해야 하는 비실용적인 한계를 가집니다. 기존 all-in-one 방법들은 task 간 간섭 문제를 겪거나, 복원할 degradation을 명확히 모델에 지시하는 데 어려움이 있었습니다. 특히, CLIP이나 자연어 프롬프트를 활용한 텍스트 기반 conditioning은 프롬프트 엔지니어링이 필요하고, task vocabulary가 고정되며, 개별 이미지의 미묘한 특성에 맞게 tuning하기 어렵다는 한계가 있었습니다. 이러한 문제를 해결하기 위해, 저자들은 텍스트에 비해 훨씬 유연하고 이미지 자체의 context를 반영하는 image-derived instruction을 기반으로 하는 새로운 접근 방식의 필요성을 강조합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Qwen-Image-Edit 모델을 활용하여 all-in-one image restoration을 image-derived instruction에 의해 guided되는 editing task로 재해석하는 ImIR을 제안합니다. ImIR은 frozen된 Qwen-Image-Edit backbone에 단일 low-rank adapter를 모든 task에 걸쳐 공유하여 적용합니다. 핵심은 degraded image y의 vision-language embedding을 clean image instruction embedding êx로 변환하는 경량의 Token Mapper입니다. 이 Token Mapper는 masked mean-pool, FiLM generator φagg, 그리고 per-token network go로 구성되며, instruction을 생성합니다 [Figure 2]. ImIR의 instruction은 continuous vector이므로, 스케일링 파라미터 s를 통해 degraded-to-clean 방향으로 출력을 조절할 수 있어, low-light enhancement와 같이 고유한 target이 없는 task에 대해 조절 가능한 restoration을 가능하게 합니다 [Figure 4].
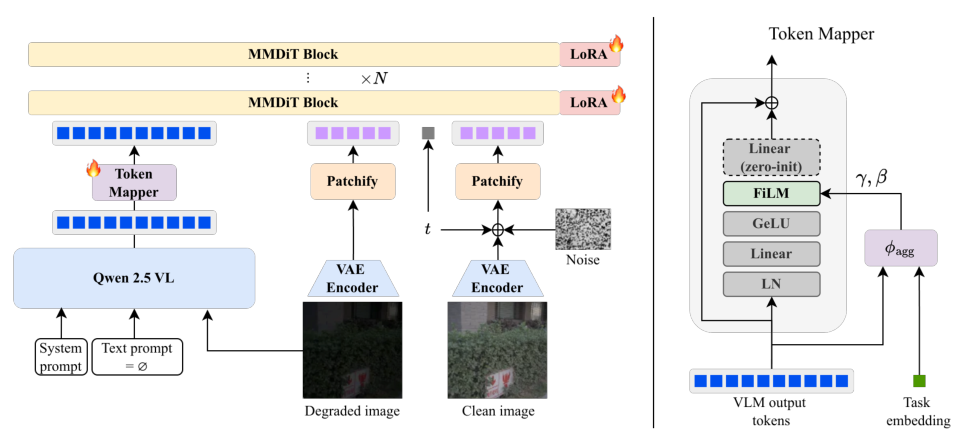
Figure 2 — 제안하는 ImIR 모델의 전체 아키텍처와 데이터 흐름을 보여주는 핵심 다이어그램
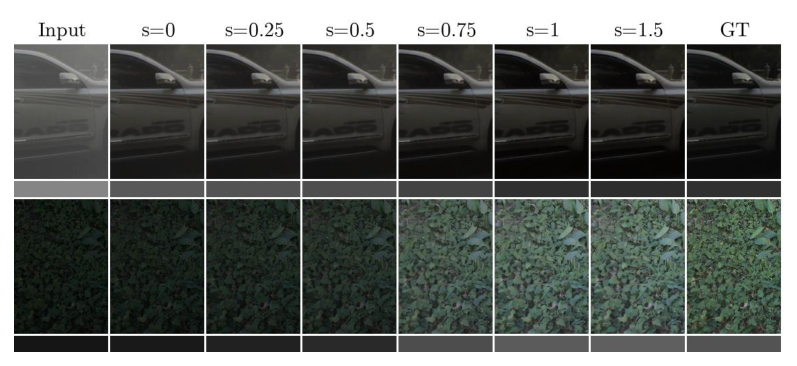
Figure 4 — ImIR의 instruction scaling을 통한 controllable restoration 능력을 저조도 및 dehazing task에서 시각적으로 보여주는 그림
실험 결과, ImIR은 pretrained prior를 기반으로 하거나 적은 데이터로 학습하는 방법들 중 모든 task에서 가장 높은 PSNR을 달성했습니다 [Table 1]. 예를 들어, dehazing task에서 untuned editor인 Qwen-Image-Edit-2511 대비 7.0 dB (17.7 dB에서 24.7 dB로) 향상되었으며, Edit2Restore 대비 low-light task에서 2.7 dB (18.6 dB에서 21.3 dB로) 높은 성능을 보였습니다. 특히, image instruction은 동일한 backbone 상에서 텍스트 기반 conditioning (Text LoRA)보다 모든 6가지 task에서 우수한 성능을 나타냈으며, low-light task에서 5.0 dB (16.3 dB에서 21.3 dB로)의 가장 큰 PSNR 격차를 보였습니다 [Table 1]. 또한, task-agnostic ImIR은 degradation label 없이도 task-aware 모델과 유사한 성능을 유지하여 (low-light에서 21.2 dB vs 21.3 dB), 텍스트 프롬프트 기반의 task-agnostic 방법들이 실패하는 것과 대조를 이뤘습니다 [Table 1]. Mapper ablation 연구를 통해, ImIR의 Token Mapper는 identity baseline 대비 2.6 dB에서 7.0 dB까지 성능을 향상시키는 것으로 확인되었습니다 [Table 3].
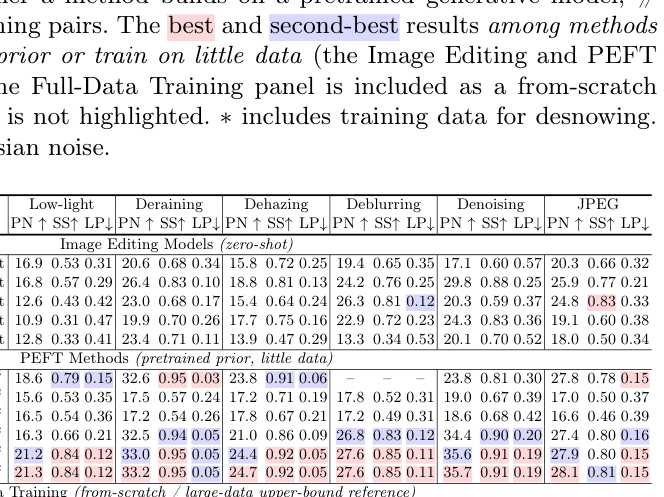
Table 1 — 6가지 이미지 복원 task에 대한 ImIR과 다양한 baseline 모델들의 PSNR, SSIM, LPIPS 정량적 성능을 비교하는 핵심 테이블
4. Conclusion & Impact (결론 및 시사점)
본 논문은 all-in-one image restoration을 위한 파라미터 효율적인 접근 방식인 ImIR을 성공적으로 제시했습니다. ImIR은 pretrained image-editing model에 단일 low-rank adapter와 image-derived instruction을 사용하여 다양한 degradation을 복원합니다. 특히, 텍스트 프롬프트 없이 degraded image 자체에서 clean image instruction embedding을 예측하는 Token Mapper를 통해 training과 inference 시 동일한 conditioning을 구현했습니다.
이 연구는 이미지 복원 분야에 다음과 같은 중요한 시사점을 제공합니다. 첫째, image-derived instruction이 텍스트 프롬프트 기반 conditioning보다 이미지 복원 task에서 뛰어난 성능을 보임을 입증했습니다. 둘째, instruction의 continuous vector 특성을 활용하여 low-light enhancement와 같이 target이 고유하게 정의되지 않는 task에서 controllable restoration을 가능하게 합니다. 셋째, degradation label 없이도 작동하는 task-agnostic 모델을 성공적으로 구현하여, 실제 적용 시 편의성을 크게 향상시켰습니다. 마지막으로, 적은 양의 데이터와 짧은 학습 시간 (단일 GPU에서 약 3시간)으로도 강력한 성능을 달성하여, 대규모 pretrained image-editing 모델을 low-level vision task에 효율적으로 적용하는 새로운 방향을 제시합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] ZooWork-ShopRanker: An Open, Preference-Aligned E-Commerce Reranker
- [논문리뷰] VLA-Precision: Asymmetric Co-Bootstrapping for Efficient Real-World Online RL of Vision-Language-Action Models
- [논문리뷰] TrackEverything: Long Horizon Dense Tracking via De-Duplicating 3D Scene Representations
- [논문리뷰] Tactile-JEPA: Topology-Aware Self-Supervised Representation Learning for Distributed Tactile Sensors
Review 의 다른글
- 이전글 [논문리뷰] Geometric and Semantic Coupling for Interaction Understanding in 3D Scenes
- 현재글 : [논문리뷰] ImIR: Image-Instruction Tuning for All-in-One Image Restoration
- 다음글 [논문리뷰] JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
댓글