[논문리뷰] TeleAntiFraud 2.0: A Refreshable, Profile-Grounded, and Audio-Based Benchmark for Telecom Fraud Detection
링크: 논문 PDF로 바로 열기
저자: Huiyuan Liu, Zhiming Ma, Yanxing Liu, Shun Zhang, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Mixed-Tree Anti-Fraud Generation Pipeline: 사기 사례 요약을 프로필 기반의 구조화된 다이얼로그 트리로 확장하고, 사기(Fraud) 및 비사기(Non-fraud) 경로를 생성하는 데이터셋 구축 파이프라인입니다.
- Near-Domain Calls: 사기 통화와 유사한 맥락, 대화 초입부, 위험 키워드를 공유하지만 최종적으로는 합법적인 서비스 통화로 종료되는 대조군(Sibling) 통화입니다.
- Frozen Snapshot: 매달 생성되는 변경 불가능한 벤치마크 데이터 세트로, 연구의 재현성과 시간에 따른 사기 패턴 변화 추적을 위해 도입된 버전 관리 단위입니다.
- Collapse-aware Reporting: 모델이 특정 라벨(주로 Fraud)로만 예측하거나 사전 확률(Class-prior)에 의존하여 붕괴하는 현상을 다각도로 평가하는 보고 방식입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 끊임없이 진화하는 통신 사기(Telecom Fraud) 위협에 대응하기 위한 평가 체계의 한계를 해결하고자 합니다. 기존의 고정된 테스트셋은 새로운 사기 패턴을 반영하지 못하며, 사기 통화와 완전히 다른 주제의 부정 샘플을 사용할 경우 모델이 문맥 파악 대신 표면적인 키워드만으로 사기를 판별하는 'Short-cut' 문제에 빠지기 쉽습니다. 이러한 한계로 인해, 사기와 실질적으로 구분이 어려운 합법적 통화를 변별하는 성능을 측정하는 데 어려움이 있습니다. 본 연구는 사기 패턴을 지속적으로 수용하면서도 이전 평가의 재현성을 보장하는 리프레시 가능한 벤치마크 체계를 구축하는 것을 목표로 합니다 [Figure 1].
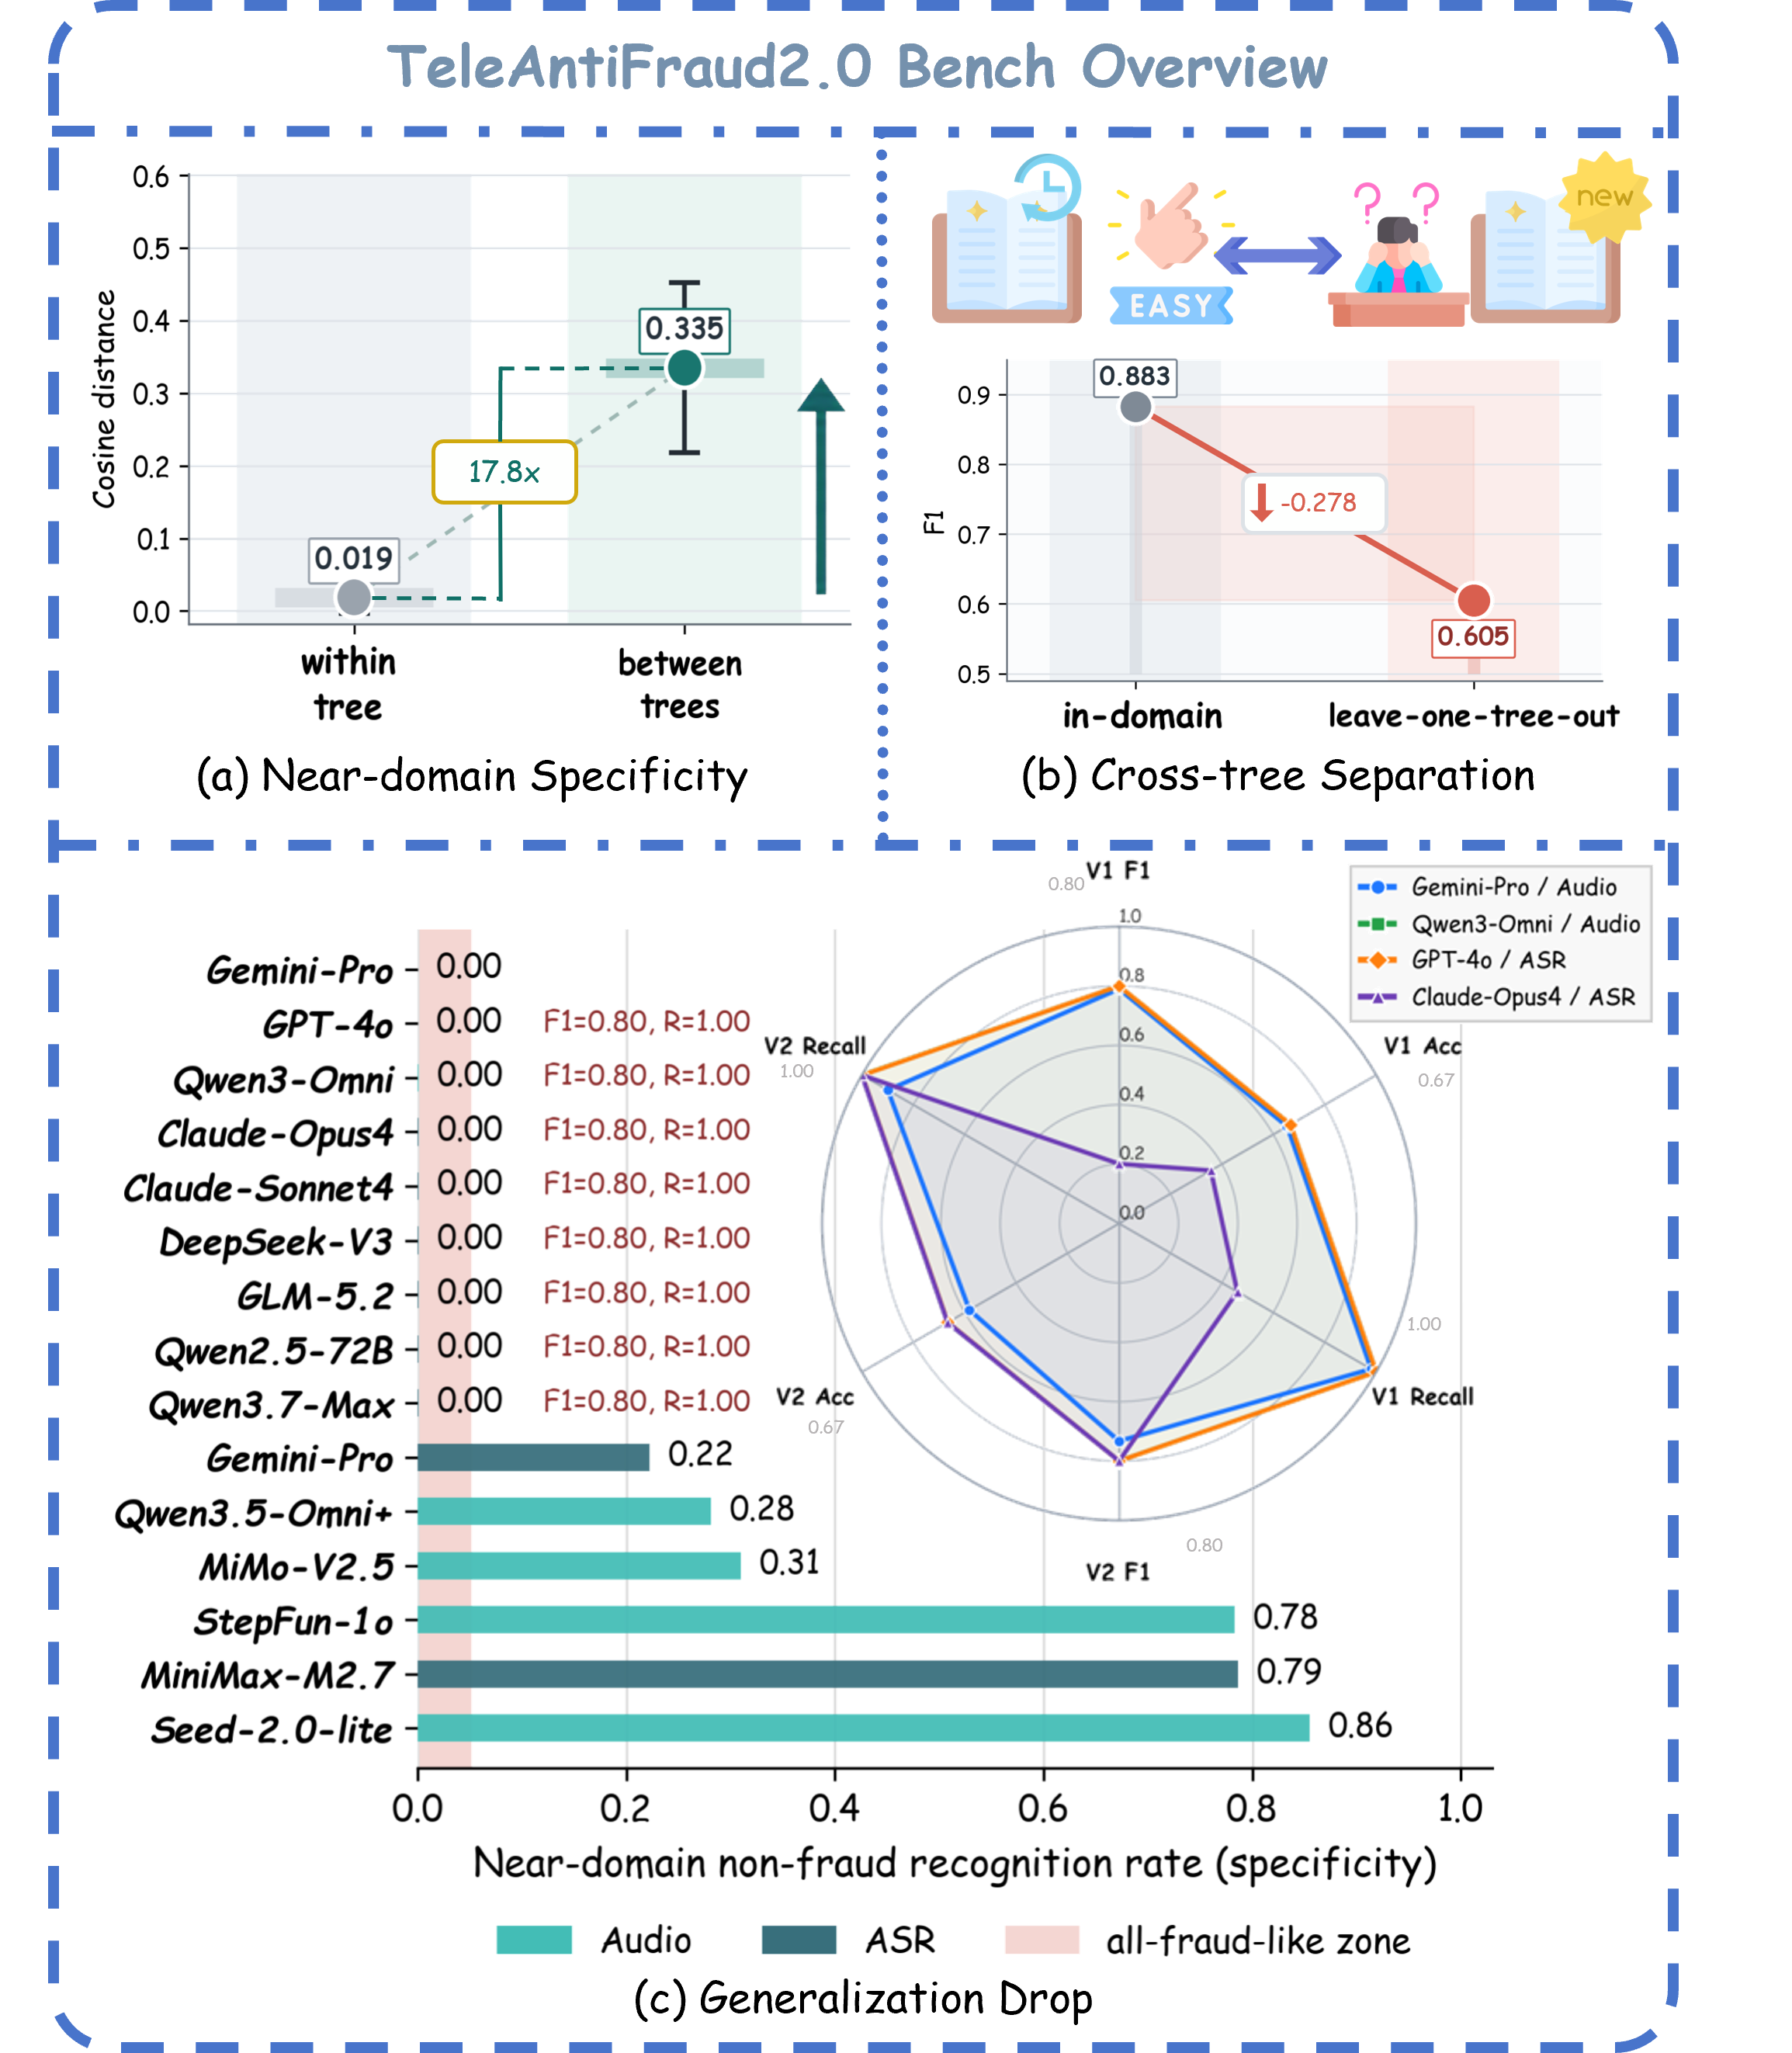
Figure 1 — 벤치마크 구조 및 진단 개요
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 Mixed-Tree Anti-Fraud Generation Pipeline을 제안하여, 동일한 시나리오 컨텍스트에서 분기되는 사기 및 비사기 sibling 경로를 생성합니다. 이 파이프라인은 6개의 전문 에이전트(역할 연기 및 기능 제어)를 사용하여 대화의 구조를 설계하고, 사기 판별 행동이 나타나는 시점에 라벨을 결정합니다 [Figure 2, Figure 3]. 이를 통해 사기와 유사한 Near-domain 합법 통화를 포함하는 총 900개의 통화(사기 600개, 비사기 300개)로 구성된 매달 업데이트되는 Frozen Snapshot을 생성합니다. 실험 결과, 기존의 일반적인 부정 샘플 사용 시 Macro-F1 1.0에 도달하던 분류기들이 Near-domain sibling 데이터셋에서는 0.65~0.68로 성능이 급락함을 확인하였습니다 [Table 4]. 또한, 다수의 대형 모델이 특정 클래스로만 답변하는 Prediction Collapse 현상을 보였으며, 이는 사기 F1 점수만으로는 모델의 실제 변별력을 판단할 수 없음을 시사합니다.
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 TeleAntiFraud 2.0을 통해 통신 사기 탐지 모델 평가의 새로운 표준을 제시하였습니다. 제안된 프레임워크는 벤치마크의 리프레시 기능과 불변성(Immutability)을 동시에 확보하여, 빠르게 진화하는 사기 전술에 효과적으로 대응할 수 있게 합니다. 이 연구는 단순히 높은 정량적 수치를 추구하는 것을 넘어, 모델의 붕괴(Collapse)와 오탐지(False-positive) 경향성을 분석하는 'Collapse-aware' 평가의 중요성을 강조합니다. 향후 학계와 산업계에서 보다 신뢰성 있는 오디오 기반 사기 탐지 모델을 개발하고 평가하는 데 핵심적인 지침이 될 것입니다.
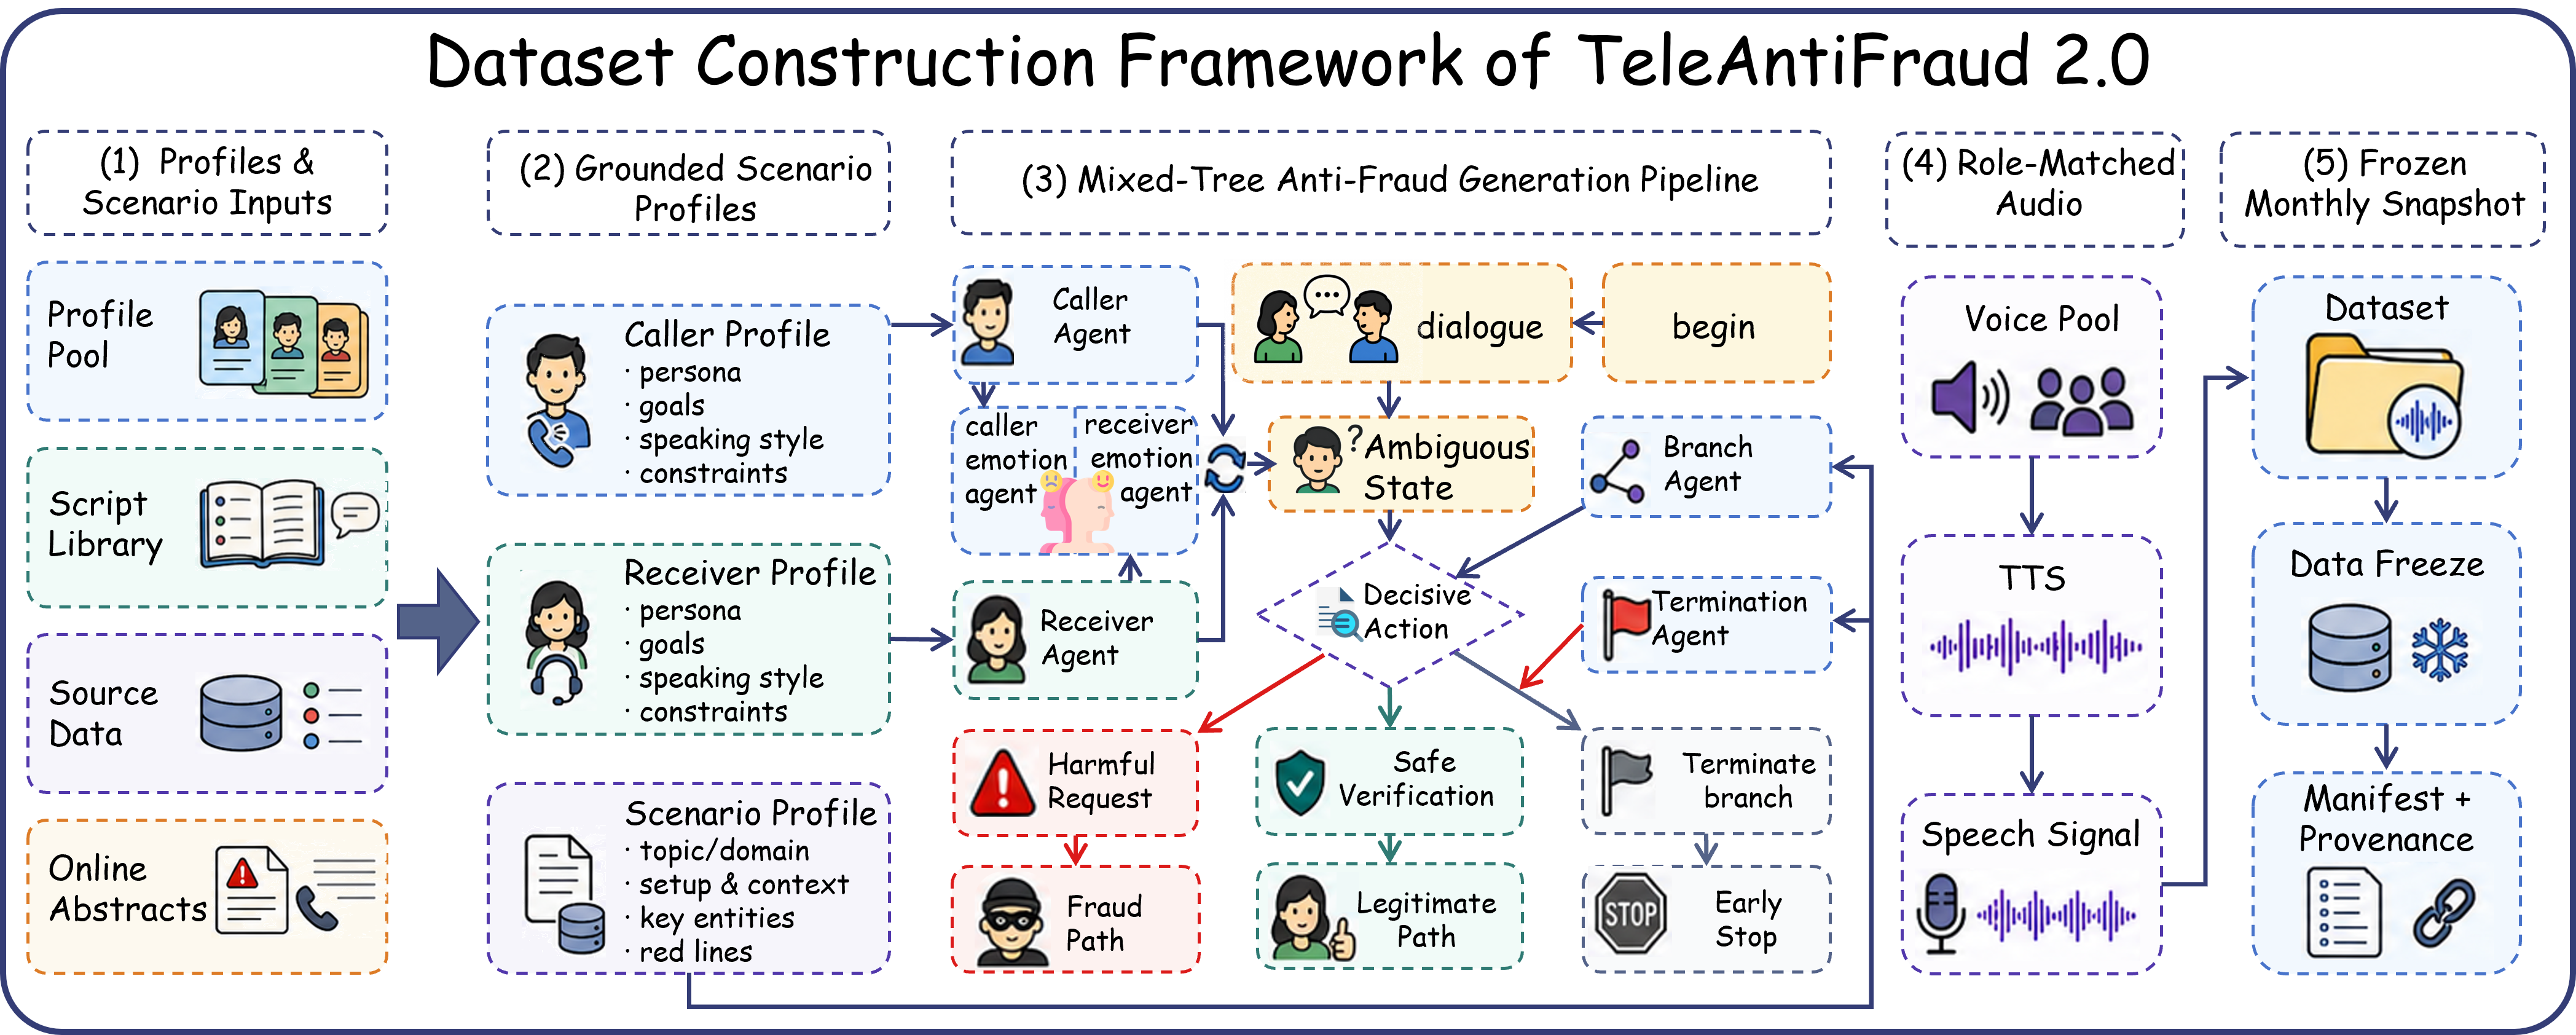
Figure 2 — 시스템 전체 데이터 흐름도
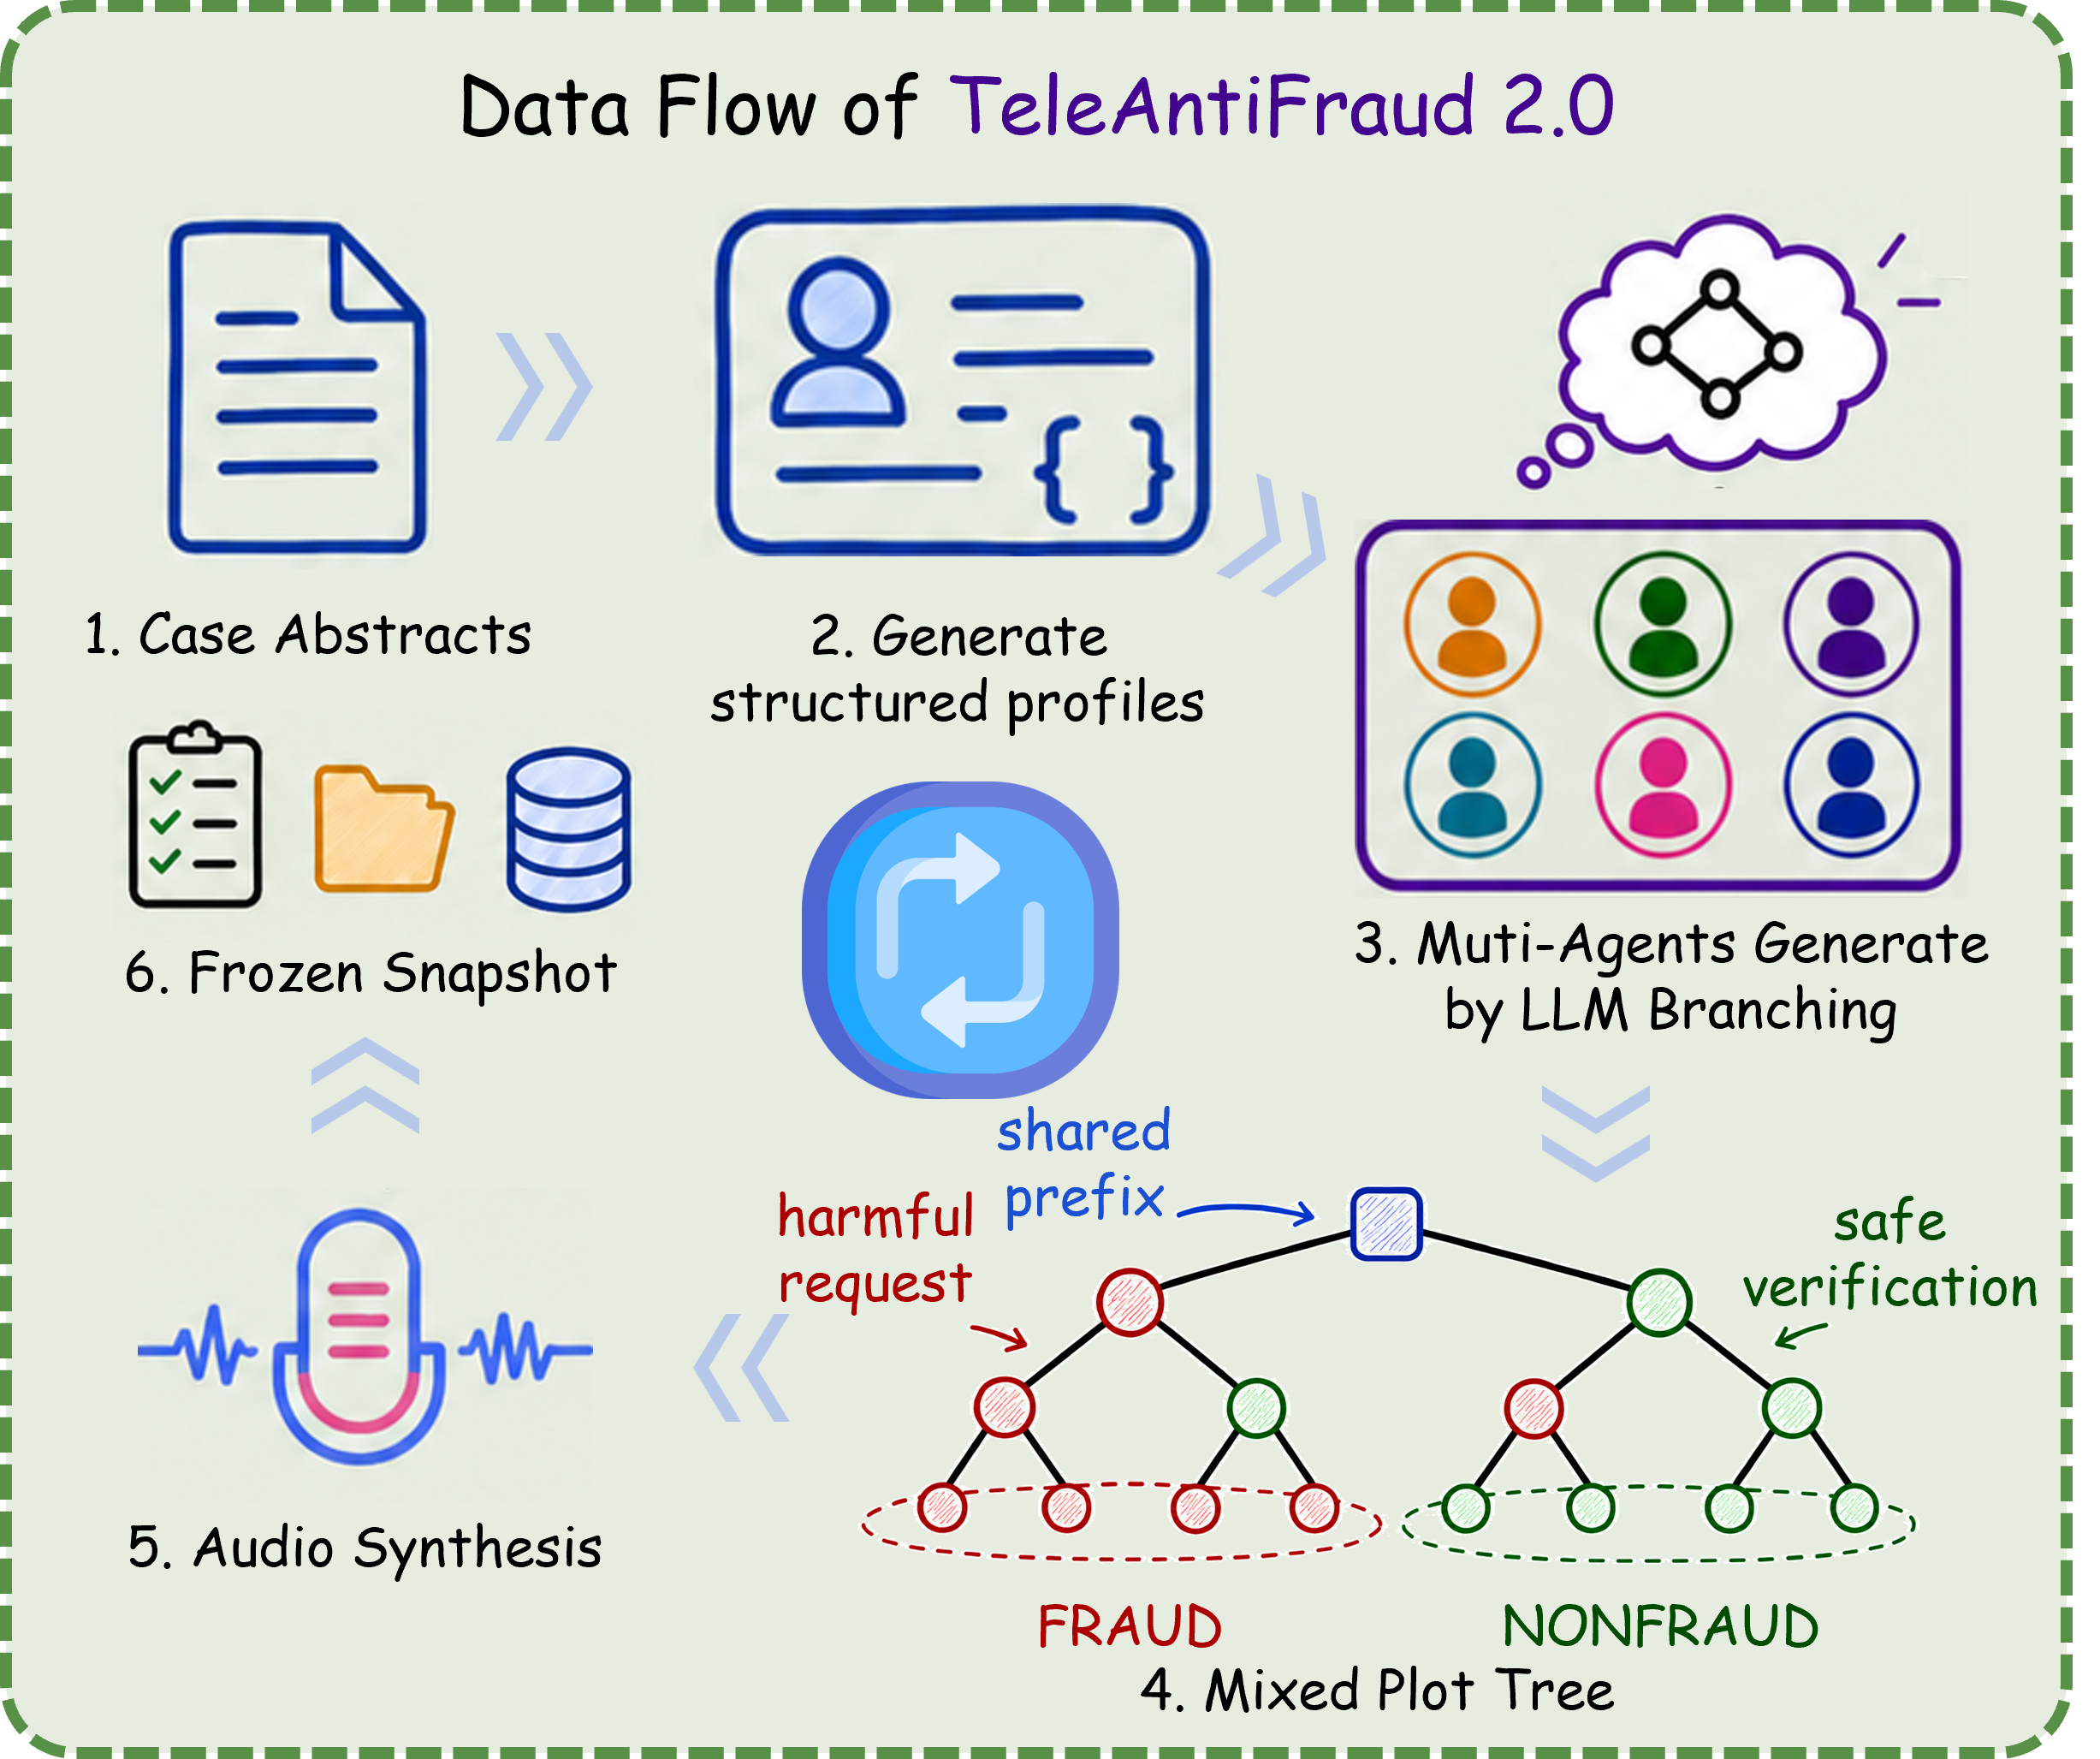
Figure 3 — 데이터 생성 파이프라인 상세
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] When AI Reviews Train AI Reviewers: Scientific-Judgment Collapse and Mitigation
- [논문리뷰] ChildVox: A Speech, Audio, and Large Audio-Language Model Benchmark in Understanding and Characterizing Sound across Childhood
- [논문리뷰] Tadabur: A Large-Scale Quran Audio Dataset
- [논문리뷰] How Far Can Unsupervised RLVR Scale LLM Training?
- [논문리뷰] EpiCaR: Knowing What You Don't Know Matters for Better Reasoning in LLMs
Review 의 다른글
- 이전글 [논문리뷰] SiliconBench: Speed, Memory, and Fidelity for LLM Serving on Unified-Memory Desktops
- 현재글 : [논문리뷰] TeleAntiFraud 2.0: A Refreshable, Profile-Grounded, and Audio-Based Benchmark for Telecom Fraud Detection
- 다음글 [논문리뷰] Training-Adaptive Convolutional Sparse Coding via Information Bottleneck for Robust Visual Representation
댓글