[논문리뷰] Realtime-Venus: A full-duplex interaction system with asynchronous delegation
링크: 논문 PDF로 바로 열기
저자: Ruixiang Zhao, Hualei Wang, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Realtime-Venus: 오디오-시각적 상호작용을 위한 Realtime-Venus-Omni와 음성 전용 상호작용을 위한 Realtime-Venus-Audio로 구성된 proactive full-duplex 상호작용 시스템입니다.
- Realtime-Venus-Harness: 프런트엔드와 분리되어 비동기적(asynchronous)으로 복잡한 태스크를 수행하고 결과를 통합하는 공유 실행 프레임워크입니다.
- Full-Duplex: 사용자의 입력(오디오/비디오)과 어시스턴트의 응답(음성/텍스트)이 실시간으로 동시에 처리되는 상호작용 방식입니다.
- Asynchronous Delegation: 대화의 흐름을 방해하지 않고 복잡한 외부 능력(tool call 등)을 백그라운드에서 실행한 뒤, 추후 적절한 시점에 대화로 통합하는 메커니즘입니다.
- Omni-Flow: MiniCPM-o 4.5에서 계승된 아키텍처로, 입력 스트림과 출력 토큰을 공유 타임라인에서 정렬하여 연속적인 상호작용을 가능하게 합니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 실시간 상호작용 환경에서 연속적인 인식(perception)과 즉각적인 응답 사이의 균형을 맞추는 동시에, 복잡한 외부 도구 사용과 대화의 일관성을 유지하는 문제를 해결하고자 합니다. 기존의 모델들은 응답 생성 도중 사용자의 개입(interruptions)이나 중단 상황을 처리할 때 대화의 맥락이 끊기거나 외부 도구 실행 중 지연이 발생하는 한계가 있습니다. 특히 고도화된 음성 어시스턴트가 실시간 대화와 복잡한 비동기 작업을 동시에 처리하기 위해서는, 시스템의 즉각적인 반응성(latency-sensitivity)과 장기적인 작업 수행(long-running computation)을 조화시키는 구조가 필수적입니다. [Figure 3]은 이러한 문제를 극복하기 위해 제안된 이중 루프(dual-loop) 구조를 보여줍니다.
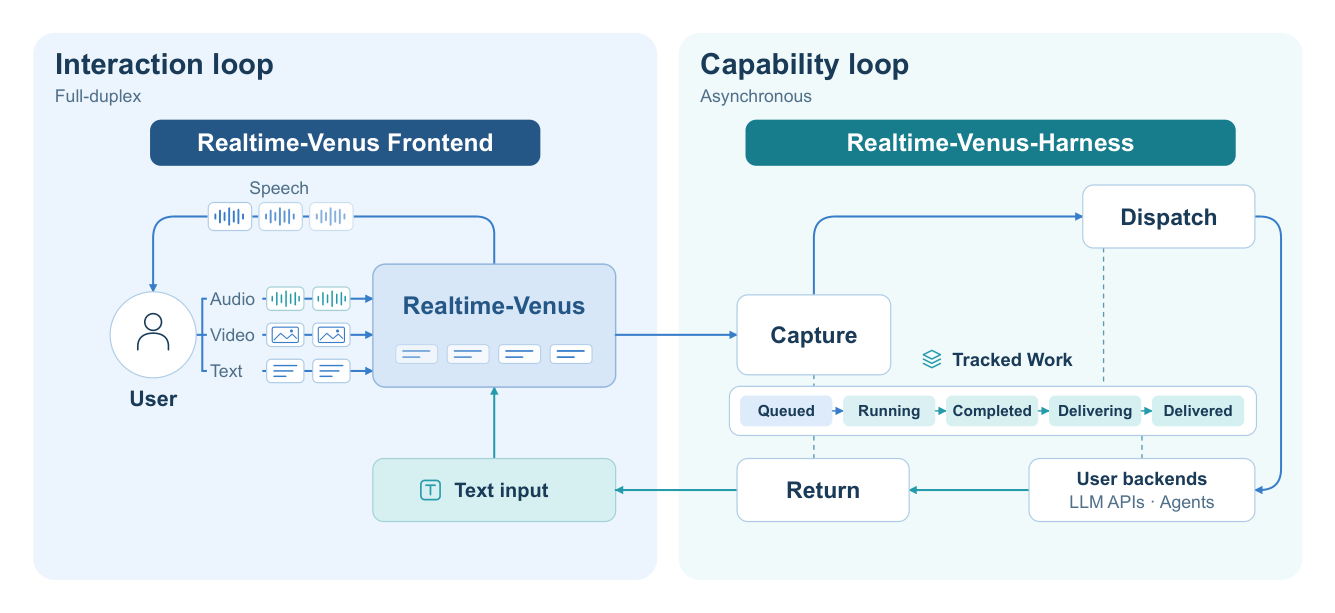
Figure 3 — 비동기적 위임 시스템과 프런트엔드의 결합을 보여주는 핵심 아키텍처 다이어그램
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 고성능의 9B 파라미터 모델을 기반으로 한 프런트엔드와 이를 보조하는 Realtime-Venus-Harness를 결합한 통합 시스템을 제안합니다. 제안된 시스템은 공유된 인과 타임라인(causal timeline)상에서 대화 상태와 외부 위임 작업을 동기화하며, 프런트엔드는 사용자와 실시간 상호작용을 담당하고, 하니스는 백그라운드에서 작업을 처리합니다. 핵심 실험 결과, Realtime-Venus-Omni는 StreamingBench에서 70.2%, Daily-Omni에서 81.3%의 정확도를 기록하며 동급 온라인 모델 중 최상위권 성능을 보였습니다. 또한, Realtime-Venus-Audio는 MMAU에서 78.0%, MMAU-Pro에서 63.2%, Llama Questions에서 83.8%의 정확도를 기록하며 오디오 이해 및 응답 생성 분야에서 우수한 성능을 입증했습니다. [Table 6]에 나타난 바와 같이, 특히 full-duplex 인터랙션 상황에서 이전 대화 흐름을 유지하는 continuation rate가 Gemini 3.1 Live 및 GPT-4o를 상회하는 결과를 보였습니다.
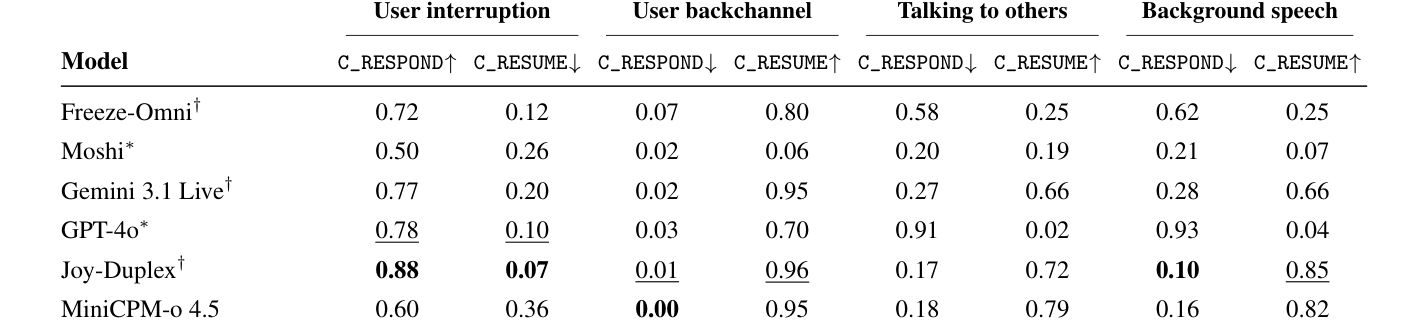
Table 6 — full-duplex 성능을 입증하는 주요 지표 비교 테이블
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 대화의 연속성을 저해하지 않으면서도 외부 도구 호출과 비동기적 추론을 가능하게 하는 proactive full-duplex 상호작용 시스템의 새로운 프레임워크를 정립하였습니다. 제안된 Realtime-Venus는 사용자의 개입에 유연하게 대응하면서도 장시간의 비디오 이해 및 복잡한 작업 수행 능력을 동시에 갖추고 있습니다. 이 연구는 음성 대화 모델이 단순한 챗봇을 넘어 실세계의 동적 환경에서 보다 지능적이고 실질적인 보조자로 진화하는 데 중요한 기틀을 마련할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
- 현재글 : [논문리뷰] Realtime-Venus: A full-duplex interaction system with asynchronous delegation
- 다음글 [논문리뷰] Streaming Video Editing with Easy Adaptation
댓글